초당 10만 건 인게임 텔레메트리 수집: Kafka와 ClickHouse 기반 실시간 로그 파이프라인 구축 가이드
초당 10만 건(100k EPS) 이상의 대규모 인게임 텔레메트리 로그를 지연 없이 안정적으로 수집·저장하는 Apache Kafka와 ClickHouse 연동 아키텍처 및 성능 최적화 가이드입니다.
핵심 요약
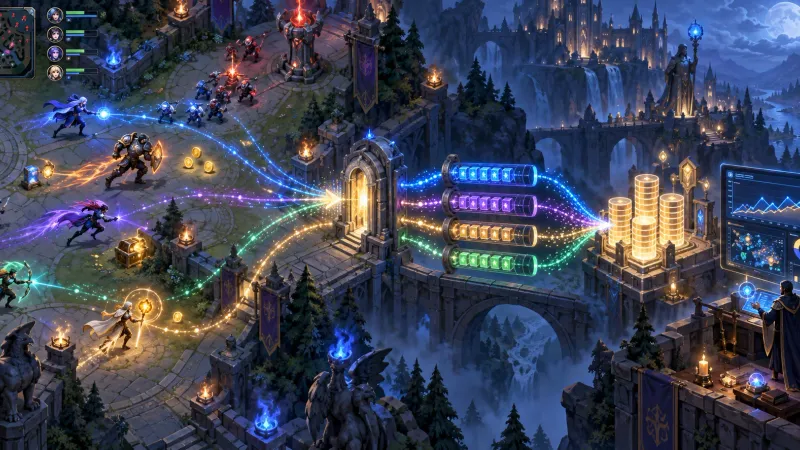
- 핵심 과제: 동시 접속자가 몰리는 라이브 게임 환경에서 발생하는 초당 10만 건(100k EPS) 이상의 인게임 텔레메트리(전투 로그, 동선, 경제 흐름 등)를 유실 없이 실시간으로 적재하고 분석해야 합니다.
- 핵심 원리: 고성능 분산 큐 Apache Kafka로 트래픽 스파이크를 흡수(Buffering)하고 파티셔닝한 뒤 초고속 컬럼 지향 DBMS인 ClickHouse의
MergeTree엔진과 배치 인서트(Batch Insert) 구조를 결합해 쓰기 병목을 제거합니다. - 도입 효과: RDBMS나 Elasticsearch 대비 80% 이상의 스토리지 비용 절감, 500ms 미만의 엔드투엔드 수집 지연 시간, 수십억 건 로그에 대한 1초 미만의 집계 쿼리 성능을 달성할 수 있습니다.
왜 전통적인 RDBMS나 ELK 스택으로는 100k EPS를 감당하기 어려운가?
대규모 멀티플레이어 게임에서 유저들의 초 단위 행동(스킬 사용, 피격, 좌표 이동, 재화 획득 등)을 기록하면 데이터 발생량은 초당 수만에서 수십만 건으로 폭증합니다. 이 규모의 트래픽을 처리할 때 기존 인프라는 명확한 한계에 부딪힙니다.
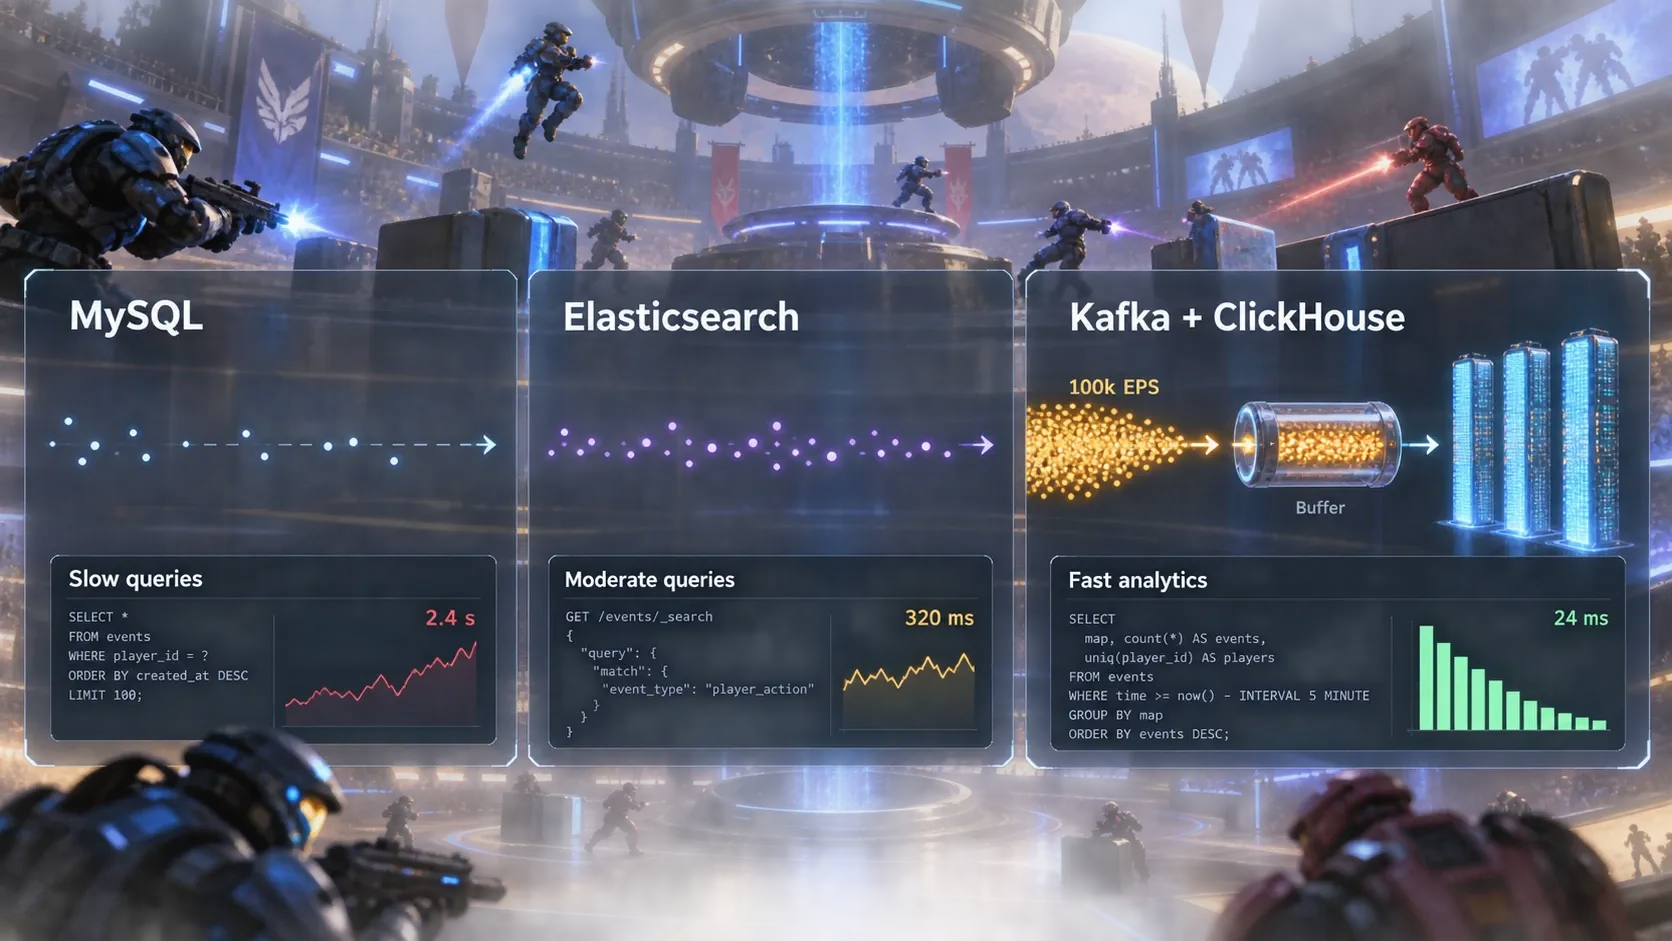
- RDBMS (MySQL, PostgreSQL 등): 행(Row) 단위 쓰기 구조와 B-Tree 인덱스 갱신 오버헤드로 인해 초당 수천 건 이상의 동시 쓰기에서 디스크 I/O 병목이 발생합니다. 샤딩(Sharding)을 적용하더라도 인프라 유지 비용과 스키마 관리 복잡도가 급격히 상승합니다.
- ELK 스택 (Elasticsearch): 텍스트 검색에는 탁월하지만 모든 필드에 역색인(Inverted Index)을 생성하므로 쓰기 리소스 소모가 큽니다. 100k EPS 환경에서는 JVM Garbage Collection(GC) 멈춤 현상과 노드 스토리지 부족이 빈번히 발생합니다.
| 비교 항목 | RDBMS (MySQL) | Elasticsearch | Kafka + ClickHouse |
|---|---|---|---|
| 저장 방식 | 행 기반 (Row-oriented) | 역색인 문서 기반 (Document) | 컬럼 기반 (Column-oriented) |
| 쓰기 처리량 | 수천 EPS (샤딩 없이 한계) | 2만~4만 EPS (고비용 노드 필요) | 10만~100만+ EPS (수평 확장 용이) |
| 데이터 압축률 | 보통 (20%~40%) | 낮음~보통 (역색인 오버헤드) | 매우 높음 (70%~90%, LZ4/ZSTD) |
| 대규모 집계 속도 | 느림 (Full Table Scan 시 I/O 병목) | 중간 (집계 시 메모리 소모 큼) | 초고속 (벡터화 쿼리 실행 엔진) |
| 인프라 비용 | 높음 | 매우 높음 | 낮음 (동일 성능 대비 서버 대수 최소화) |
100k EPS 텔레메트리 파이프라인 전체 아키텍처는 어떻게 구성되는가?
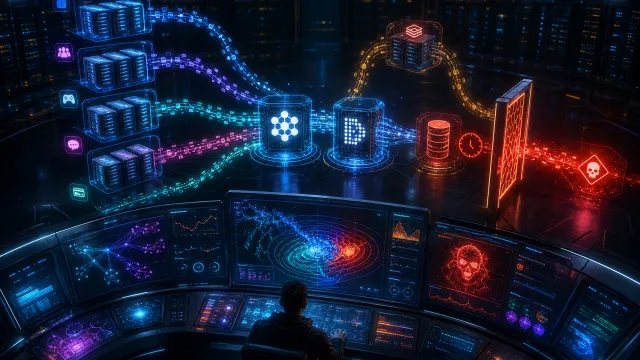
안정적인 10만 EPS 수집을 위해서는 클라이언트 및 게임 서버의 비동기 전송 -> 인제스천 게이트웨이 -> Kafka 버퍼링 -> ClickHouse 배치 적재 -> 분석/대시보드의 5단계 파이프라인 구조를 확립해야 합니다.
flowchart LR
    subgraph Sources["데이터 발생처"]
        GS["게임 서버 클러스터"]
        GC["게임 클라이언트"]
    end

    subgraph Ingestion["수집 레이어"]
        GW["Ingestion Gateway<br/>(Go / Rust / Envoy)"]
    end

    subgraph Buffering["메시지 큐"]
        KF["Apache Kafka<br/>(Partitioned Topics)"]
    end

    subgraph Storage["분석 스토리지"]
        MV["Materialized View"]
        CH["ClickHouse<br/>(MergeTree Engine)"]
    end

    subgraph Analytics["분석 & 시각화"]
        GF["Grafana / BI Dashboard"]
        ML["이상 탐지 & 치트 분석"]
    end

    GS -->|gRPC / HTTP/2| GW
    GC -->|HTTPS / Batched| GW
    GW -->|Producer Batch| KF
    KF -->|Kafka Engine Table| MV
    MV -->|Async Batch Insert| CH
    CH --> GF
CH --> ML- Ingestion Gateway: 게임 클라이언트와 서버로부터 전송된 패킷을 검증하고 스키마 유효성을 체크한 뒤 Kafka 프로듀서로 전달합니다.
- Apache Kafka: 트래픽 피크 시 발생하는 데이터 충격을 흡수하며 파티션 분기를 통해 수평 확장을 보장합니다.
- ClickHouse: Kafka Engine 테이블과 Materialized View를 활용해 데이터를 배치(Batch)로 흡수하고 컬럼 단위로 압축 적재합니다.
초당 10만 건 처리를 위한 단계별 구축 가이드
Step 1: Kafka 토픽 설계 및 프로듀서 최적화
초당 10만 건을 단일 파티션으로 처리할 수 없으므로 파티션 분산 전략이 필수적입니다. 필요 파티션 수는 다음 수식을 통해 산정합니다.
단일 컨슈머 스레드가 초당 10,000건을 안정적으로 처리한다면 최소 10개 이상의 파티션이 필요하며 버퍼를 고려해 16~32개 파티션을 권장합니다.
프로듀서(게임 서버 또는 게이트웨이)에서는 개별 로그마다 네트워크 요청을 보내지 않고 메모리 버퍼를 활용한 마이크로 배치(Micro-batch) 전송을 구성합니다.
Ingestion Gateway Kafka Producer 핵심 설정:
{
  "acks": "1",
  "compression.type": "lz4",
  "batch.size": 65536,
  "linger.ms": 20,
  "max.in.flight.requests.per.connection": 5,
  "buffer.memory": 67108864
}
linger.ms: 20: 메시지가 들어오더라도 최대 20ms 동안 대기하며 배치를 채웁니다.compression.type: lz4: CPU 오버헤드가 적으면서도 높은 압축률을 제공하여 네트워크 대역폭을 절감합니다.acks: 1: 텔레메트리 데이터 특성상 리더 브로커 수신 확인만으로 지연 시간을 최소화합니다.
Step 2: ClickHouse 테이블 스키마와 인덱싱 설계
ClickHouse에서 초고속 압축과 쿼리 성능을 끌어내기 위해서는 적절한 컬럼 타입과 ORDER BY 키 설계가 필수적입니다.
-- 1. 메인 텔레메트리 저장 테이블 생성
CREATE TABLE game_telemetry.events (
    event_date Date DEFAULT toDate(event_time),
    event_time DateTime64(3, 'UTC') CODEC(DoubleDelta, ZSTD(1)),
    event_name LowCardinality(String),
    server_id LowCardinality(String),
    world_id UInt16,
    user_id UInt64,
    session_id UUID,
    client_ip String CODEC(ZSTD(1)),
    payload_json String CODEC(ZSTD(3))
)
ENGINE = MergeTree()
PARTITION BY toYYYYMM(event_date)
PRIMARY KEY (event_name, event_date)
ORDER BY (event_name, event_date, user_id, event_time)
SETTINGS index_granularity = 8192;LowCardinality(String): 이벤트 명, 서버 ID 등 카디널리티가 낮은 문자열은 사전 인코딩을 통해 메모리와 디스크 사용량을 대폭 줄입니다.DoubleDelta: 균일하게 증가하는 시계열 타임스탬프(event_time) 컬럼에 최적화된 압축 알고리즘입니다.ORDER BY: 자주 필터링되는 조건(event_name,event_date,user_id) 순서로 정렬 키를 구성해 데이터 검색 시 스캔 범위를 최소화합니다.
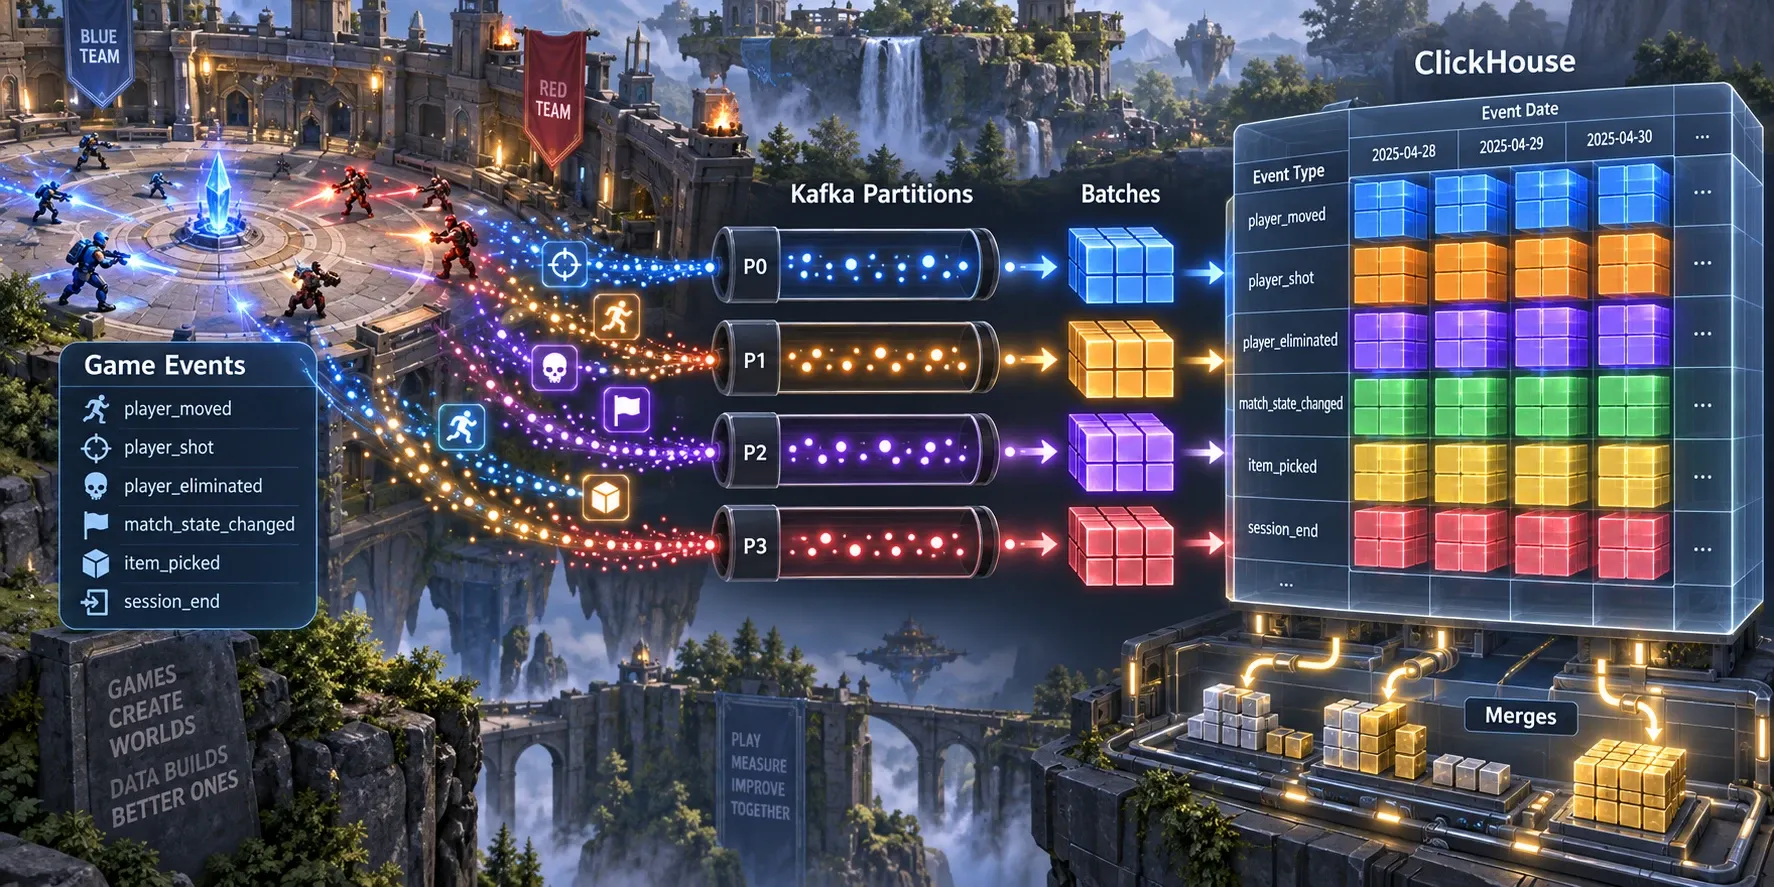
Step 3: Kafka Engine과 Materialized View를 활용한 실시간 스트리밍 적재
ClickHouse 내장 Kafka Engine을 사용하면 별도의 외부 컨슈머 데몬 없이도 Kafka 데이터를 테이블로 파이프라이닝할 수 있습니다.
-- 1. Kafka Queue 테이블 생성 (데이터 소비용)
CREATE TABLE game_telemetry.kafka_events_queue (
    event_time DateTime64(3, 'UTC'),
    event_name String,
    server_id String,
    world_id UInt16,
    user_id UInt64,
    session_id UUID,
    client_ip String,
    payload_json String
)
ENGINE = Kafka
SETTINGS
    kafka_broker_list = 'kafka-broker-1:9092,kafka-broker-2:9092,kafka-broker-3:9092',
    kafka_topic_list = 'game-telemetry-topic',
    kafka_group_name = 'clickhouse-telemetry-group',
    kafka_format = 'JSONEachRow',
    kafka_num_consumers = 4,
    kafka_max_block_size = 65536;

-- 2. Kafka Queue에서 메인 테이블로 전달하는 Materialized View 생성
CREATE MATERIALIZED VIEW game_telemetry.mv_kafka_to_events
TO game_telemetry.events AS
SELECT
    toDate(event_time) AS event_date,
    event_time,
    event_name,
    server_id,
    world_id,
    user_id,
    session_id,
    client_ip,
    payload_json
FROM game_telemetry.kafka_events_queue;
운영 환경에서 ‘Too Many Parts’ 에러를 방지하는 튜닝 기법
ClickHouse 운영 중 가장 빈번하게 마주하는 장애는 Too many parts in all data parts in table 에러입니다. 이는 삽입 빈도가 너무 잦아 백그라운드 병합(Merge) 속도가 삽입 파트(Part) 생성 속도를 따라가지 못할 때 발생합니다.
- 비동기 삽입(Asynchronous Insert) 활성화:
클라이언트에서 직접 삽입하거나 외부 프록시를 거칠 때 ClickHouse 서버 메모리에서 데이터를 묶어서 디스크에 플러시하도록 설정합니다.SET async_insert = 1; SET wait_for_async_insert = 0; SET async_insert_max_data_size = 10485760; -- 10MB SET async_insert_busy_timeout_ms = 200; -- 200ms - 파티션 분할 단위 최소화:
PARTITION BY toYYYYMMDD처럼 일자별로 너무 잘게 쪼개면 파트 수가 기하급수적으로 늘어납니다. 100k EPS 규모에서는 월 단위인PARTITION BY toYYYYMM(event_date)로 파티션을 구성하고 일자 검색은ORDER BY정렬 키로 해결하는 것이 파트 병합 부담을 줄이는 정석입니다.
자주 묻는 질문 (FAQ)
Q1. ClickHouse 내장 Kafka Engine과 Vector/Fluent Bit 같은 외부 컨슈머 중 무엇을 써야 하나요?
초기 구축이나 파이프라인 단순화에는 ClickHouse 내장 Kafka Engine이 유리합니다. 별도의 프로세스 배포 및 관리가 필요 없기 때문입니다. 하지만 복잡한 데이터 정제(Cleansing), 동적 라우팅, 스키마 변환 및 데드 레터 큐(DLQ) 처리가 필요하다면 Vector나 Rust/Go 기반 커스텀 컨슈머를 중간에 배치하는 아키텍처가 장기적인 운영 안정성 면에서 더 우수합니다.
Q2. 수집된 JSON 페이로드를 어떻게 효율적으로 쿼리할 수 있나요?
자주 조회되는 주요 필드는 메인 테이블의 정적 컬럼으로 승격(Extract)시키고 동적으로 변하는 세부 로그는 JSON 타입(실험 기능) 또는 문자열 컬럼에 JSONExtractString(), JSONExtractInt() 함수를 사용합니다. 특정 JSON 키에 대한 조회가 빈번하다면 해당 표현식에 Skip Index (MinMax, Set) 또는 Materialized Column을 추가해 스캔 속도를 최적화할 수 있습니다.
Q3. 파이프라인에서 데이터 유실이 발생할 가능성은 없나요?
Kafka의 acks=all과 ClickHouse의 동기식 파트 쓰기를 조합하면 유실 없는(At-least-once) 파이프라인을 구축할 수 있습니다. 텔레메트리 로그의 경우 약간의 네트워크 스파이크나 재시작 상황에서 중복이 발생할 수 있는데 이는 ClickHouse의 ReplacingMergeTree 엔진을 적용하거나 쿼리 레벨에서 argMax() 함수를 활용해 중복을 자연스럽게 제거할 수 있습니다.
요약
초당 10만 건 이상의 인게임 텔레메트리를 안정적으로 수집·분석하기 위해서는 단일 데이터베이스의 스케일업에 의존하지 않고 Kafka(버퍼링 & 파티셔닝)와 ClickHouse(컬럼 저장 & 배치 병합)를 결합한 분산 데이터 파이프라인을 구축해야 합니다.
적절한 파티션 수 산정, lz4/ZSTD 압축 코덱 적용 그리고 비동기 배치 인서트 전략을 통해 인프라 비용을 최소화하면서도 실시간 밸런스 분석과 이상 탐지를 지원하는 강력한 게임 텔레메트리 백엔드를 완성할 수 있습니다.