AI 기반 분산 서버 패킷 로그 이상 탐지와 어뷰징 IP 자동 격리 구현
Kafka와 ClickHouse로 분산 서버 패킷 로그를 수집하고 Isolation Forest와 규칙 엔진을 결합해 이상 트래픽을 탐지합니다. 오탐을 줄이면서 어뷰징 IP를 자동 격리하는 백엔드 설계를 정리합니다.
핵심 요약
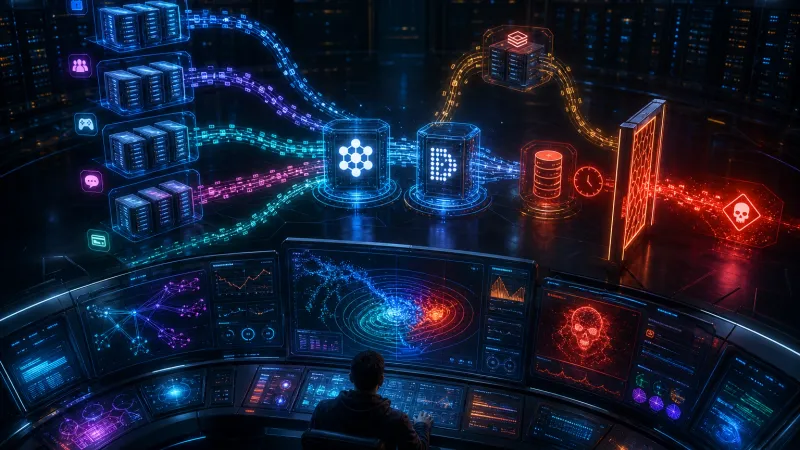
AI 기반 어뷰징 방지는 원본 패킷 전체를 무작정 학습시키는 방식보다 요청 빈도, 실패율, 세션 수, 명령어 분포 같은 메타데이터를 시간 구간별 특징량으로 변환하는 방식이 안전하고 운영하기 쉽습니다. Kafka로 로그를 모으고 ClickHouse에 저장한 뒤 규칙 엔진과 Isolation Forest를 결합하면 비정상 트래픽을 탐지하고 Redis TTL과 방화벽 또는 게이트웨이 정책으로 의심 IP를 단계적으로 격리할 수 있습니다.
중요한 원칙은 AI 점수 하나만으로 즉시 차단하지 않는 것입니다. 모델 점수, 보안 규칙, 계정 위험도, 최근 제재 이력을 함께 평가하고 자동 격리에는 반드시 만료 시간과 해제 절차를 둬야 합니다.
왜 분산 게임 서버의 패킷 로그 이상 탐지가 필요한가?
멀티플레이 게임은 로그인, 매치메이킹, 게임 룸, 채팅, 결제 기능을 서로 다른 인스턴스로 분리해 실행할 수 있습니다. 특정 서버의 로그만 보면 정상처럼 보이는 요청도 전체 세션 관점에서는 비정상일 수 있습니다.
예를 들어 한 IP가 짧은 시간에 여러 리전에 로그인하고 수백 개의 세션을 생성하거나 게임 명령어의 순서를 비정상적으로 반복한다면 다음과 같은 공격 또는 어뷰징 가능성을 의심할 수 있습니다.
- 로그인 및 토큰 검증 API의 무차별 대입
- 게임 룸 생성과 입장을 반복하는 매치메이킹 어뷰징
- 비정상적으로 높은 이동, 공격, 아이템 획득 요청 빈도
- 패킷 재전송을 이용한 중복 보상 획득
- 프록시 또는 봇넷을 이용한 계정 다중 접속
- 특정 서버 인스턴스에 요청을 집중시키는 레이어 7 공격
여기서 말하는 패킷 로그는 일반적으로 전체 페이로드를 뜻하지 않습니다. 개인정보와 게임 비밀값을 보호하기 위해 명령어 이름, 길이, 방향, 결과 코드, 처리 시간, 세션 식별자 해시 같은 관측 가능한 메타데이터를 중심으로 수집합니다.
어떤 로그 필드를 수집해야 하는가?
탐지 품질을 좌우하는 요소 중 하나는 데이터 설계입니다. 여러 서버가 동일한 필드 이름과 시간 기준을 사용하도록 공통 이벤트 스키마를 먼저 정의하는 편이 좋습니다.
| 필드 | 예시 | 용도 |
|---|---|---|
| event_time | 2026-08-24T12:01:03.120Z | 이벤트 순서와 시간 윈도우 계산 |
| server_id | asia-1-room-042 | 인스턴스별 편차 분석 |
| region | ap-northeast-2 | 지역 및 리전 비교 |
| ip_hash | 16진수로 인코딩한 HMAC-SHA256 결과 | 원본 IP 최소 보관 |
| account_id_hash | 해시된 계정 ID | 계정과 IP 관계 분석 |
| session_id | 세션 식별자 | 세션별 시퀀스 분석 |
| command | Move, Attack, Login | 명령어 빈도와 분포 |
| direction | c2s 또는 s2c | 요청과 응답 구분 |
| payload_bytes | 128 | 비정상 패킷 크기 탐지 |
| result_code | OK, INVALID, RATE_LIMIT | 실패율과 제재 근거 |
| latency_ms | 42 | 지연 증가 및 서버 장애 구분 |
| trace_id | UUID | 여러 서비스의 이벤트 연결 |
IP 원문을 장기간 저장할 필요가 없다면 HMAC-SHA256을 사용해 동일 IP를 같은 값으로 매핑할 수 있습니다. 단순 해시는 사전 대입 공격에 취약할 수 있으므로 운영 환경에서는 키를 별도로 관리하는 편이 안전합니다.
전체 탐지 아키텍처는 어떻게 구성할까?
예시 기술 스택은 게임 서버에서 생성한 구조화 로그, Kafka 3.x, Apache Flink 또는 Kafka Streams, ClickHouse, Redis, Python 3.12 기반 추론 서비스입니다. 이미 지원 기간 내 .NET 또는 Go 버전으로 서버를 운영하고 있다면 로그 생성부만 공통 스키마에 맞추고 탐지 파이프라인은 독립 서비스로 분리할 수 있습니다. 버전 번호는 예시이며 실제 도입 시점의 지원·보안 업데이트 상태를 확인해야 합니다.
flowchart LR
    A[게임 서버] --> B[로그 수집기]
    B --> C[Kafka Topic packet-events]
    C --> D[실시간 특징량 집계]
    D --> E[규칙 엔진]
    D --> F[Isolation Forest 추론]
    E --> G[위험도 결합기]
    F --> G
    G --> H{위험도 단계}
    H -->|관찰| I[ClickHouse 저장]
    H -->|제한| J[Rate Limit 정책]
    H -->|격리| K[Redis TTL 정책]
    K --> L[API Gateway 또는 방화벽]
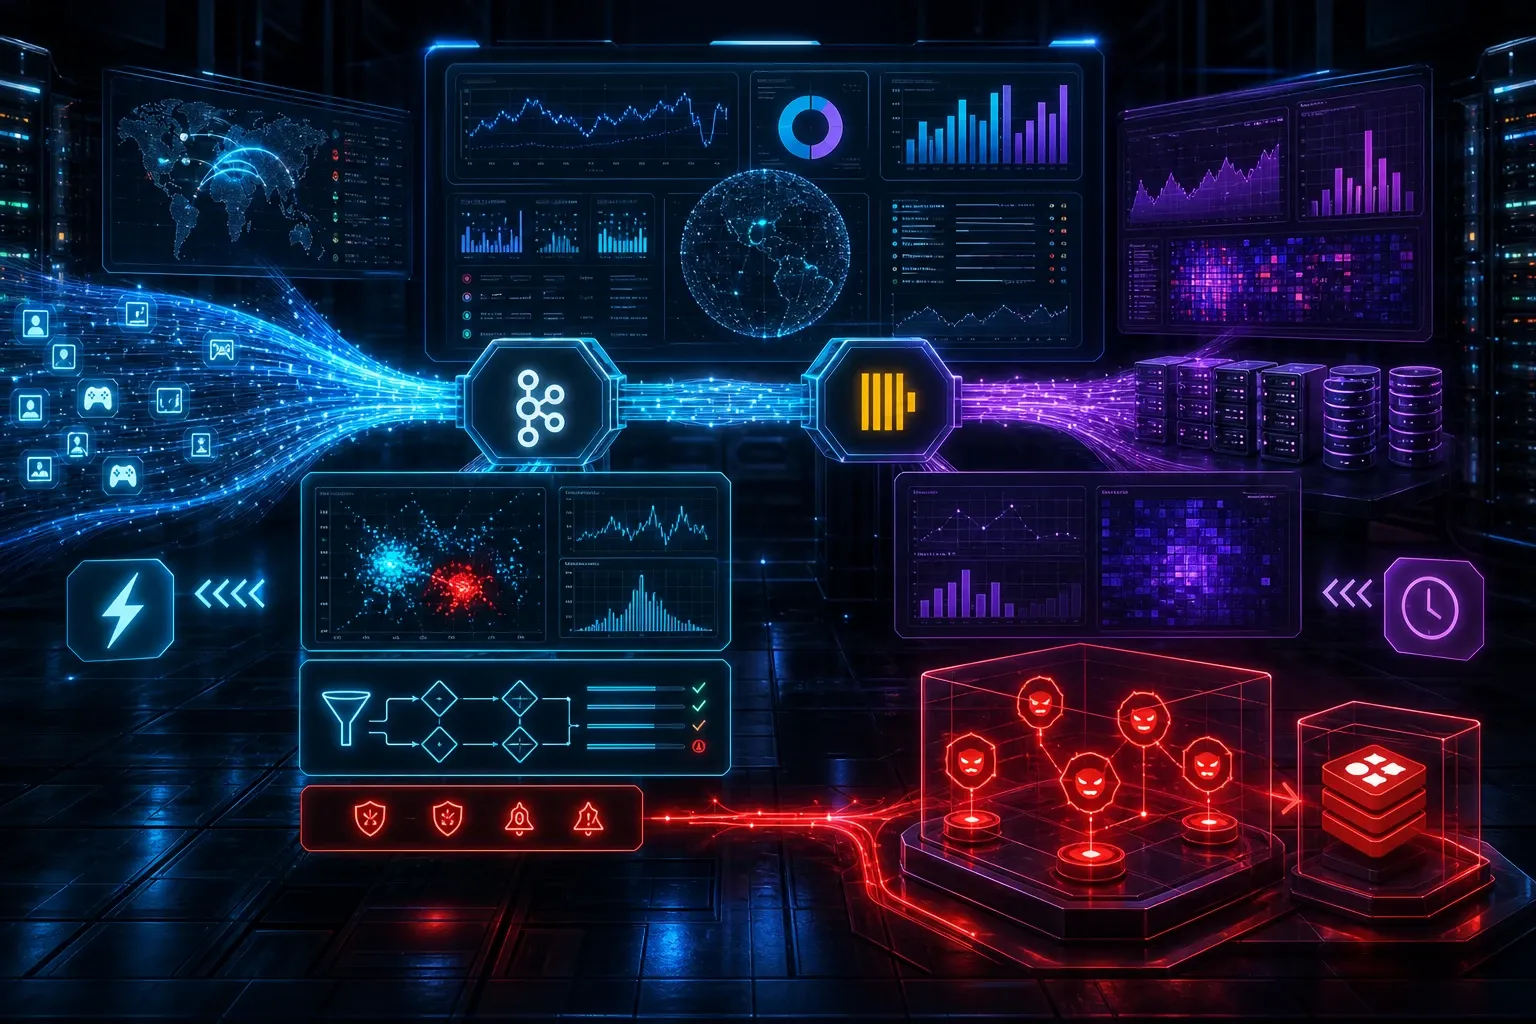
실시간 경로와 분석 경로는 분리하는 방식을 고려할 수 있습니다. 실시간 판단에 수백 밀리초의 처리 목표가 있다면 최근 1분 또는 5분 특징량과 가벼운 모델을 사용할 수 있습니다. 분석 경로는 ClickHouse에서 과거 7일 또는 30일 데이터를 조회해 모델 재학습, 임계값 조정, 오탐 분석을 수행하는 예시입니다.
패킷 로그를 AI 특징량으로 어떻게 변환할까?
머신러닝 모델에 원시 이벤트를 바로 입력하지 말고 IP, 계정, 세션, 서버를 기준으로 고정된 시간 윈도우를 만들어 집계합니다. 예를 들어 60초 윈도우마다 다음 특징량을 계산할 수 있습니다.
| 특징량 | 설명 | 탐지 대상 |
|---|---|---|
| request_count | 전체 요청 수 | 봇, 플러딩 |
| unique_session_count | 고유 세션 수 | 다중 접속 |
| unique_account_count | 고유 계정 수 | 계정 스프레이 |
| invalid_ratio | 실패 응답 비율 | 무차별 대입 |
| command_entropy | 명령어 분포의 엔트로피 | 단일 명령 반복 |
| payload_mean | 평균 패킷 크기 | 비정상 페이로드 |
| p95_latency | 95퍼센타일 처리 시간 | 서버 부하와 공격 구분 |
| cross_region_count | 접근 리전 수 | 프록시, 계정 공유 |
| reconnect_count | 재접속 횟수 | 세션 교란 |
명령어 분포의 다양성은 Shannon 엔트로피로 계산할 수 있습니다.
특정 IP가 60초 동안 Login만 수천 번 요청하면 엔트로피가 낮아집니다. 정상 플레이어는 게임 상황에 따라 이동, 공격, 상태 조회 등 여러 명령을 사용할 수 있지만 명령 분포는 게임과 행동에 따라 달라집니다. 엔트로피가 낮다는 사실만으로 제재하면 로그인 서버나 점검 시간의 정상 트래픽을 오탐할 수 있으므로 다른 특징량과 함께 사용해야 합니다.
로그 집계 예시
ClickHouse 테이블은 보존 기간과 조회 패턴에 따라 원본 이벤트와 집계 데이터를 분리하는 방식을 고려할 수 있습니다.
CREATE TABLE packet_events
(
    event_time DateTime64(3, 'UTC'),
    server_id LowCardinality(String),
    region LowCardinality(String),
    ip_hash FixedString(64),
    account_id_hash FixedString(64),
    session_id String,
    command LowCardinality(String),
    direction Enum8('c2s' = 1, 's2c' = 2),
    payload_bytes UInt32,
    result_code LowCardinality(String),
    latency_ms UInt32,
    trace_id UUID
)
ENGINE = MergeTree
PARTITION BY toDate(event_time)
ORDER BY (ip_hash, event_time, server_id);
실제 운영에서는 원본 보존 기간을 짧게 두고 1분 단위 집계 테이블을 장기 보관하는 방법을 고려할 수 있습니다. 보존 기간은 개인정보 처리 기준, 보안 감사 요구사항, 비용을 함께 검토해 결정해야 합니다.
규칙 기반 탐지와 Isolation Forest는 어떻게 결합할까?
규칙 기반 탐지는 설명 가능성이 높고 즉시 대응할 수 있습니다. 예를 들어 10초 동안 로그인 실패가 50회 이상이면 제한하고 1분 동안 20개 이상의 계정에 접근하면 추가 위험 점수를 부여할 수 있습니다.
Isolation Forest는 샘플을 고립시키는 데 필요한 분할 깊이를 이용하는 비지도 이상 탐지 알고리즘입니다. 레이블이 부족한 경우 시도할 수 있지만, 신규 콘텐츠나 이벤트 기간의 정상 패턴까지 이상으로 분류할 수 있습니다.
| 방식 | 장점 | 한계 | 추천 용도 |
|---|---|---|---|
| 고정 임계값 | 빠르고 설명하기 쉬움 | 이벤트와 리전별 편차에 약함 | 명백한 플러딩 |
| 이동 평균과 z-score | 기준선 변화 반영 | 이상치가 기준선을 오염시킬 수 있음 | 트래픽 급증 |
| Isolation Forest | 레이블 없이 다변량 탐지 | 모델 설명과 재학습 필요 | 복합 어뷰징 |
| Autoencoder | 복잡한 패턴 학습 가능 | 데이터와 운영 비용이 큼 | 대규모 장기 운영 |
| 규칙 + 모델 앙상블 | 차단 근거와 탐지 범위 확보 | 정책 설계가 복잡함 | 자동 격리 최종 판단 |
Isolation Forest의 예시 파라미터는 n_estimators=200, contamination=0.005, random_state=42입니다. contamination은 실제 공격 비율을 의미하는 확정값이 아니라 초기 임계값을 정하기 위한 운영 파라미터로 취급해야 합니다. 정상 트래픽 샘플을 충분히 확보한 뒤 리전, 서버 종류, 시간대별로 검증해야 합니다.
from sklearn.ensemble import IsolationForest
from sklearn.preprocessing import RobustScaler

features = [
    "request_count",
    "unique_session_count",
    "unique_account_count",
    "invalid_ratio",
    "command_entropy",
    "payload_mean",
    "p95_latency",
    "reconnect_count",
]

scaler = RobustScaler()
X = scaler.fit_transform(train_df[features])

model = IsolationForest(
    n_estimators=200,
    contamination=0.005,
    random_state=42,
    n_jobs=-1,
)
model.fit(X)

current_X = scaler.transform(current_df[features])
current_df["model_score"] = -model.score_samples(current_X)
current_df["is_anomaly"] = model.predict(current_X) == -1score_samples의 원시 점수는 서비스별로 분포가 다르므로 그대로 차단 기준으로 사용하면 안 됩니다. 검증 데이터의 분위수와 실제 신고, 제재 결과를 함께 사용해 위험도 구간을 정의해야 합니다.
어뷰징 IP 위험도는 어떻게 계산할까?
모델 점수와 규칙 점수를 0부터 100 사이의 위험도로 정규화하면 정책 엔진에서 다루기 쉽습니다. 예시는 다음과 같습니다.
여기서 M은 모델 이상 점수, B는 규칙 위반 점수, H는 최근 제재 이력 점수입니다. 세 값은 모두 0과 1 사이로 정규화합니다.
| 위험도 | 대응 | 기본 TTL |
|---|---|---|
| 0 ≤ R < 40 | 로그 기록과 관찰 | 없음 |
| 40 ≤ R < 70 | API별 속도 제한과 추가 검증 | 10분 |
| 70 ≤ R < 90 | 세션 종료, 매치메이킹 제한 | 1시간 |
| 90 ≤ R ≤ 100 | 게이트웨이 또는 방화벽 격리 | 6시간 |
자동 격리는 IP 하나만을 절대적인 사용자 식별자로 보지 않아야 합니다. 이동통신망, 학교, PC방, 기업망처럼 여러 사용자가 하나의 공인 IP를 공유할 수 있기 때문입니다. 가능하면 IP, 계정, 디바이스 식별자, 세션, ASN 또는 지역 정보를 함께 보고 IP 단독 차단은 명백한 공격 패턴에만 적용합니다.
어뷰징 IP 자동 격리는 어떻게 구현할까?
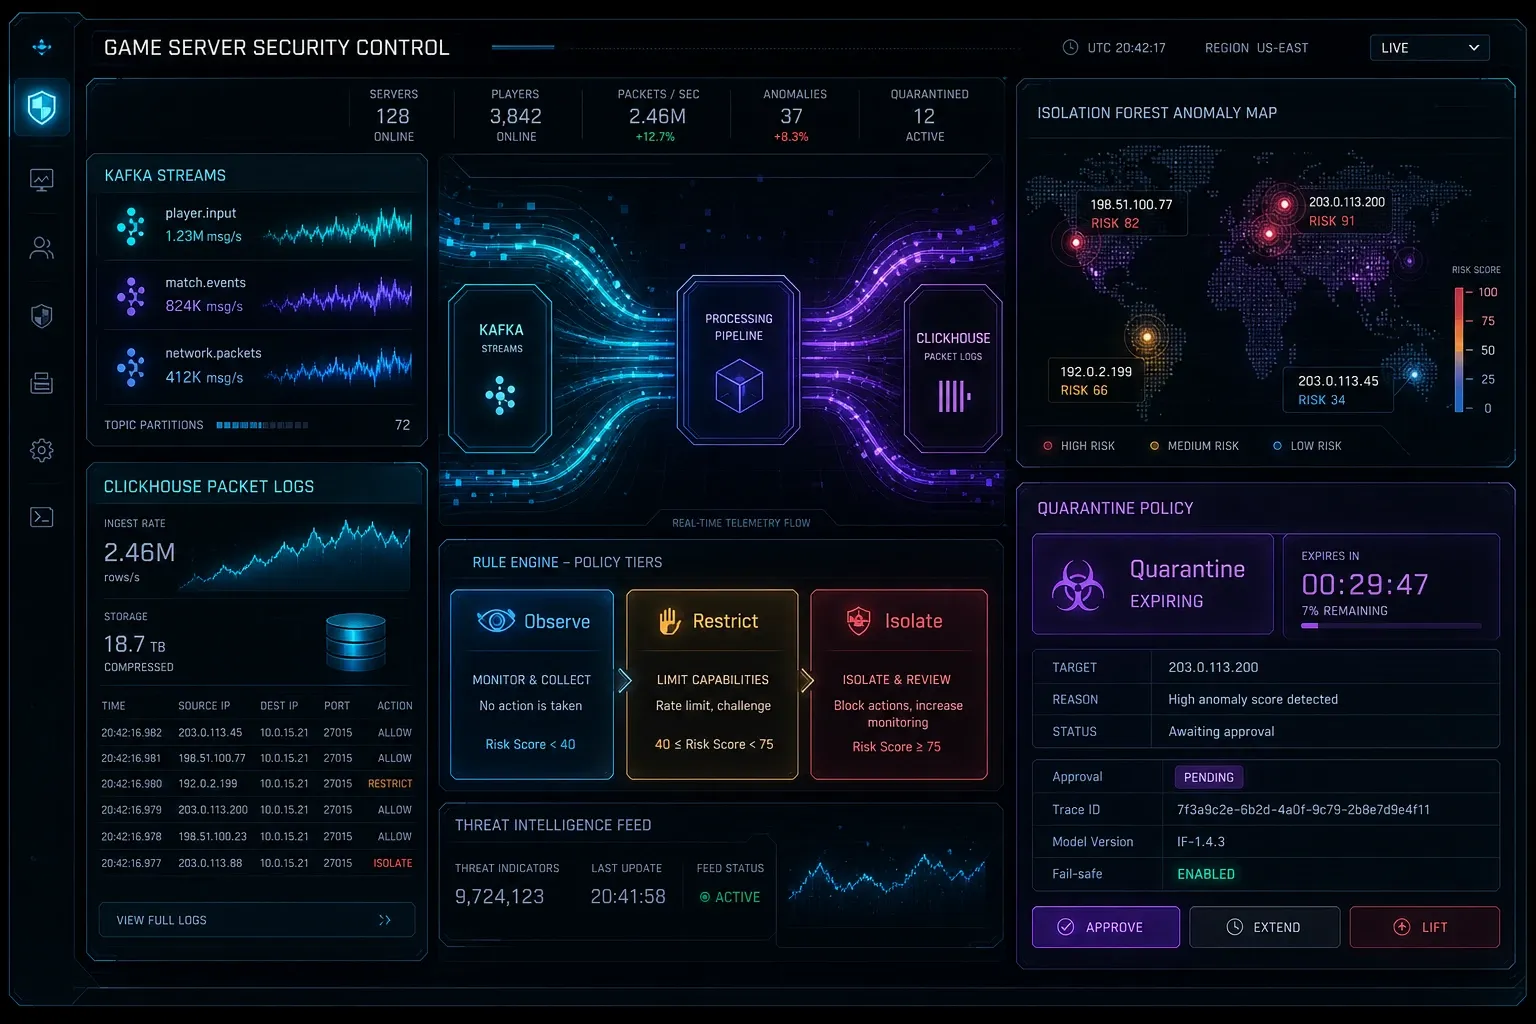
자동 격리는 다음 3단계로 나누면 장애와 오탐의 영향을 줄일 수 있습니다.
1단계: 관찰 모드
탐지 이벤트를 생성하지만 실제 차단은 수행하지 않습니다. 이 기간에는 다음 지표를 확인합니다.
- 시간당 탐지 건수
- 정상 사용자 중 탐지된 비율
- 모델 탐지와 규칙 탐지의 일치율
- 운영자가 승인한 실제 제재 비율
- 리전과 서버 종류별 오탐 분포
2단계: 제한 모드
위험 IP의 로그인 시도, 룸 생성, 채팅 전송, 보상 요청처럼 공격에 악용되기 쉬운 API만 제한합니다. 일반 콘텐츠 이용을 모두 막지 않으면 오탐 발생 시 사용자 영향 범위를 줄일 수 있습니다.
SET abuse:ip:<ip_hash> restricted EX 600 NX실제 구현에서는 Redis 키에 원문 IP를 넣지 않고 서비스에서 사용하는 안전한 식별자 정책을 적용합니다. NX는 기존 키를 어떤 값으로도 덮어쓰지 않으므로 재시도 중 같은 제한 정책이 갱신되는 것을 막습니다. 같은 IP의 제한을 격리로 올려야 한다면 NX만으로는 부족하며, 정책 강도를 원자적으로 비교해 더 강한 상태만 적용하는 로직이 필요합니다.
3단계: 격리 모드
위험도가 높고 재현 가능한 공격 패턴일 때만 API Gateway, 서비스 메시, 방화벽 또는 CDN의 차단 정책을 호출합니다. 차단 API는 다음 조건을 만족해야 합니다.
- 요청마다
reason,model_version,trace_id,expires_at기록 - 동일 정책의 중복 호출을 멱등성 키로 방지
- 만료 시간이 없는 영구 차단 금지
- 외부 방화벽 호출 실패 시 게임 서버 전체를 차단하지 않는 fail-open 또는 fail-closed 정책 명시
- 긴급 해제를 위한 관리자 승인 API 제공
정책 저장 예시는 다음과 같습니다.
{
  "subject": "ip_hash:9f3...",
  "action": "quarantine",
  "scope": ["login", "matchmaking", "reward"],
  "risk_score": 94.2,
  "reason_codes": ["LOGIN_BRUTE_FORCE", "MULTI_ACCOUNT_BURST"],
  "model_version": "iforest-2026-08-01",
  "created_at": "2026-08-24T12:01:04Z",
  "expires_at": "2026-08-24T18:01:04Z"
}
자동 격리 전에 반드시 검증해야 할 운영 안전장치
AI 탐지 시스템은 보안 시스템이면서 동시에 사용자 트래픽을 차단하는 시스템입니다. 따라서 모델 정확도보다 안전한 실패와 복구가 중요할 수 있습니다.
오탐 방지
점검, 대규모 이벤트, 신규 패치, 인기 스트리머 방송처럼 트래픽 패턴이 변하는 시간대에는 별도의 기준선을 사용합니다. 관리자 계정이나 사내 테스트 IP를 단순 영구 허용 목록으로 관리하기보다 만료 시간과 승인자를 함께 기록하는 편이 안전합니다.
피드백 루프
운영자가 탐지 결과를 정상, 의심, 확정 어뷰징으로 분류하면 해당 결과를 다음 모델 평가와 임계값 조정에 사용합니다. 단, 자동 제재 결과를 그대로 정답 레이블로 사용하면 모델의 초기 오판이 반복될 수 있으므로 사람이 확인한 결과와 고객 문의 결과를 구분해야 합니다.
모델 버전 관리
모델 파일만 저장하지 말고 학습 기간, 특징량 목록, 스케일러, 임계값, 학습 데이터의 필터 조건을 함께 버전 관리해야 합니다. 추천 메타데이터는 다음과 같습니다.
| 항목 | 예시 |
|---|---|
| model_version | iforest-2026-08-01 |
| feature_schema | packet-feature-v3 |
| training_window | 2026-07-01~2026-07-31 |
| threshold | p99.5 |
| owner | security-platform |
| rollback_model | iforest-2026-07-15 |
개인정보와 보관 정책
패킷 페이로드에는 인증 토큰, 채팅 내용, 개인정보가 포함될 수 있습니다. 가능한 경우 원본 페이로드 대신 크기, 해시, 명령어 유형만 수집하고 접근 권한을 분리합니다. 로그 보존 기간과 원문 IP 처리 방식은 서비스의 개인정보 보호 정책과 관련 법률 검토를 거쳐 결정해야 합니다.
탐지 시스템을 검증하는 방법은?
운영 트래픽에 바로 차단을 적용하지 말고 재생 테스트와 카나리 정책을 사용합니다.
- 과거 ClickHouse 이벤트에서 정상 구간과 알려진 공격 구간을 추출합니다.
- 동일 시간 순서로 특징량을 재생해 탐지 결과를 생성합니다.
- 정밀도, 재현율, 시간당 오탐 사용자 수, 탐지 지연 시간을 계산합니다.
- 관찰 모드에서 실제 운영 패턴과 대조합니다.
- 일부 리전 또는 일부 API에만 제한 모드를 적용합니다.
- 제재 해제와 모델 롤백 절차를 실제로 실행해 봅니다.
특히 평가 지표를 전체 이벤트 기준으로만 계산하면 공격 이벤트가 많은 서비스에서 결과가 왜곡될 수 있습니다. IP 단위, 계정 단위, 세션 단위로 각각 평가하고 정상 사용자가 한 번이라도 차단되었는지 별도로 확인해야 합니다.
자주 묻는 질문(FAQ)
패킷 원문을 저장하지 않아도 이상 탐지가 가능한가?
가능합니다. 요청 수, 패킷 크기, 명령어 유형, 결과 코드, 처리 시간, 세션 관계만으로도 플러딩과 반복 실패 같은 많은 패턴을 탐지할 수 있습니다. 원문이 필요한 경우에는 짧은 보존 기간과 강한 접근 통제를 적용해야 합니다.
Isolation Forest만 사용해도 충분한가?
충분하지 않습니다. 명백한 공격은 규칙 엔진이 더 빠르고 설명 가능하게 처리하며 신규 복합 패턴은 모델이 보완합니다. 실제 자동 격리에는 규칙, 모델 점수, 제재 이력을 결합한 앙상블 정책이 적합합니다.
IP를 차단하면 VPN이나 프록시 우회 공격을 막을 수 있는가?
IP 차단만으로는 어렵습니다. 계정, 디바이스, 세션, 요청 시퀀스, 인증 실패 패턴을 함께 평가하고 필요하면 계정별 추가 인증이나 API별 속도 제한을 적용해야 합니다. 다만 디바이스 식별자는 개인정보와 추적 가능성 문제가 있으므로 목적과 보존 범위를 명확히 해야 합니다.
정리
분산 게임 서버의 이상 탐지는 로그 수집, 특징량 집계, 모델 추론, 정책 실행을 하나의 거대한 서비스로 만드는 문제가 아닙니다. Kafka와 ClickHouse로 관측 기반을 만들고 Isolation Forest와 규칙 엔진을 조합한 뒤 Redis TTL 정책과 게이트웨이 제어를 연결하는 단계적 설계가 핵심입니다.
자동 격리는 탐지 즉시 영구 차단이 아니라 관찰, 제한, 격리의 위험도 단계로 운영해야 합니다. 모델 버전, 탐지 근거, 만료 시간, 해제 절차를 함께 기록하면 보안을 강화하면서도 정상 플레이어에게 발생하는 오탐 피해를 통제할 수 있습니다.