게임 서버 실시간 모니터링: Prometheus 메트릭 수집과 Grafana CCU·TPS 대시보드 구축 가이드
게임 서버의 동시 접속자 수(CCU)와 초당 트랜잭션 수(TPS)를 실시간 모니터링하기 위한 Prometheus 메트릭 설계, 익스포터 연동 및 Grafana 대시보드 구축 방법을 단계별로 정리합니다.
핵심 요약
게임 서버 모니터링은 비정상 트래픽, 세션 누수, 틱 레이트 저하를 감지하는 데 활용할 수 있습니다. Prometheus의 Pull 메트릭 수집 모델과 Gauge(CCU), Counter(패킷/트랜잭션) 타입을 활용해 서버 상태를 노출하고 Grafana에서 PromQL(sum(game_server_ccu), sum(rate(game_server_packets_total[1m]))) 대시보드를 구성할 수 있습니다. 실제 병목을 파악하는 범위와 알림 기준은 서비스의 계측 항목과 부하 테스트로 확인해야 합니다.
게임 서버에서 실시간 CCU와 처리량을 모니터링해야 하는 이유는 무엇인가?
멀티플레이어 게임 서버는 웹 서비스와 달리 지속적인 상태(Stateful)와 높은 초당 입출력(I/O)을 유지합니다. 수천 명의 유저가 동시에 접속해 패킷을 송수신하는 환경에서는 작은 병목이나 로직 오류가 전체 월드의 틱 레이트(Tick Rate) 저하 또는 서버 다운으로 직결됩니다.
실시간 관측 가능성(Observability)이 확보되지 않으면 다음과 같은 치명적인 문제가 발생합니다.
- 스파이크 트래픽 감지 실패: 이벤트 오픈이나 신규 콘텐츠 배포 시 급증하는 트래픽을 즉시 파악하지 못해 오토스케일링 타이밍을 놓칩니다.
- 세션 누수(Session Leak): 연결이 끊긴 클라이언트의 세션 객체가 해제되지 않고 남아 메모리를 고갈시키는 현상을 조기에 발견하기 어렵습니다.
- 틱 지연 원인 추적 불가: CPU 사용량만으로는 패킷 처리 지연, 데이터베이스 락(Lock), 외부 결제 API 지연 중 어느 것이 틱 드롭을 유발했는지 식별할 수 없습니다.
| 지표명 | 주요 메트릭 타입 | 측정 목적 | 이상 징후 기준 |
|---|---|---|---|
| CCU (동시 접속자 수) | Gauge | 현재 월드/채널/인스턴스별 접속 세션 수 | 급격한 하락(크래시) 또는 비정상 완만한 증가(세션 누수) |
| PPS / TPS / QPS (처리량) | Counter / Rate | 패킷, 게임 트랜잭션, DB 쿼리를 각각 별도 카운터로 계측한 초당 처리량 | 기대 처리량 대비 급격한 감소(데드락, 블로킹 I/O 등) |
| Tick Duration (틱 소요 시간) | Histogram | 1프레임(Tick) 연산 완료에 소요된 시간 | 목표 틱 주기( 등)를 초과하는 빈도 증가 |
| Packet Latency (패킷 지연) | Histogram | 패킷 수신부터 처리 완료까지의 소요 시간 | 레이턴시 급증(네트워크 버퍼 적체) |
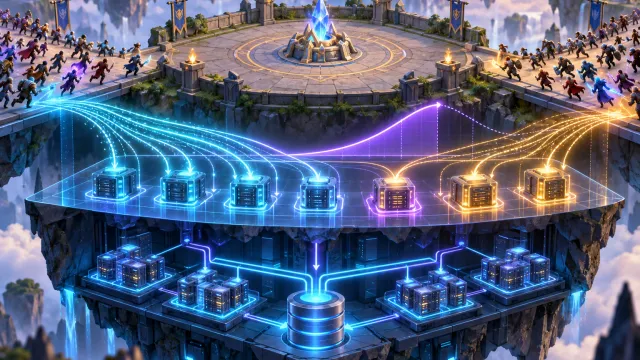
flowchart LR
    subgraph Game_Server_Cluster [게임 서버 클러스터]
        GS1[게임 서버 인스턴스 1<br/>:9100 /metrics]
        GS2[게임 서버 인스턴스 2<br/>:9100 /metrics]
        GS3[게임 서버 인스턴스 N<br/>:9100 /metrics]
    end

    subgraph Monitoring_Stack [모니터링 인프라]
        PROM[Prometheus Server<br/>Pull Scrape Interval: 5s]
        GRAF[Grafana Dashboard<br/>실시간 시각화 & Alert]
    end

    PROM -->|HTTP GET Scrape| GS1
    PROM -->|HTTP GET Scrape| GS2
    PROM -->|HTTP GET Scrape| GS3
    GRAF -->|PromQL Query| PROM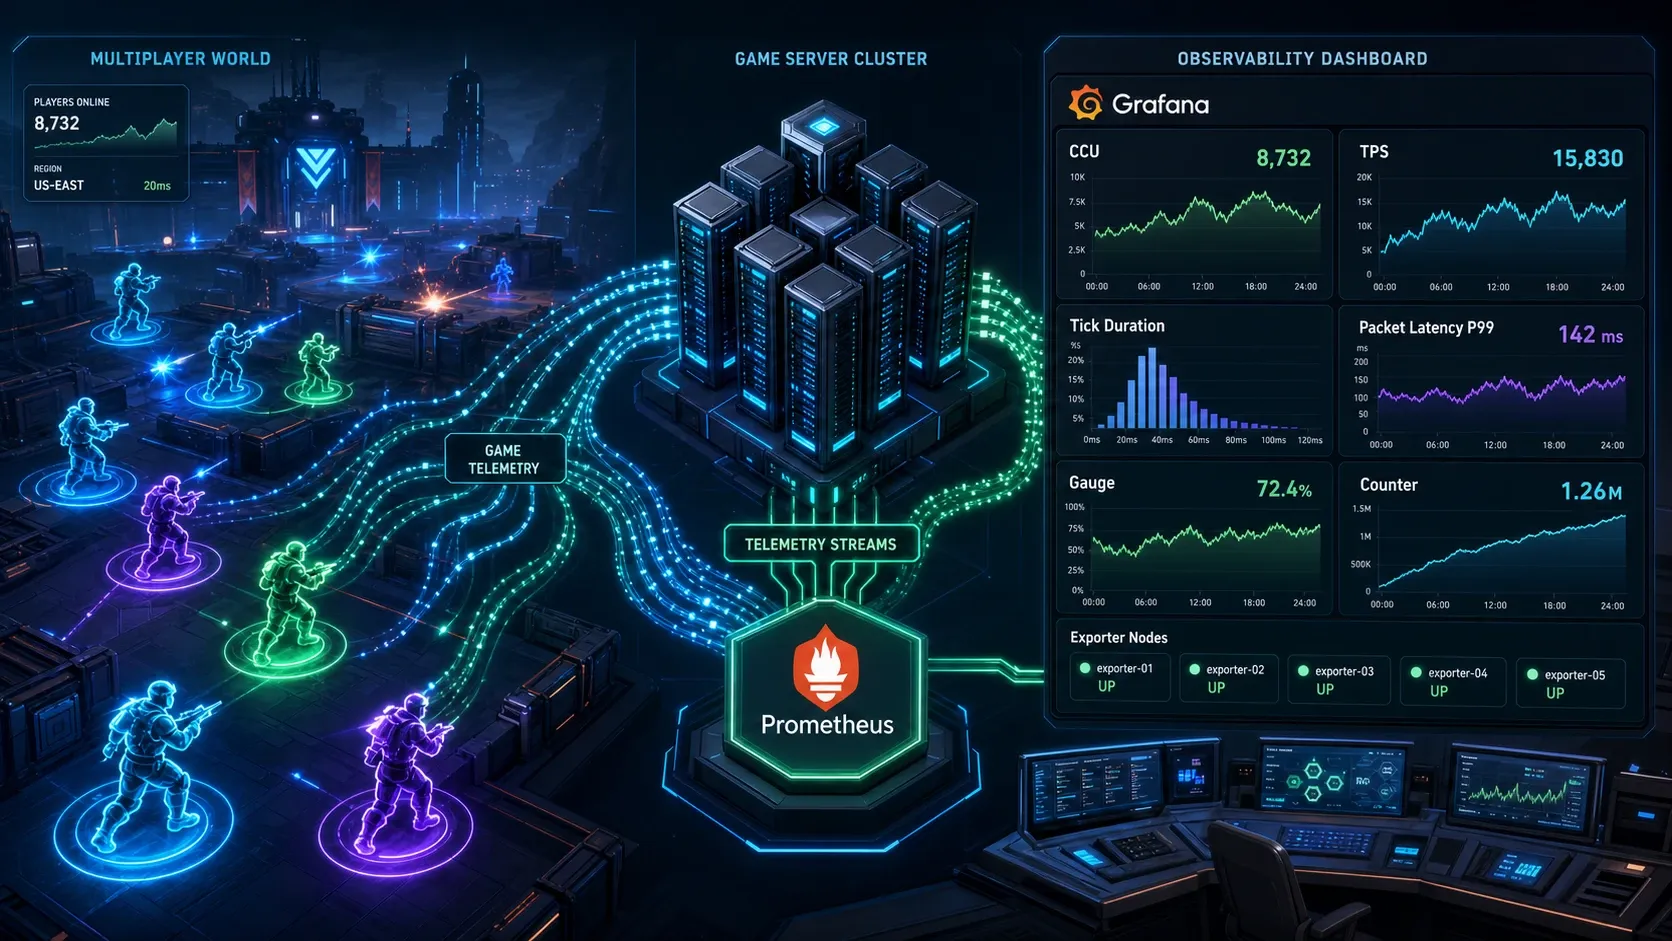
Prometheus 메트릭 타입과 게임 서버 지표 설계
Prometheus는 크게 4가지 메트릭 타입을 제공합니다. 게임 서버의 모니터링 요구사항에 맞추어 적절한 타입을 선택해야 정확한 집계와 분석이 가능합니다.
- Gauge (게이지): 현재 시점의 값을 나타내며 증가하거나 감소할 수 있는 지표입니다. 현재 접속 중인 동시 접속자 수(CCU), 활성 룸(Room) 개수, 메모리 풀 사용량에 사용합니다.
- Counter (카운터): 누적 증가만 하는 지표입니다. 패킷 수, 로그인 시도 횟수, DB 쿼리 실행 횟수처럼 단조 증가하는 이벤트를 기록하고
rate()와 결합해 해당 이벤트의 초당 처리량을 계산합니다. 패킷 카운터는 PPS를 나타내며 TPS/QPS는 트랜잭션·쿼리 카운터를 별도로 계측해야 합니다. - Histogram (히스토그램): 관측값을 미리 정의된 버킷(Bucket)별로 나누어 카운트합니다. 패킷 처리 지연시간(, , ) 및 DB 응답 속도 분포를 측정할 때 사용합니다.
- Summary (서머리): 클라이언트 측에서 직접 백분위수를 계산하여 노출합니다. 오버헤드가 크고 여러 인스턴스 간의 집계가 불가능하므로 분산 게임 서버 환경에서는 Histogram 사용이 권장됩니다.
1단계: 게임 서버에 Prometheus 메트릭 익스포터 연동하기
C# (.NET 기반 게임 서버) 환경에서 prometheus-net 라이브러리를 사용해 HTTP 엔드포인트(:9100/metrics)를 열고 CCU, 패킷 처리량, 틱 지연시간을 수집하는 구현 예제입니다.
using System;
using System.Threading;
using System.Threading.Tasks;
using Prometheus;

public class GameServerMetrics
{
    // 1. 현재 접속자 수 (CCU) - Gauge
    private static readonly Gauge ConnectedUsers = Metrics.CreateGauge(
        "game_server_ccu",
        "현재 접속 중인 세션 수",
        new GaugeConfiguration
        {
            LabelNames = new[] { "server_id", "world_id", "channel_id" }
        });

    // 2. 누적 처리 패킷 수 (PPS 계산용) - Counter
    private static readonly Counter ProcessedPacketsTotal = Metrics.CreateCounter(
        "game_server_packets_total",
        "서버에서 처리된 누적 패킷 수",
        new CounterConfiguration
        {
            LabelNames = new[] { "server_id", "packet_type" }
        });

    // 3. 틱 처리 소요 시간 - Histogram
    private static readonly Histogram TickDurationSeconds = Metrics.CreateHistogram(
        "game_server_tick_duration_seconds",
        "1틱 연산 소요 시간(초)",
        new HistogramConfiguration
        {
            LabelNames = new[] { "server_id" },
            // 10ms(0.01s)부터 100ms(0.1s)까지의 버킷 정의
            Buckets = new[] { 0.005, 0.010, 0.020, 0.033, 0.050, 0.075, 0.100 }
        });

    private MetricServer _metricServer;

    public void StartExporter(int port = 9100)
    {
        // 메트릭 스크랩용 경량 HTTP 서버 구동
        _metricServer = new MetricServer(port: port);
        _metricServer.Start();
        Console.WriteLine($"[Metrics] Prometheus Exporter started on port {port}");
    }

    public void OnUserConnected(string serverId, string worldId, string channelId)
    {
        ConnectedUsers.WithLabels(serverId, worldId, channelId).Inc();
    }

    public void OnUserDisconnected(string serverId, string worldId, string channelId)
    {
        ConnectedUsers.WithLabels(serverId, worldId, channelId).Dec();
    }

    public void OnPacketProcessed(string serverId, string packetType)
    {
        ProcessedPacketsTotal.WithLabels(serverId, packetType).Inc();
    }

    public void RecordTickDuration(string serverId, double durationSeconds)
    {
        TickDurationSeconds.WithLabels(serverId).Observe(durationSeconds);
    }
}
2단계: Prometheus 스크랩(Scrape) 설정 및 인프라 구성
게임 서버 인스턴스들이 노출하는 메트릭을 수집하도록 prometheus.yml 파일을 구성합니다. 기본값보다 짧은 수집 주기(scrape_interval)가 필요하다면 예시처럼 5초로 설정할 수 있습니다. 더 짧은 주기는 수집량과 저장 공간에 미치는 영향을 측정한 뒤 선택하세요.
global:
  scrape_interval: 5s
  evaluation_interval: 5s

scrape_configs:
  - job_name: "game-servers"
    metrics_path: "/metrics"
    static_configs:
      - targets:
          - "10.0.1.101:9100"
          - "10.0.1.102:9100"
          - "10.0.1.103:9100"
        labels:
          env: "production"
          region: "ap-northeast-2"
[!NOTE]
Kubernetes 또는 Agones를 사용하는 전용 서버 클러스터 환경에서는static_configs대신kubernetes_sd_configs를 사용하여 Pod 레이블 기반으로 동적 탐색(Service Discovery)을 구성하는 것이 표준입니다.
3단계: Grafana 실시간 CCU 및 처리량 대시보드 구축과 PromQL 작성법
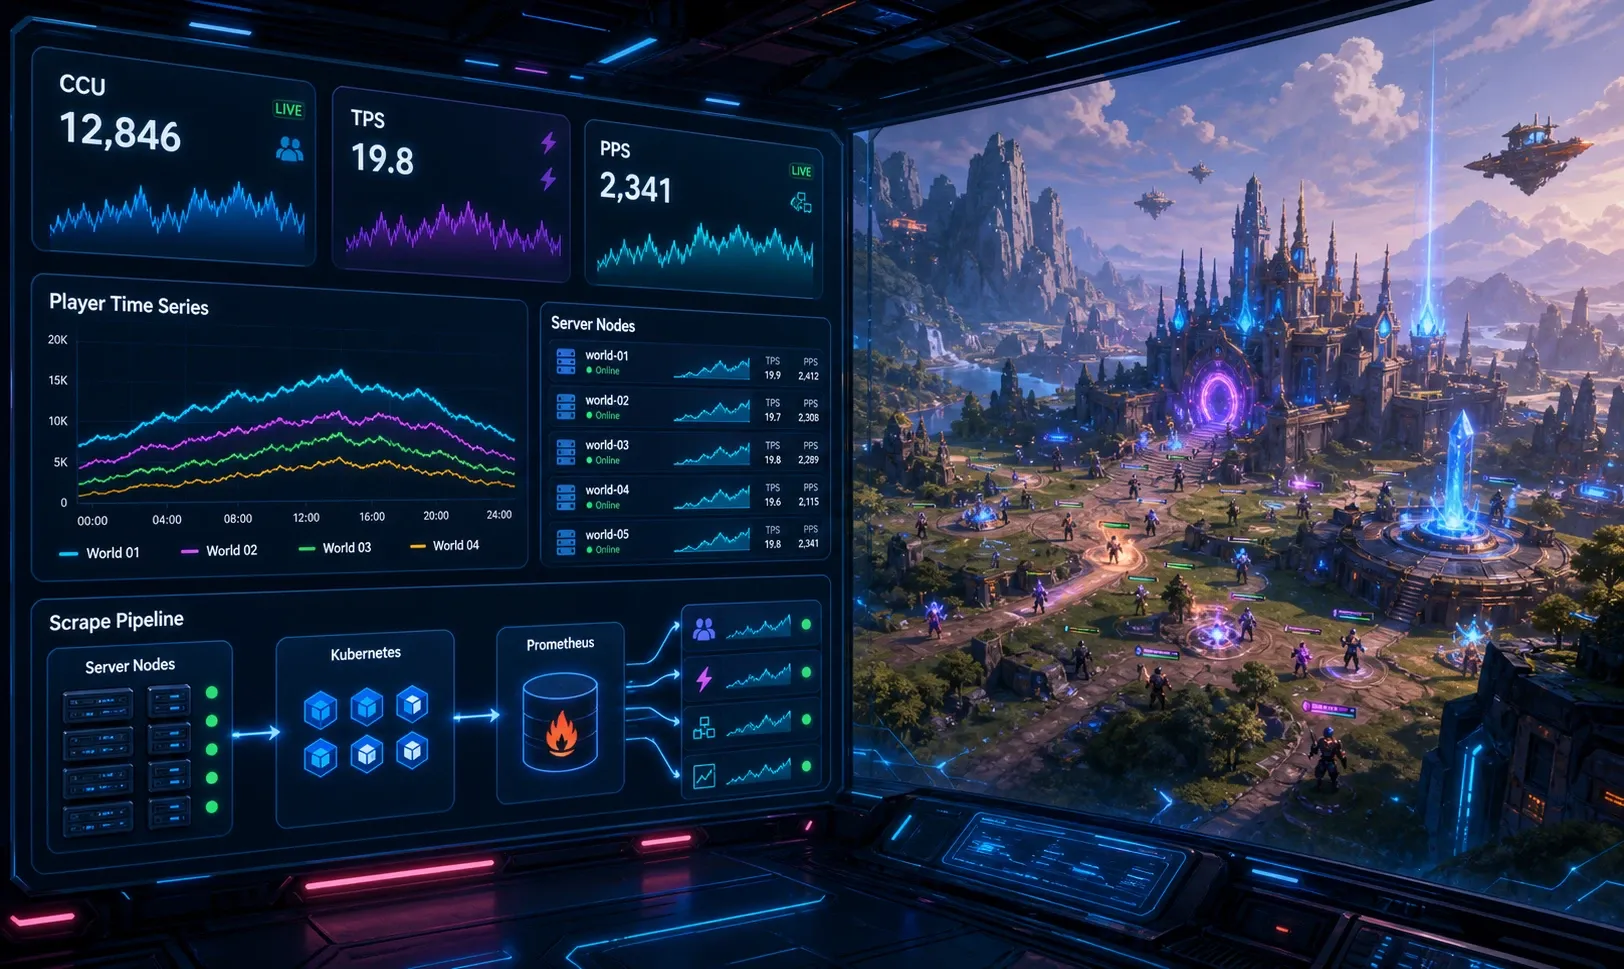
Grafana에서 Prometheus를 데이터 소스로 연결한 후, 핵심 모니터링 패널들을 PromQL(Prometheus Query Language)로 구현합니다.
1. 전체 및 월드별 실시간 CCU 쿼리
현재 활성화된 모든 서버의 접속자 수를 합산하거나 특정 월드별로 그룹화합니다.
- 전체 동시 접속자 수 (Stat 패널):
sum(game_server_ccu{env="production"})- 월드별 CCU 추이 (Time Series 그래프):
sum(game_server_ccu{env="production"}) by (world_id)2. 실시간 패킷 처리량 (PPS)
누적 패킷 카운터 지표에 rate() 함수를 적용하여 초당 패킷 수(PPS)를 산출합니다. 게임 또는 데이터베이스 트랜잭션 처리량(TPS/QPS)을 보려면 패킷 카운터와 구분되는 트랜잭션 카운터를 별도로 계측하고 같은 방식으로 조회해야 합니다.
- 서버 전체 실시간 PPS (Time Series 그래프):
sum(rate(game_server_packets_total{env="production"}[1m]))- 패킷 타입별 PPS 상위 5개 (TopK Bar Gauge):
topk(5, sum(rate(game_server_packets_total{env="production"}[1m])) by (packet_type))3. 틱 지연시간 및 패킷 레이턴시 모니터링
히스토그램 버킷을 합산해 관측값의 99번째 백분위 지연시간()을 계산합니다. 이 값은 관측값의 약 99%가 그 이하이고 약 1%가 그 이상인 지점을 나타냅니다.
histogram_quantile(0.99, sum(rate(game_server_tick_duration_seconds_bucket{env="production"}[1m])) by (le, server_id))대규모 트래픽 환경에서 메트릭 수집 시 주의할 점
- 카디널리티 폭발(Cardinality Explosion) 방지: 레이블 값으로
user_id,session_id,room_uuid와 같이 고유값이 무한히 생성되는 필드를 넣으면 Prometheus의 메모리가 급격히 고갈됩니다. 레이블은server_id,world_id,packet_type등 제한된 유한 집합에만 부여해야 합니다. - 메인 루프 블로킹 방지: 메트릭 수집 라이브러리는 내부적으로 원자적 연산(Atomic Operation)이나 락프리 구조를 사용하지만 수집 로직 내에서 문자열 포맷팅이나 무거운 조회를 수행하면 게임 루프 성능에 악영향을 줍니다. 레이블 객체는 미리 캐싱하여 사용하십시오.
- 스크랩 오버헤드 최적화: 1초 단위 스크랩은 Prometheus 스토리지 및 네트워크 I/O에 부담을 줍니다. 실시간 대시보드 용도로는 5초~10초 수집 주기가 가장 권장되는 타협점입니다.
자주 묻는 질문 (FAQ)
Q1. 수천 대의 데디케이트 서버가 동적으로 생성/종료될 때 Prometheus 스크랩 대상은 어떻게 관리하나요?
고정 IP/포트 기반의 static_configs 대신 서비스 디스커버리(Service Discovery) 메커니즘을 사용합니다. Kubernetes 환경에서는 PodMonitor 또는 Agones의 Fleet 메트릭 애노테이션을 활용하고 AWS EC2/GameLift 환경에서는 aws_sd_configs나 Consul 연동을 통해 동적으로 인스턴스 목록을 갱신합니다.
Q2. TPS 계산 시 rate()와 irate() 중 어떤 함수를 사용해야 하나요?
Grafana 대시보드의 장기 추세 및 안정적인 그래프 표현에는 지정한 시간 범위의 평균 초당 증가율을 계산하는 rate() 함수가 적합합니다. irate()는 범위 내의 마지막 두 데이터 포인트만 계산하므로 순간적인 스파이크를 포착하는 데는 유리하지만 그래프 변동성이 심해 알람 룰이나 대시보드 메인 패널에는 rate()를 권장합니다.
Q3. Prometheus의 Pull 방식 대신 Pushgateway를 게임 서버에 사용해도 되나요?
Pushgateway는 배치 작업(Batch Job)처럼 즉시 종료되는 프로세스의 메트릭 수집을 위해 설계되었습니다. 상시 실행되는 게임 서버에 Pushgateway를 적용하면 단일 장애점(SPOF)이 되고 오래된 메트릭이 지워지지 않는 문제가 발생하므로 표준 Pull 방식을 직접 유지하는 것이 바람직합니다.
마치며: 관측 가능성으로 지키는 플레이어 경험
모니터링의 진정한 가치는 장애가 터진 뒤 빠르게 파악하는 것이 아니라 임계치에 도달하기 전 선제적으로 위험을 방어하는 데 있습니다. Prometheus의 Gauge와 Counter를 목적에 맞게 활용하고 날카로운 PromQL 쿼리를 구성하여 어떤 트래픽 급증에도 유저 경험을 온전히 지켜내는 탄탄한 인프라를 운영하시길 바랍니다.