게임 매치메이킹 MMR/ELO 알고리즘 구현: 대기시간 가중치로 공정성과 매칭 속도 잡기
ELO 기반 MMR 계산, 기대 승률, K값 조정, 대기시간에 따른 허용 레이팅 범위 확장과 매칭 점수 분산 전략을 실전 서버 구조와 TypeScript 예제로 설명합니다.
핵심 요약
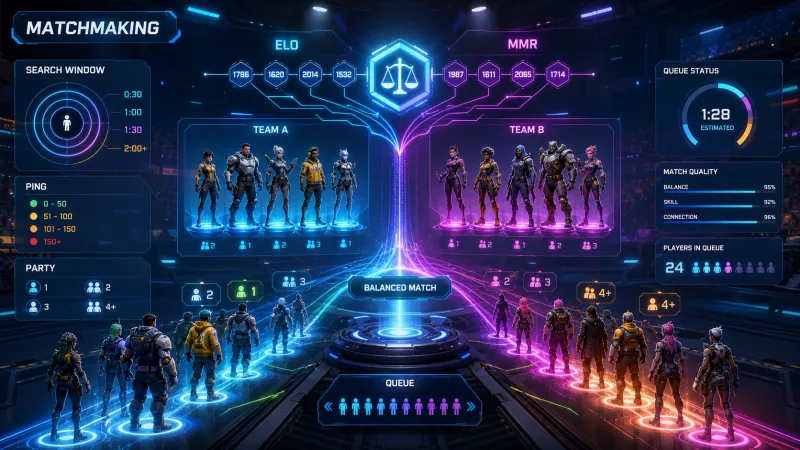
게임 매치메이킹은 ELO 기대 승률로 MMR을 갱신하고 큐 대기시간이 길어질수록 허용 MMR 차이를 점진적으로 넓혀야 공정성과 매칭 속도를 함께 확보할 수 있다. 핵심은 단순히 범위를 넓히는 것이 아니라 MMR 차이, 대기시간, 핑, 파티 크기를 하나의 점수로 정규화하고 대기시간별 분산 정책을 적용하는 것이다.
매치메이킹 MMR은 왜 필요한가?
MMR(Matchmaking Rating)은 실력 추정치이며 ELO는 그 추정치를 승패 결과로 갱신하는 대표적인 방식이다. 랭크 티어는 사용자에게 보여 주는 등급일 수 있지만 매치 생성은 보통 숨겨진 MMR을 기준으로 처리한다.
같은 티어 안에서도 실제 실력 차이가 있을 수 있으므로 티어만으로 매칭하면 한쪽 팀 승률이 과도하게 기울 수 있다. 서버는 각 플레이어 또는 파티의 MMR을 저장하고 가능한 조합 중 기대 승률이 균형에 가까운 매치를 선택해야 한다.
| 용어 | 역할 | 서버에서 저장할 값 예시 |
|---|---|---|
| MMR | 내부 실력 추정치 | rating = 1524.7 |
| ELO | 승패로 레이팅을 갱신하는 수식 | 기대 승률, K값, 결과 |
| 표시 랭크 | 사용자 UI용 등급 | Gold 2, RP 61 |
| 매칭 윈도우 | 허용 가능한 MMR 차이 | 대기시간별 min/max |
| 매칭 점수 | 후보 조합의 우선순위 | MMR·핑·대기시간 점수 |
ELO 기반 MMR은 어떻게 계산할까?
두 플레이어 A와 B의 레이팅을 각각 R_A, R_B라고 할 때 A의 기대 승률은 다음과 같다.
A의 실제 결과 S_A는 승리면 1, 패배면 0이다. 무승부가 있는 게임이라면 0.5를 사용한다. 새 레이팅은 다음처럼 계산한다.
여기서 K는 한 경기 결과가 MMR에 미치는 크기다. K가 크면 빠르게 변하지만 변동성이 커지고 작으면 안정적이지만 실제 실력 변화 반영이 늦어진다.
K값은 모든 플레이어에게 같아야 할까?
반드시 그렇지는 않다. 신규 계정은 실력 추정의 불확실성이 크므로 높은 K값을 적용하고 충분한 경기 수를 가진 계정은 낮은 K값을 적용하는 방식이 흔하다.
| 상태 | 예시 K값 | 목적 |
|---|---|---|
| 배치 전 또는 10판 미만 | 48 | 적정 구간으로 빠르게 수렴 |
| 일반 플레이어 | 24 | 안정적인 레이팅 변화 |
| 장기 활동 플레이어 | 16 | 단일 경기로 인한 급변 방지 |
단, ELO만으로 연승·연패, 파티 매칭, 역할별 실력, 장기 미접속을 모두 완벽하게 다루기는 어렵다. 운영 규모가 커지면 Glicko-2의 RD(Rating Deviation) 또는 TrueSkill의 불확실성 값을 추가 검토할 수 있다. 다만 초기 구현은 ELO와 명시적인 보정 규칙만으로도 충분히 운영 가능한 경우가 많다.
export function expectedScore(myMmr: number, opponentMmr: number): number {
  return 1 / (1 + Math.pow(10, (opponentMmr - myMmr) / 400));
}

export function calculateK(gamesPlayed: number): number {
  if (gamesPlayed < 10) return 48;
  if (gamesPlayed < 50) return 24;
  return 16;
}

export function updateMmr(
  currentMmr: number,
  opponentMmr: number,
  won: boolean,
  gamesPlayed: number,
): number {
  const expected = expectedScore(currentMmr, opponentMmr);
  const actual = won ? 1 : 0;
  const next = currentMmr + calculateK(gamesPlayed) * (actual - expected);

  return Math.round(next * 100) / 100;
}
대기시간이 길수록 MMR 허용 범위를 왜 넓혀야 하는가?
MMR 차이를 좁게 유지하면 공정한 매치를 만들기 쉽지만 인구가 적은 지역·시간대·고랭크 구간에서는 큐가 끝나지 않을 수 있다. 반대로 처음부터 범위를 크게 잡으면 빠르게 시작되지만 실력 차이가 큰 매치가 늘어난다.
따라서 매칭 윈도우는 큐 진입 후 시간 t에 따라 확장한다. 기본 허용 차이를 D_0, 초당 확장량을 g, 최대 허용 차이를 D_max라고 하면 다음 정책을 사용할 수 있다.
예를 들어 D_0 = 50, g = 2, D_max = 300이면 60초 대기한 플레이어의 허용 차이는 170이다. 이 값은 게임의 한 판 길이, MMR 분포, 동시 접속자 수, 목표 대기시간을 기준으로 실측하며 조정해야 한다.
선형 확장만 사용하면 생기는 문제
모든 큐에 동일한 선형 확장을 적용하면 고랭크 큐가 너무 이르게 넓어지거나 신규 플레이어 큐가 필요 이상으로 오래 막힐 수 있다. 추천하는 방식은 MMR 구간과 지역별로 정책을 분리하는 것이다.
| 조건 | 기본 허용 차이 | 확장 속도 | 최대 허용 차이 |
|---|---|---|---|
| 일반 MMR 구간 | 50 | 초당 2 | 250 |
| 상위 1% 구간 | 35 | 초당 3 | 350 |
| 신규 계정 보호 큐 | 25 | 초당 1 | 150 |
| 저활성 지역 | 75 | 초당 3 | 400 |
대기시간 가중치 분산은 어떻게 구현할까?
단순 범위 필터는 후보가 여러 명일 때 어느 조합이 더 좋은지 판단하지 못한다. 이때 각 후보 매치에 점수를 부여하고 낮은 점수를 선택한다.
아래 예시는 이미 후보로 구성한 두 큐 그룹의 평균 MMR·예상 핑·대기시간을 계산하는 간단한 점수 모델이다. partySize는 그룹 인원수이며, 이 함수 자체가 파티 조합이나 팀 인원·역할 제약을 만들지는 않는다. 그런 제약은 먼저 후보 생성 단계에서 만족시켜야 한다.
대기시간 보너스는 오래 기다린 플레이어가 계속 뒤로 밀리지 않게 한다. 다만 보너스가 너무 크면 이미 대기 중인 한 명 때문에 불균형한 매치가 강제될 수 있으므로 최대값을 둔다.
type QueueGroupCandidate = {
  candidateId: string;
  mmr: number;
  queuedAt: number;
  estimatedPingMs: number;
  partySize: number;
};

const MAX_WAIT_BONUS = 0.35;

function allowedMmrDelta(waitSeconds: number): number {
  return Math.min(300, 50 + waitSeconds * 2);
}

function candidateScore(a: QueueGroupCandidate, b: QueueGroupCandidate, now: number): number {
  const waitA = (now - a.queuedAt) / 1000;
  const waitB = (now - b.queuedAt) / 1000;
  const window = Math.min(allowedMmrDelta(waitA), allowedMmrDelta(waitB));
  const mmrDelta = Math.abs(a.mmr - b.mmr);
  if (mmrDelta > window) return Number.POSITIVE_INFINITY;
  const mmrPenalty = mmrDelta / window;
  const pingPenalty = Math.max(a.estimatedPingMs, b.estimatedPingMs) / 200;
  const partyPenalty = Math.abs(a.partySize - b.partySize) * 0.25;
  const waitBonus = Math.min(MAX_WAIT_BONUS, (waitA + waitB) / 600);

  return mmrPenalty * 0.65 + pingPenalty * 0.2 + partyPenalty * 0.15 - waitBonus;
}
대기시간 가중치를 분산해야 하는 이유는 무엇인가?
큐 전체에서 가장 오래 기다린 플레이어만 우선하면 해당 플레이어 주변의 후보가 반복적으로 소모되고 비슷한 시간에 들어온 다른 플레이어는 불리해질 수 있다. 이를 줄이려면 큐를 시간 버킷으로 나누고 각 버킷에서 후보를 일부씩 선택하는 분산 정책이 유용하다.
예를 들어 0~15초, 16~30초, 31~60초, 61초 이상 버킷을 만들고 오래된 버킷에 더 높은 가중치를 주되 모든 선택권을 주지는 않는다. 매칭 라운드마다 오래된 버킷을 우선 탐색하고 동점이면 MMR 차이와 핑이 더 작은 후보를 고른다.
flowchart TD
  A[큐 엔트리 수집] --> B[지역·게임 모드·파티 조건 필터]
  B --> C[대기시간 버킷 분류]
  C --> D[각 엔트리의 MMR 윈도우 계산]
  D --> E[호환 가능한 후보 조합 생성]
  E --> F[MMR·핑·파티·대기시간 점수 계산]
  F --> G{점수와 제약 조건 통과?}
  G -- 예 --> H[매치 예약 및 큐 원자적 제거]
  G -- 아니오 --> I[다음 매칭 틱에서 재평가]
매치메이킹 서버를 구현하는 3단계
1. 큐 키와 제약 조건을 먼저 분리한다
큐는 최소한 region, mode, inputType, ranked, partySize로 분리한다. 서로 다른 입력 장치나 지역을 무조건 섞으면 MMR이 비슷해도 체감 공정성이 무너질 수 있다.
Redis Sorted Set을 사용한다면 큐 진입 시각 또는 우선순위 점수를 인덱스로 쓰고 플레이어의 MMR·핑·파티 정보는 Hash 또는 별도 저장소에 둔다. 다만 Sorted Set 하나만으로 복잡한 후보 검색을 해결하려 하지 말고 매칭 워커가 제한된 후보 풀을 읽어 점수를 계산하도록 설계하는 편이 단순하다.
2. 매칭 틱에서 후보 풀을 제한한다
매칭 워커는 1초마다 전체 큐를 전수 탐색하지 않는다. 각 지역·모드 큐에서 오래 기다린 엔트리부터 일정 개수만 읽는다. 예를 들어 틱당 200명을 읽고 기준 플레이어당 가까운 MMR 후보 20~40명만 평가한다.
이 제한은 CPU 사용량을 예측 가능하게 만들며 대규모 큐에서 후보 조합이 폭발하는 문제를 줄인다. 복잡도는 모든 쌍을 비교하는 경우의 O(n²) 대신 제한된 후보 수에 비례하게 관리할 수 있다.
3. 예약과 제거를 원자적으로 처리한다
두 매칭 워커가 같은 플레이어를 동시에 매치로 확정하면 중복 입장 문제가 발생한다. Redis Lua 스크립트, 데이터베이스 행 잠금, 또는 단일 파티션 소비자처럼 한 가지 일관된 원자성 전략을 선택해야 한다.
확정 시에는 queue entry -> reserved -> matched 상태 전이를 기록하고 게임 서버 접속 실패나 준비 확인 타임아웃 시에만 안전하게 큐로 되돌린다. 재큐 시에는 원래 대기시간을 일부 보존할지 정책으로 정해야 한다. 일반적으로 네트워크 오류처럼 서버 측 책임이 큰 실패는 대기시간을 보존하는 편이 납득하기 쉽다.
운영에서 반드시 측정할 지표
알고리즘은 수식보다 관측이 중요하다. 다음 지표를 지역, 게임 모드, MMR 구간, 파티 크기별로 분리해 수집한다.
| 지표 | 확인할 문제 |
|---|---|
| P50/P95 대기시간 | 특정 구간의 큐 정체 |
| 매치 내 평균·최대 MMR 차이 | 실력 불균형 |
| 예상 승률 편차 | 팀 구성 품질 |
| 매치 취소율 | 준비 확인 또는 네트워크 문제 |
| 재큐율 | 불만족 매치, 접속 실패 |
| 매칭 워커 처리시간 | 후보 탐색 비용 증가 |
승률만 50%에 맞추는 것은 충분하지 않다. 팀 게임에서는 양 팀 평균 MMR이 같아도 파티 크기, 역할 구성, 핑 차이 때문에 체감이 나빠질 수 있다. 따라서 승률 편차와 함께 이탈률, 재큐율, 매치 종료 전 이탈률을 같이 본다.
자주 묻는 질문 (FAQ)
ELO의 400 상수는 반드시 고정해야 하나요?
아니다. 400은 레이팅 차이와 기대 승률 곡선의 기울기를 정하는 값이다. 게임의 MMR 분포와 한 시즌의 변화 폭에 맞춰 조정할 수 있지만 변경 전후의 MMR을 직접 비교하기 어려워지므로 시즌 경계나 명확한 마이그레이션 계획이 있을 때 바꾸는 편이 안전하다.
대기시간 확장 범위는 몇 초부터 넓혀야 하나요?
정답은 없다. 목표 P95 대기시간과 MMR 구간별 동시 큐 인원을 기준으로 정한다. 초기 실험에서는 예를 들어 5~15초의 엄격 매칭 구간을 후보로 둘 수 있지만, 이 범위가 일반적으로 품질을 보장하지는 않는다. 실제 큐 분포와 이탈률을 측정해 조정한다.
평균 MMR이 같으면 공정한 팀인가요?
항상 그렇지 않다. 팀 내 MMR 분산, 파티 유무, 역할 숙련도, 핑, 입력 장치도 결과와 체감에 영향을 준다. 최소 구현에서는 평균 MMR과 최대 MMR 차이를 함께 제한하고 운영 데이터가 쌓이면 역할과 파티 보정 항목을 추가한다.
정리
안정적인 매치메이킹은 ELO 수식 하나로 끝나지 않는다. ELO로 MMR을 갱신하고 대기시간 기반 MMR 윈도우와 후보 점수 모델로 매치를 선택하며 원자적 예약 처리와 지표 관측으로 운영 루프를 완성해야 한다.
처음에는 MMR 차이 + 대기시간 + 핑 세 항목만으로 시작할 수 있다. 이후 실제 대기시간과 재큐율을 근거로 확장 속도, 최대 허용 차이, 파티 보정치를 조금씩 조정하는 것도 한 가지 운영 방법이다.