AI 에이전트로 게임 서버 API 부하 테스트 시나리오 자동 생성하기
AI 에이전트로 게임 서버 API 부하 시나리오 초안을 만드는 방법을 정리합니다. OpenAPI와 k6 예시를 통해 상태 기반 테스트, 실행 범위 제한, 검증 기준, 결과 분석 절차를 살펴봅니다.
핵심 요약
적절한 도구와 입력 계약을 갖춘 경우 AI 에이전트에 OpenAPI 명세, 인증 방식, API 의존성, 게임 플레이 상태 전이를 제공해 k6 기반 부하 테스트 시나리오 초안을 만들게 할 수 있습니다. 핵심은 임의 요청 생성을 맡기는 것이 아니라 시나리오 스키마, 실행 범위, 성능 임계값을 함께 정의하는 것입니다.
자동 생성 결과는 정적 검증, 저강도 드라이런, 단계적 부하 테스트를 거쳐야 합니다. 매치메이킹과 전투처럼 여러 API가 상태를 공유하는 기능을 실제 플레이 흐름에 가깝게 시험하려면 로그인, 세션 생성, 매치 참가, 게임 상태 갱신의 의존성을 시나리오에 반영해야 합니다. 독립 API 검증도 계약이나 개별 동작을 확인할 때는 별도로 유용합니다.
AI 에이전트를 게임 서버 부하 테스트에 어떻게 활용할 수 있을까?
게임 서버 부하 시나리오에서는 로그인 응답의 토큰을 후속 요청에 사용하고 매치 ID를 다른 API에 전달하는 등 API 간 의존성을 표현해야 할 수 있습니다. 테스트 계정과 데이터도 대상 시나리오에 맞게 준비합니다.
입력 계약과 검토 절차를 마련했다면 다음 작업의 초안을 만드는 데 AI 에이전트를 활용할 수 있습니다.
- OpenAPI 3.0 또는 3.1 문서에서 엔드포인트, 메서드, 요청 본문, 응답 필드를 추출
- API 호출 순서와 데이터 의존성을 상태 머신으로 변환
- k6, Locust, Gatling 등 대상 도구에 맞는 스크립트 생성
- 정상 응답뿐 아니라 인증 실패, 중복 요청, 타임아웃, 재시도 흐름 생성
- p95 지연 시간, p99 지연 시간, 오류율, 비즈니스 실패율을 포함한 검증 조건 작성
- 생성된 코드의 문법과 위험한 엔드포인트 사용 여부 검사
서버의 실제 동시성 모델이나 데이터베이스 병목 정보가 입력에 없으면 에이전트가 이를 신뢰성 있게 추론할 수 있다고 가정해서는 안 됩니다. 생성 결과는 테스트 초안으로 다루고 최종 실행 범위와 성공 기준은 개발자가 검토·통제합니다.
자동 생성 전에 어떤 입력 계약을 정의해야 하는가?
프롬프트 문구만 다듬기보다 입력 계약을 구조화해 제공하면 생성 결과를 검증하고 반복하기 쉬워집니다. 최소한 다음 정보를 정리합니다.
| 입력 정보 | 포함해야 할 내용 | 검증 포인트 |
|---|---|---|
| API 계약 | OpenAPI 문서, 경로, 메서드, 요청·응답 스키마 | 필수 필드와 타입이 일치하는가 |
| 인증 | JWT, OAuth 2.0, 세션 쿠키, 만료 시간 | 실제 운영 토큰을 사용하지 않는가 |
| 상태 전이 | 로그인 → 로비 → 매치 참가 → 전투 → 결과 저장 | 이전 응답의 ID가 다음 요청에 연결되는가 |
| 테스트 데이터 | 테스트 계정 수, 캐릭터 ID, 맵 ID, 지역 코드 | 운영 사용자와 분리되어 있는가 |
| 부하 모델 | 목표 RPS, 동시 사용자 수, 램프업 시간, 지속 시간 | 서버 용량과 테스트 범위가 승인되었는가 |
| 성공 기준 | HTTP 오류율, p95, p99, 비즈니스 오류율 | 단순 2xx 판정에 그치지 않는가 |
| 금지 범위 | 결제 승인, 운영자 API, 실제 알림, 외부 웹훅 | 부작용이 있는 요청이 차단되는가 |
관측된 초당 요청 수(RPS)는 측정 구간의 요청 수를 그 구간의 초 단위 시간으로 나누어 계산할 수 있습니다. 요청을 시작한 시점과 완료한 시점 중 무엇을 셀지 측정 기준에서 정합니다.
동시 사용자 수와 RPS는 같은 개념이 아닙니다. 한 사용자가 여러 API를 호출하면 사용자 수가 같아도 API별 RPS는 달라집니다. 따라서 에이전트 입력에 가상 사용자 수뿐 아니라 사용자당 요청 빈도와 think time을 명시해야 합니다.
에이전트에게 전달할 생성 규칙
다음과 같은 규칙을 시스템 프롬프트 또는 프로젝트 설정에 포함하면 생성 결과의 편차를 줄일 수 있습니다.
- OpenAPI에 없는 경로와 필드는 생성하지 않는다.
- 모든 요청은 테스트 환경의
BASE_URL과 테스트용 인증 정보만 사용한다. - 상태값, 토큰, 매치 ID는 이전 응답에서 추출한다.
- 재시도는 최대 횟수와 백오프 시간을 명시한다.
- 결제, 계정 삭제, 운영자 권한 API는 기본적으로 제외한다.
- 각 시나리오에는 부하 단계, 성공 기준, 중단 조건을 포함한다.
- 생성된 스크립트와 함께 사용한 API 계약과 가정을 기록한다.
AI 에이전트는 게임 플레이 흐름을 어떻게 상태 기반 시나리오로 바꿀까?
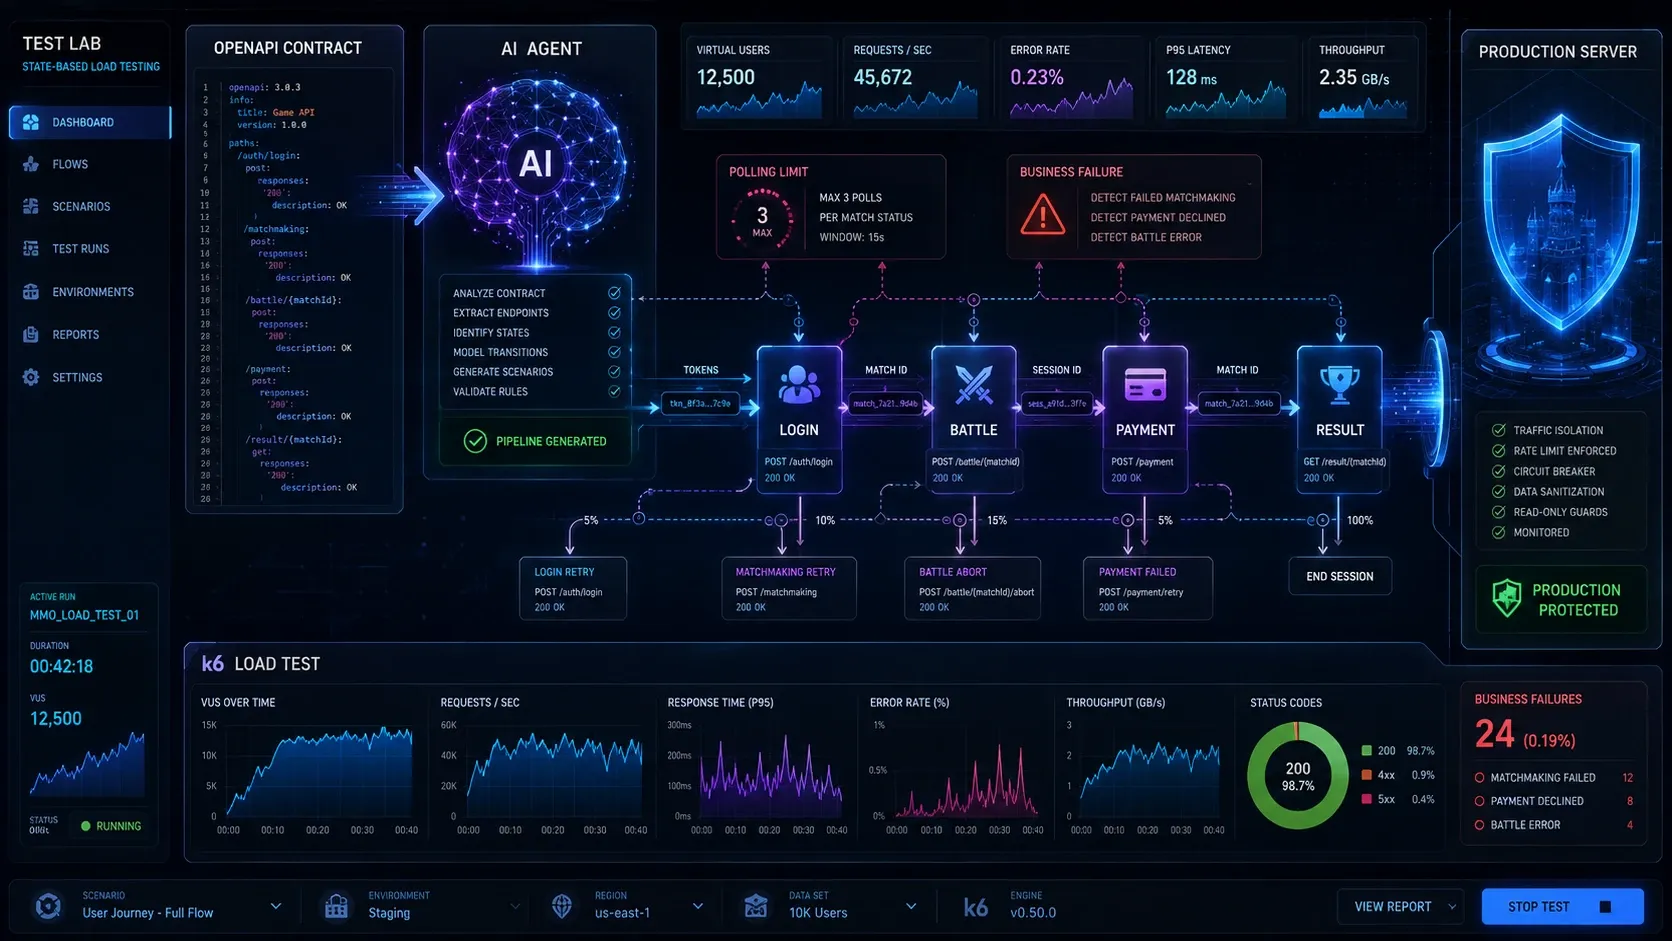
여러 API가 앞선 응답의 값이나 상태에 의존하는 기능은 상태 기반 시나리오로 표현할 수 있습니다. 예를 들어 매치메이킹 흐름은 다음과 같이 구성할 수 있습니다.
| 단계 | 요청 | 앞 단계에서 필요한 값 | 주요 검증 |
|---|---|---|---|
| 1 | POST /v1/auth/login | 테스트 계정 | 토큰 발급과 만료 정보 |
| 2 | POST /v1/matches | 액세스 토큰 | 매치 요청 접수 여부 |
| 3 | GET /v1/matches/{matchId} | 매치 ID | 대기·성공·실패 상태 |
| 4 | POST /v1/sessions | 매치 ID | 게임 세션 생성 여부 |
| 5 | POST /v1/battles/{id}/actions | 세션 ID | 유효한 게임 상태 갱신 |
| 6 | POST /v1/matches/{id}/result | 세션 ID와 결과 | 중복 저장과 무결성 오류 |
에이전트는 이 표를 바탕으로 각 단계의 출력 필드를 다음 단계의 입력 변수로 연결해야 합니다. 단순히 모든 엔드포인트를 순서대로 호출하면 실제 사용자 행동과 다른 부하가 만들어질 수 있으므로 사용자 비율도 함께 지정하는 편이 좋습니다.
예를 들어 전체 가상 사용자 중 70%는 일반 매치 흐름을 실행하고 20%는 재접속 흐름을 실행하며 10%는 매치 취소와 재매칭 흐름을 실행하도록 구성할 수 있습니다.
k6 부하 테스트 스크립트는 어떻게 생성할까?
아래 예시는 AI 에이전트가 생성할 수 있는 k6 JavaScript 스크립트의 기본 형태입니다. ramping-arrival-rate 실행기는 설정한 iteration 시작률을 단계별로 바꾸는 데 유용합니다. 실제 게임 사용자처럼 각 가상 사용자가 응답을 기다리며 다음 동작을 하는 부하를 모델링하려면 ramping-vus를 고려하고, 서로 다른 모델이 필요하면 별도 시나리오를 조합할 수 있습니다.
import http from 'k6/http';
import { check } from 'k6';
import { Rate } from 'k6/metrics';

const failedBusiness = new Rate('failed_business');
const missingMatchId = new Rate('missing_match_id');
const baseUrl = __ENV.BASE_URL;
const token = __ENV.TEST_TOKEN;

export const options = {
  scenarios: {
    match_flow: {
      executor: 'ramping-arrival-rate',
      startRate: 2,
      timeUnit: '1s',
      preAllocatedVUs: 20,
      maxVUs: 100,
      stages: [
        { target: 10, duration: '2m' },
        { target: 10, duration: '5m' },
        { target: 0, duration: '1m' }
      ]
    }
  },
  thresholds: {
    http_req_failed: [
      { threshold: 'rate<0.01', abortOnFail: true, delayAbortEval: '1m' }
    ],
    http_req_duration: ['p(95)<500', 'p(99)<1000'],
    failed_business: [
      { threshold: 'rate<0.02', abortOnFail: true, delayAbortEval: '1m' }
    ],
    missing_match_id: [
      { threshold: 'rate<0.001', abortOnFail: true, delayAbortEval: '1m' }
    ]
  }
};

export default function () {
  const headers = {
    Authorization: `Bearer ${token}`,
    'Content-Type': 'application/json'
  };

  const match = http.post(
    `${baseUrl}/v1/matches`,
    JSON.stringify({ mode: 'ranked', region: 'kr' }),
    { headers }
  );

  const accepted = check(match, {
    'match request accepted': (response) => response.status === 202
  });
  failedBusiness.add(!accepted);

  if (!accepted) return;

  let matchId;
  try {
    matchId = match.json('matchId');
  } catch {
    // A malformed/non-JSON 202 response is a missing business identifier.
  }
  const hasMatchId = typeof matchId === 'string' && matchId.length > 0;
  missingMatchId.add(!hasMatchId);
  if (!hasMatchId) return;

  const state = http.get(`${baseUrl}/v1/matches/${matchId}`, { headers });

  const stateAvailable = check(state, {
    'match state available': (response) => [200, 202].includes(response.status)
  });
  failedBusiness.add(!stateAvailable);
}
이 코드에서 중요한 부분은 세 가지입니다.
BASE_URL과TEST_TOKEN을 환경 변수로 분리해 운영 정보가 코드에 들어가지 않도록 했습니다.matchId를 응답에서 추출해 다음 API에 전달하므로 상태 기반 흐름을 재현합니다.failed_business지표는 이 짧은 예시에서 매치 접수와 상태 조회 검증의 실패를 기록합니다.
이 예시는 매치 생성과 상태 조회만 보여 주며, 위 표의 세션 생성·전투·결과 저장까지 포함한 완결된 사용자 흐름은 아닙니다. ramping-arrival-rate의 rate는 HTTP 요청 수가 아니라 iteration 시작률이므로 iteration 안의 요청 수를 고려해 부하를 산정합니다. 도착률 실행기에서는 sleep()으로 요청률을 조절하지 않습니다. 실제 게임 서버에서 매치 상태를 기다려야 한다면 제한된 횟수와 전체 타임아웃을 두고 폴링합니다.
AI 생성 부하 시나리오는 어떤 절차로 검증해야 할까?
1단계: API 계약과 위험 엔드포인트를 검사한다
생성 전에 OpenAPI 문서를 파싱하고 참조 해석, 예상 응답 필드, 인증이 필요한 경로를 확인합니다. 참조 순환은 OpenAPI 문서에서 허용될 수 있으므로, 이를 일괄 오류로 처리하지 말고 사용하는 도구가 순환 참조를 안전하게 처리하는지 확인합니다. 결제 승인, 계정 삭제, 운영자 권한 변경, 외부 웹훅 호출 API는 별도 허용 목록이 없으면 생성 대상에서 제외합니다.
2단계: 생성 결과를 정적 검증한다
다음 항목은 실행 전에 자동 검사할 수 있습니다.
- JavaScript 문법과 k6 옵션 구조
- OpenAPI에 존재하지 않는 URL과 HTTP 메서드
- 하드코딩된 운영 도메인, 비밀 키, 개인정보
- 무한 루프와 제한 없는 재시도
- 테스트 계정과 데이터의 고정 여부
- 임계값과 중단 조건의 존재 여부
에이전트에게 코드만 요청하기보다 scenario.json 같은 중간 표현을 먼저 생성하게 하면 검증 단계를 분리하기 쉽습니다. 이는 구현 방식에 따른 설계 선택입니다. 중간 표현에는 단계, 입력 변수, 예상 상태 코드, 지연 시간, 재시도 정책을 포함할 수 있습니다.
3단계: 저강도 드라이런을 실행한다
한 자리 수의 VU와 짧은 지속 시간으로 요청 경로가 정상인지 확인합니다. 이 단계에서는 성능 수치보다 다음 문제를 찾는 것이 목적입니다.
- 토큰 추출 실패
- 잘못된 JSON 경로
- 매치 ID와 세션 ID의 연결 오류
- 테스트 데이터 중복
- 서버의 상태 전이와 스크립트 가정 불일치
4단계: 부하 단계를 점진적으로 높인다
다음은 테스트 목적을 구분해 작성한 예와 임의의 부하값입니다. 숫자와 시간은 프로젝트 기준에 맞춰 정하며 보편적인 표준값이 아닙니다.
| 테스트 유형 | 목적 | 예시 부하 |
|---|---|---|
| Smoke | 스크립트와 환경 정상 여부 확인 | VU 1~5, 1~3분 |
| Load | 예상 피크 트래픽 검증 | 목표 RPS까지 점진 증가 |
| Stress | 병목과 한계점 확인 | 정상 피크를 넘어 단계 증가 |
| Spike | 갑작스러운 접속 폭증 검증 | 1분 안에 5배 증가 |
| Soak | 장시간 누수와 누적 문제 확인 | 1~8시간 지속 |
각 단계에서 CPU, 메모리, GC, 데이터베이스 커넥션 풀, Redis 적중률, 큐 길이, 네트워크 오류 등 서버 측 지표를 함께 수집하는 편이 진단에 도움이 됩니다. API 응답 시간만으로 애플리케이션 병목과 데이터베이스 병목을 특정하기는 어려우므로 계층별 관측 자료를 함께 살핍니다.
5단계: 결과를 에이전트에게 다시 전달한다
AI 에이전트는 k6 요약 결과와 서버 관측 지표를 함께 입력받아 다음 실행 계획을 제안할 수 있습니다. 예를 들어 p99만 급증하고 데이터베이스 CPU가 높다면 쿼리 플랜과 인덱스를 점검하는 후속 시나리오를 생성하게 할 수 있습니다.
이때 에이전트는 원인 후보와 재현 조건을 정리하는 보조 도구로 사용할 수 있습니다. 원인 판단은 프로파일러, 데이터베이스 실행 계획, 분산 추적 등 해당 계층의 추가 자료와 대조해야 합니다.
부하 테스트 자동화에서 보안과 운영 안전성을 어떻게 확보할까?
게임 서버 부하 테스트는 잘못 실행하면 서비스 장애나 데이터 오염을 일으킬 수 있습니다. 다음 안전장치를 기본값으로 두는 것이 좋습니다.
- 테스트 전용 VPC 또는 격리된 스테이징 환경에서 실행
- 테스트 계정과 테스트 결제 수단만 사용
- 실행 가능한 대상 도메인을 allowlist로 제한
- 실행 도구나 래퍼가 실제로 적용하도록 최대 VU, 목표 RPS, 최대 실행 시간을 설정값으로 제한
- 요청 본문과 응답 로그에서 토큰과 개인정보 마스킹
- 테스트 시작과 종료 시점에 담당자와 변경 기록 남김
- 임계값 초과 시 중단해야 한다면 k6 임계값에
abortOnFail을 설정하고, 별도로 오류율 급증에 대한 중단 정책도 구성 - 운영 환경 테스트가 필요하면 사전 승인과 트래픽 상한을 별도로 설정
특히 AI 프롬프트와 로그에 JWT, API 키, 플레이어 식별자, 결제 정보와 같은 실제 데이터를 넣지 않는 편이 안전합니다. 테스트용 데이터는 익명화하거나 합성하고, 외부 AI 서비스를 사용할 때는 해당 서비스의 데이터 보존·학습 설정과 접근 정책을 확인합니다. 프롬프트만으로 데이터의 저장이나 재사용을 통제할 수 있다고 가정해서는 안 됩니다.
자동 생성 방식과 수동 작성 방식은 어떻게 비교할까?
| 항목 | AI 에이전트 자동 생성 | 수동 작성 |
|---|---|---|
| 초기 작성 작업 | 반복적인 초안 생성을 자동화할 수 있음 | 구현자가 직접 요청과 검증을 작성 |
| 상태 흐름 반영 | 계약과 예시가 충분하면 초안에 반영 가능 | 작성자가 도메인 지식을 직접 반영 |
| 일관성 | 공통 규칙과 템플릿을 적용할 수 있음 | 팀의 리뷰·작성 규칙에 좌우됨 |
| 예외 시나리오 | 빠질 수 있으므로 요구사항과 검토가 필요 | 설계자가 범위와 예외를 정함 |
| 유지보수 | 생성 절차가 있으면 계약 변경 후 초안을 다시 만들 수 있음 | 변경된 계약을 기준으로 관련 코드를 수정 |
| 위험 통제 | 정책 검사기를 실행 절차에 추가할 수 있음 | 리뷰와 테스트 절차로 확인 |
자동 생성과 수동 작성의 속도·유지보수 비용은 계약 품질, 도구, 팀 경험에 따라 달라지므로 프로젝트에서 비교해야 합니다. 반복적인 API 호출과 데이터 연결은 에이전트가 초안을 만들고 부하 분포, 게임 규칙, 장애 주입 조건은 서버 개발자와 QA가 검토하는 방식을 선택할 수 있습니다.
자주 묻는 질문 FAQ
AI가 생성한 부하 테스트 스크립트를 바로 실행해도 될까?
안 됩니다. API 계약 검증, 위험 엔드포인트 필터링, 문법 검사, 저강도 드라이런을 먼저 수행해야 합니다. 운영 환경에서는 별도의 승인 절차와 RPS 제한도 필요합니다.
게임 서버의 WebSocket 부하도 같은 방식으로 만들 수 있을까?
가능하지만 HTTP API와는 다른 모델이 필요합니다. 연결 수, 핸드셰이크 비율, 메시지 빈도, 연결 유지 시간, 재접속 폭주를 별도 파라미터로 정의해야 합니다. 현재 k6는 WebSocket 테스트를 지원하며 새 테스트에는 k6/websockets 모듈을 권장합니다. 선택한 도구에서 메시지 순서와 세션 상태를 검증해야 합니다.
성공 기준을 HTTP 상태 코드만으로 정해도 될까?
부족합니다. HTTP의 202 응답은 요청 처리가 접수되었지만 완료되지는 않았다는 뜻이므로, 응답 코드만으로 매치 완료를 판정할 수 없습니다. HTTP 오류율과 함께 매치 성사율, 상태 전이 성공률, 전투 결과 저장 성공률 같은 비즈니스 지표와 p95·p99 지연 시간 같은 성능 지표를 측정해야 합니다.
정리
AI 에이전트를 활용한 게임 서버 API 부하 시나리오 자동 생성의 핵심은 코드 생성 자체가 아닙니다. OpenAPI와 상태 전이 정보를 명확한 입력 계약으로 제공하고 테스트 범위와 안전장치를 제한한 뒤 생성 결과를 단계적으로 검증하는 과정이 중요합니다.
OpenAPI → 상태 기반 시나리오 → k6 스크립트 → 정적 검증 → 드라이런 → 단계적 부하 테스트 흐름을 CI/CD에 연결하면 API 변경 때마다 반복 가능한 테스트를 만들 수 있습니다. 최종 목표는 AI가 모든 판단을 대신하는 것이 아니라 서버 팀이 필요한 시나리오를 검토 가능한 초안으로 만들고 안전한 절차로 검증하도록 돕는 것입니다.