Redis Vector Search로 구현하는 유사 플레이어 성향 AI 매치메이킹 시스템
Redis Vector Search와 HNSW 인덱스를 이용해 플레이 스타일 벡터를 검색하고 실력·핑·파티 조건을 함께 반영하는 실시간 유사 성향 AI 매치메이킹 설계와 구현 방법을 설명합니다.
핵심 요약
Redis Vector Search는 플레이어의 최근 경기 행동을 임베딩 벡터로 저장한 뒤 HNSW 근사 최근접 이웃 검색으로 비슷한 성향의 후보를 빠르게 찾는다. 후보 검색은 벡터 유사도에 맡기고 최종 매칭은 MMR·지역·핑·대기 시간 같은 게임 규칙으로 재정렬해야 공정성과 체감 품질을 함께 확보할 수 있다.
왜 기존 매치메이킹만으로는 부족한가?
전통적인 매치메이킹은 대체로 MMR, 랭크, 서버 지역, 파티 크기를 중심으로 구성한다. 이 조건들은 공정한 승률과 연결 품질을 맞추는 데 효과적이지만 게임을 즐기는 방식까지 표현하지는 못한다.
예를 들어 같은 MMR 2,000인 FPS 플레이어라도 한 명은 교전 빈도가 높은 돌격형이고 다른 한 명은 시야 확보와 거점 방어를 우선하는 운영형일 수 있다. 승률만 비슷하게 맞춘 매치에서는 실력 균형은 맞아도 팀 플레이의 만족도가 낮아질 수 있다.
유사 성향 매치메이킹은 행동 데이터를 수치화해 다음 질문에 답한다.
- 이 플레이어와 최근 플레이 패턴이 비슷한 후보는 누구인가?
- 성향은 비슷하지만 MMR과 네트워크 조건도 허용 범위에 있는가?
- 대기 시간이 길어질수록 어떤 조건을 얼마나 완화할 것인가?
Redis Vector Search 기반 매치메이킹 아키텍처는 어떻게 구성할까?
Redis Stack의 RediSearch 모듈은 HASH 또는 JSON 문서의 벡터 필드에 대해 FLAT 또는 HNSW 인덱스를 만들고 FT.SEARCH로 KNN 검색을 수행한다. 매치메이킹처럼 조회가 잦고 후보 풀이 큰 경우에는 일반적으로 HNSW를 선택한다.
flowchart LR
    A[게임 이벤트] --> B[행동 지표 집계]
    B --> C[성향 벡터 생성]
    C --> D[(Redis Stack<br/>HNSW 인덱스)]
    E[매치 요청] --> F[지역·모드·MMR 필터]
    F --> D
    D --> G[유사 성향 후보 KNN]
    G --> H[핑·파티·대기 시간 재정렬]
    H --> I[매치 확정]
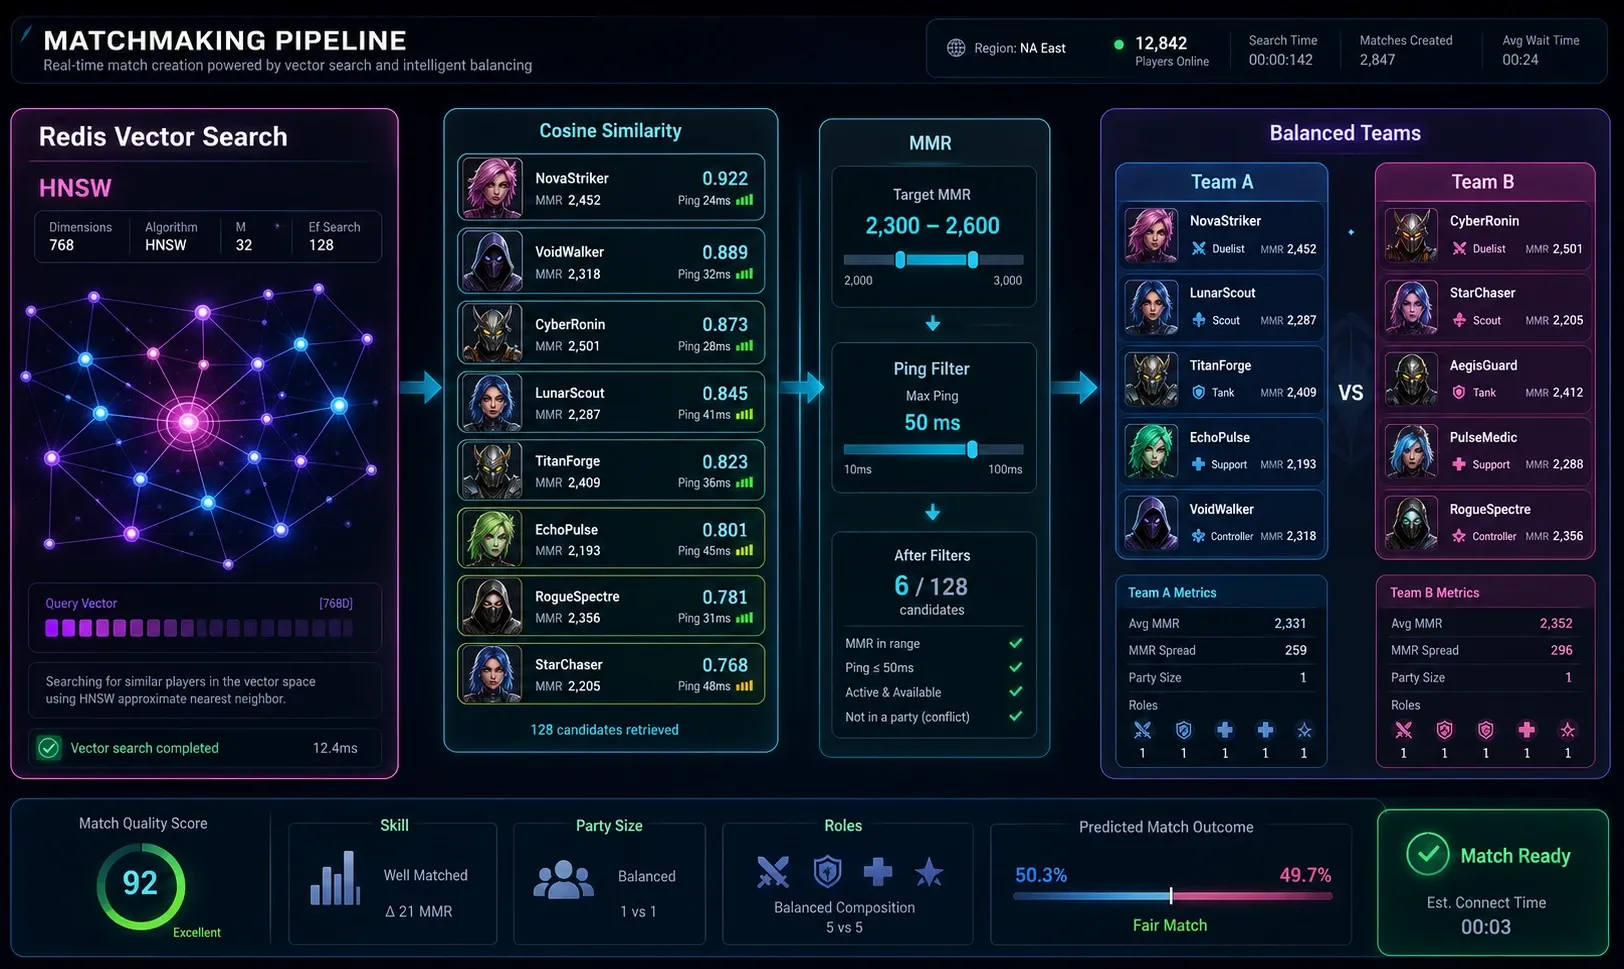
핵심은 벡터 검색을 최종 결정기가 아니라 후보 생성기로 사용하는 것이다. 벡터 검색 단계에서 수백만 명 전체를 비교하지 않고도 상위 후보를 추릴 수 있으며 이후 게임 서버가 명확한 정책으로 매치를 확정한다.
| 계층 | 책임 | 예시 데이터 |
|---|---|---|
| 이벤트 수집 | 원시 플레이 로그 수집 | 킬, 데스, 이동, 오브젝트 참여 |
| 특징 집계 | 일정 기간의 행동을 수치화 | 최근 20판 평균, 표준편차, 비율 |
| 벡터 검색 | 성향이 가까운 후보 탐색 | KNN, COSINE 거리 |
| 규칙 재정렬 | 서비스 제약과 공정성 반영 | MMR 차이, 핑, 지역, 파티 |
| 매치 확정 | 중복 배정 방지와 세션 생성 | 원자적 예약, 룸 생성 |
플레이어 성향 벡터는 무엇으로 만들까?
처음부터 대규모 언어 모델 임베딩을 사용할 필요는 없다. 구조화된 게임 행동 데이터라면 게임 규칙을 반영한 고정 길이 특징 벡터가 더 해석하기 쉽고 운영하기도 좋다.
예를 들어 5v5 슈팅 게임에서 아래 12차원 벡터를 사용할 수 있다.
[킬 관여율, 분당 피해량, 첫 교전 비율, 평균 교전 거리,
 헤드샷 비율, 라운드당 이동 거리, 오브젝트 참여율,
 지원 행동 비율, 생존 시간, 경제 효율, 역전 시도 비율, 이탈률]
특징마다 단위와 분포가 다르므로 정규화가 필요하다. 각 특징값을 최근 시즌 또는 같은 게임 모드의 평균과 표준편차로 표준화할 수 있다. 표준편차가 0인 특징은 나눗셈하지 않도록 제외하거나 0으로 매핑한다.
정규화한 벡터는 float32 배열로 저장한다. 코사인 거리 기준에서는 벡터를 L2 정규화해 두면 점수의 해석과 비교가 단순해진다. 모든 특징값이 0인 경우에는 크기가 0인 벡터를 정규화할 수 없으므로 검색에서 제외하거나 별도 기본 벡터를 정의한다.
성향 벡터는 모든 경기 종료 직후 바로 갱신하기보다 최근 10~20경기의 지수 이동 평균으로 안정화하는 편이 좋다. 한 경기의 비정상적 결과가 플레이어 분류를 크게 흔들지 않기 때문이다.
여기서 α는 0.1~0.3 범위에서 실험할 수 있다. 빠르게 변하는 모드라면 큰 값을 장기적인 플레이 성향을 보려면 작은 값을 사용한다.
Redis HNSW 인덱스와 KNN 검색을 어떻게 구현할까?
다음 예시는 Redis Stack 7.x 계열에서 HASH 문서를 인덱싱하는 방식이다. DIM은 벡터 차원과 정확히 일치해야 하며 TYPE FLOAT32는 Node.js의 Float32Array와 잘 맞는다.
FT.CREATE idx:player_profile ON HASH PREFIX 1 player: SCHEMA \
  region TAG \
  mode TAG \
  queue_state TAG \
  mmr NUMERIC \
  ping_ms NUMERIC \
  style_vector VECTOR HNSW 10 \
    TYPE FLOAT32 \
    DIM 12 \
    DISTANCE_METRIC COSINE \
    M 16 \
    EF_CONSTRUCTION 200
플레이어 프로필을 기록할 때 벡터는 문자열 JSON이 아니라 바이너리 버퍼로 저장한다. Node.js의 redis 클라이언트를 사용한다면 다음처럼 작성할 수 있다.
const vector = new Float32Array(styleVector);
const binaryVector = Buffer.from(vector.buffer);

await redis.hSet(`player:${playerId}`, {
  region: "apnortheast2",
  mode: "ranked5v5",
  queue_state: "waiting",
  mmr: String(2025),
  ping_ms: String(18),
  style_vector: binaryVector,
});
매치 요청 시에는 지역, 모드, 대기 상태, MMR 범위를 먼저 필터링하고 KNN 검색을 수행한다. Redis 쿼리에서 AS vector_distance로 반환한 값은 거리이므로 낮을수록 유사하다.
const query = [
  "@region:{apnortheast2}",
  "@mode:{ranked5v5}",
  "@queue_state:{waiting}",
  "@mmr:[1875 2175]",
  "=>[KNN 80 @style_vector $vec AS vector_distance]",
].join(" ");

const result = await redis.ft.search("idx:player_profile", query, {
  PARAMS: { vec: Buffer.from(new Float32Array(styleVector).buffer) },
  SORTBY: "vector_distance",
  RETURN: ["mmr", "ping_ms", "vector_distance"],
  LIMIT: { from: 0, size: 80 },
  DIALECT: 2,
});
KNN 80은 최종적으로 필요한 인원보다 넉넉한 후보 풀이다. 5v5 매치에 10명이 필요하더라도 파티 제약, 중복 후보, 핑 제한을 적용하면 상당수가 제외될 수 있다. 실제 값은 동시 접속자 수, 필터 선택도, 목표 매칭 시간으로 부하 테스트해 결정한다.
벡터 유사도만으로 매치를 확정하면 왜 안 되는가?
코사인 거리만 최소화하면 성향은 비슷하지만 실력 차이가 큰 팀, 지연 시간이 높은 매치, 이미 다른 매치에 배정된 플레이어가 선택될 수 있다. 따라서 후보별 종합 비용을 계산해 낮은 비용의 조합을 선택해야 한다.
각 항의 예시는 다음과 같다.
| 항 | 의미 | 권장 처리 |
|---|---|---|
d_style | Redis가 반환한 코사인 거리 | 실제 반환 범위를 확인해 공통 척도로 정규화 |
d_mmr | 목표 MMR과의 절대 차이 | 허용 MMR로 나눠 정규화 |
d_ping | 예상 RTT 또는 서버 핑 | 상한 초과 시 제외 |
d_wait | 장기 대기 보상 | 오래 기다린 플레이어의 비용을 감소 |
대기 시간이 늘어날수록 MMR 허용 범위를 단계적으로 넓히는 정책도 필요하다. 단, 지역이나 핑 제한까지 동시에 느슨하게 하면 체감 품질이 급격히 나빠질 수 있다.
function allowedMmrGap(waitSeconds: number) {
  if (waitSeconds < 30) return 100;
  if (waitSeconds < 90) return 200;
  if (waitSeconds < 180) return 350;
  return 500;
}
성향 유사도는 같은 팀 구성에 특히 유용하지만 상대 팀 매칭에는 다른 목표가 적용될 수 있다. 예를 들어 양 팀의 평균 MMR과 파티 구성은 가깝게 유지하면서 각 팀 내부의 역할 분포가 한쪽으로 쏠리지 않게 해야 한다. 게임 장르에 따라 “비슷한 사람끼리”보다 “보완적인 역할끼리”가 더 좋은 경험을 만들 수도 있다.
실시간 매치메이킹을 구현하는 3단계
1. 큐 상태와 검색 인덱스를 분리한다
매치 대기열의 순서와 만료 처리는 Redis Sorted Set 또는 Streams가 적합하다. 반면 플레이어의 검색 가능한 프로필은 HASH와 RediSearch 인덱스에 둔다.
queue:ranked-5v5:ap-northeast-2: ZSET, score는 입장 시각player:{playerId}: HASH, 성향 벡터와 필터 속성match:reservation:{playerId}: 짧은 TTL의 예약 키
프로필의 queue_state를 waiting으로 바꾸고 대기열에 넣는 과정은 Lua 스크립트 또는 Redis Functions로 원자화할 수 있다. 이 문서의 여러 플레이어를 한 번에 예약하는 예제는 단일 Redis 인스턴스 기준이다. Redis Cluster에서는 스크립트가 접근하는 키를 입력 인자로 모두 선언해야 하며 단일 스크립트의 키들이 같은 hash slot에 있어야 한다. 사용자별 키가 서로 다른 slot에 있다면 매치메이커 파티션별 키 배치나 단계별 예약·보상 프로토콜을 설계해야 한다.
2. 후보를 찾고 서버 메모리에서 조합을 평가한다
Redis에는 후보 검색과 단순 필터를 맡긴다. 예를 들어 80~200명 정도의 후보를 받은 매치메이커 워커가 파티 크기, 역할 분포, 최근 재매칭 회피, 팀 MMR 편차를 계산해 10명 조합을 고를 수 있다. 후보 수와 파티 구성이 실제 처리량에 맞는지는 부하 테스트로 정한다.
이 단계에서 완전 탐색은 후보 수가 커질수록 비싸다. 우선 최근 대기 시간 순으로 시드 플레이어를 선택하고 비용이 낮은 후보부터 그리디하게 채운 뒤 일부 교환 탐색을 하는 방식으로 시작하는 것이 실용적이다.
3. 예약과 확정을 원자적으로 처리한다
검색 결과는 즉시 오래될 수 있다. 같은 플레이어를 두 워커가 동시에 선택하는 경쟁 조건을 막으려면 확정 직전에 모든 참가자를 예약해야 한다.
-- KEYS에는 {player hash, reservation key} 쌍을 전달하고,
-- ARGV[1]에는 생성할 match ID를 전달한다.
-- 단일 Redis 인스턴스를 전제로 한다. Cluster에서는 아래의 모든 KEYS를
-- 하나의 hash slot에 배치할 수 있도록 별도 키 설계가 필요하다.
for i = 1, #KEYS, 2 do
  local playerKey = KEYS[i]
  local reservationKey = KEYS[i + 1]
  if redis.call('HGET', playerKey, 'queue_state') ~= 'waiting' then
    return { err = 'NOT_WAITING' }
  end
  if redis.call('EXISTS', reservationKey) == 1 then
    return { err = 'ALREADY_RESERVED' }
  end
end

for i = 1, #KEYS, 2 do
  local playerKey = KEYS[i]
  local reservationKey = KEYS[i + 1]
  redis.call('SET', reservationKey, ARGV[1], 'EX', 10)
  redis.call('HSET', playerKey, 'queue_state', 'matched')
end

return 'OK'
예약 성공 후 게임 세션 생성에 실패하면 queue_state를 복구해야 한다. 이 보상 작업은 반드시 멱등하게 작성하고 예약 TTL이 만료된 매치를 감지하는 정리 작업도 둔다.
HNSW 파라미터는 어떤 기준으로 조정할까?
HNSW는 검색 속도와 정확도의 균형을 맞추는 근사 최근접 이웃 알고리즘이다. 정확한 값은 데이터 분포와 트래픽에 따라 달라지므로 고정된 정답은 없지만 다음 값으로 시작해 측정 기반으로 조정할 수 있다.
| 파라미터 | 역할 | 시작점 | 조정 방향 |
|---|---|---|---|
M | 노드당 연결 수 | 16 | 올리면 재현율과 메모리 사용량 증가 |
EF_CONSTRUCTION | 인덱스 생성 품질 | 200 | 올리면 빌드 시간과 품질 증가 |
EF_RUNTIME | 쿼리 탐색 폭 | 80~200 | 올리면 지연 시간과 재현율 증가 |
KNN k | Redis가 반환할 후보 수 | 80 | 후속 제약 탈락률이 높으면 증가 |
운영 지표는 평균 지연 시간만 보면 안 된다. p95·p99 검색 지연, 매치 성공률, 평균 대기 시간, 취소율, 재매칭률, 팀 MMR 편차, 매치 후 이탈률을 함께 추적해야 한다. 특히 벡터 검색 품질은 오프라인 재현율보다 실제 매치 완료율과 재큐율에 더 직접적으로 드러난다.
개인정보와 부정행위 위험은 어떻게 다룰까?
성향 벡터는 개인 식별자가 아니더라도 행동 패턴을 담은 프로필 데이터다. 원본 이벤트와 검색용 벡터의 보존 기간을 분리하고 매치메이커에는 플레이어 닉네임이나 결제 정보처럼 필요 없는 데이터를 전달하지 않는 것이 좋다.
- Redis ACL로 매치메이커 워커의 명령과 키 패턴을 제한한다.
- Redis 연결에는 TLS를 적용하고 인증 토큰은 Secret Manager에서 주입한다.
- 벡터 값과 MMR을 클라이언트가 직접 제출하지 못하게 한다.
- 비정상적인 행동 지표는 서버 권위 로그를 기준으로 계산한다.
- 원본 이벤트와 벡터 데이터에는 목적에 맞는 TTL 또는 삭제 정책을 둔다.
클라이언트가 벡터를 조작하면 원하는 상대나 팀원을 찾도록 시스템을 유도할 수 있다. 따라서 특징 추출은 신뢰 가능한 게임 서버 또는 검증된 분석 파이프라인에서만 실행해야 한다.
자주 묻는 질문 (FAQ)
Redis Vector Search가 PostgreSQL보다 매치메이킹에 항상 더 좋은가?
아니다. 관계형 데이터의 영속성, 분석 쿼리, 운영 도구는 PostgreSQL이 강점이다. Redis Vector Search는 대기열 근처의 최신 프로필을 저지연으로 KNN 검색해야 할 때 특히 적합하며 원본 데이터와 장기 분석은 별도 데이터베이스에 보관하는 구성이 일반적이다.
FLAT과 HNSW 중 무엇을 선택해야 하나?
후보 수가 작고 정확한 전수 검색이 필요하면 FLAT이 단순하다. 동시 대기자가 많거나 낮은 지연 시간이 중요한 실시간 매칭에는 대개 HNSW가 유리하다. 실제 후보 수와 목표 p99 지연 시간을 기준으로 두 인덱스를 벤치마크해야 한다.
벡터 차원은 높을수록 좋은가?
아니다. 차원이 늘면 메모리와 검색 비용이 증가하고 의미 없는 특징은 오히려 유사도를 흐릴 수 있다. 먼저 8~32개의 해석 가능한 특징으로 시작하고 매치 품질 지표를 보며 확장하는 편이 안전하다.
정리
Redis Vector Search는 플레이어 행동을 실시간 후보 검색에 활용할 수 있게 해 주지만 공정한 매치 자체를 자동으로 보장하지는 않는다. HNSW로 성향이 가까운 후보를 찾고 애플리케이션 계층에서 MMR·핑·파티·대기 시간·중복 예약을 엄격하게 처리하는 역할 분리가 안정적인 설계의 핵심이다.
처음에는 하나의 게임 모드와 12차원 내외의 행동 벡터로 시작하자. 이후 매치 성공률과 재큐율을 기준으로 특징, 가중치, HNSW 파라미터를 반복 조정하면 설명 가능하면서도 확장 가능한 AI 매치메이킹 시스템을 만들 수 있다.