Kube-Prometheus 기반 게임 서버 트래픽 급증 사전 예측과 K8s Pod 선제적 오토스케일링
Kube-Prometheus와 Prometheus Adapter로 게임 서버의 현재·예측 RPS를 수집하고 5분 뒤 트래픽 급증을 감지합니다. 예측값을 Kubernetes HPA 외부 메트릭으로 연결해 Pod를 미리 확장하고 데이터베이스·노드 병목까지 점검하는 실전 구성을 설명합니다.
핵심 요약
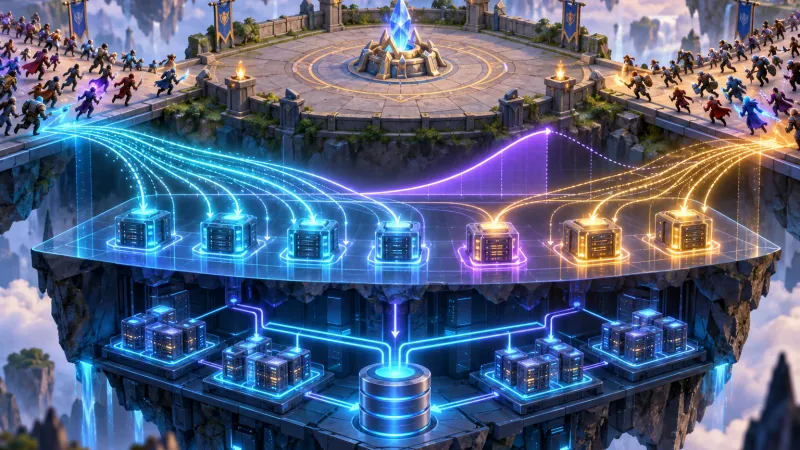
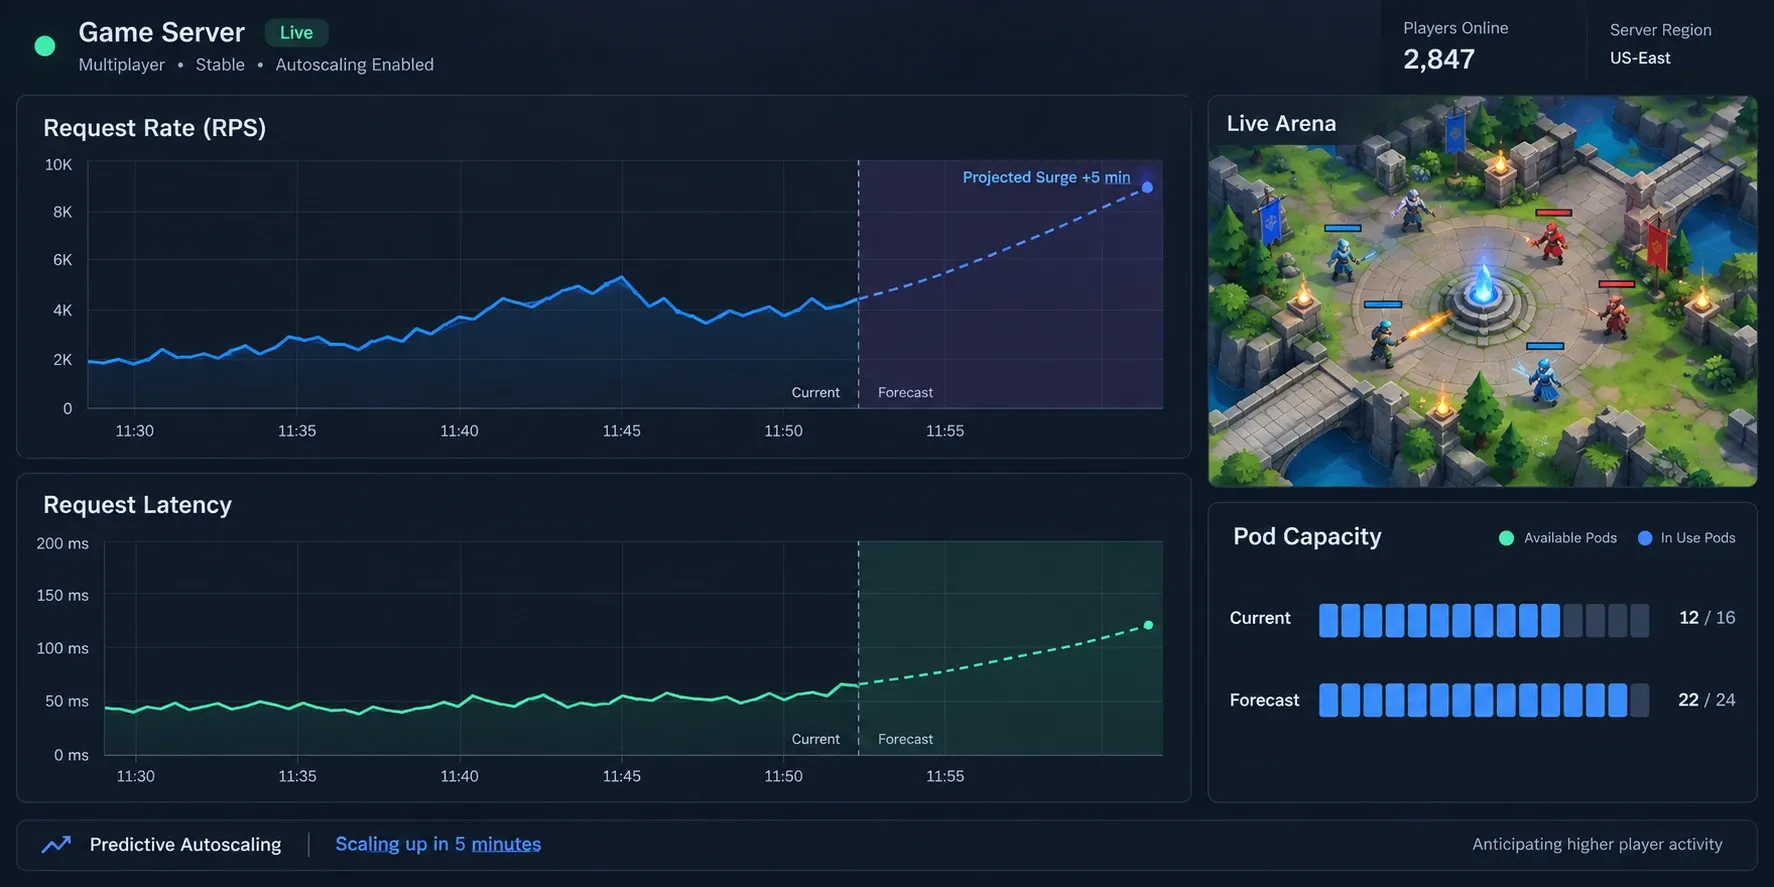
Kube-Prometheus의 Prometheus가 수집한 게임 서버 요청률을 rate()와 predict_linear()로 분석하면 현재 부하가 아니라 5분 뒤 예상 RPS를 계산할 수 있습니다. 이 값을 Prometheus Adapter의 External Metrics API로 노출하고 HPA의 목표 메트릭으로 사용하면 트래픽 급증 전에 게임 서버 Pod를 확장할 수 있습니다.
다만 predict_linear()는 머신러닝 모델이 아니라 최근 구간의 선형 회귀입니다. 급격한 스파이크가 발생하는 서비스에서는 예측 메트릭과 함께 minReplicas, 확장 정책, 쿨다운, 이벤트 기반 사전 확장을 조합해야 합니다.
게임 서버 트래픽 급증은 왜 장애로 이어지는가?
멀티플레이 게임 서버는 평균 트래픽보다 순간적인 변화율에 더 큰 영향을 받습니다. 신규 시즌 시작, 매치 이벤트, 스트리머 방송, 보상 지급 시간에는 로그인과 매치메이킹 요청이 짧은 시간에 집중될 수 있습니다.
이때 다음 문제가 연쇄적으로 발생합니다.
- 매치메이킹 API의 대기 시간이 증가한다.
- 세션 생성과 인증 요청이 연결 풀을 점유한다.
- Redis와 데이터베이스의 CPU 및 연결 수가 증가한다.
- 기존 Pod가 처리 중인 요청 때문에 타임아웃이 발생한다.
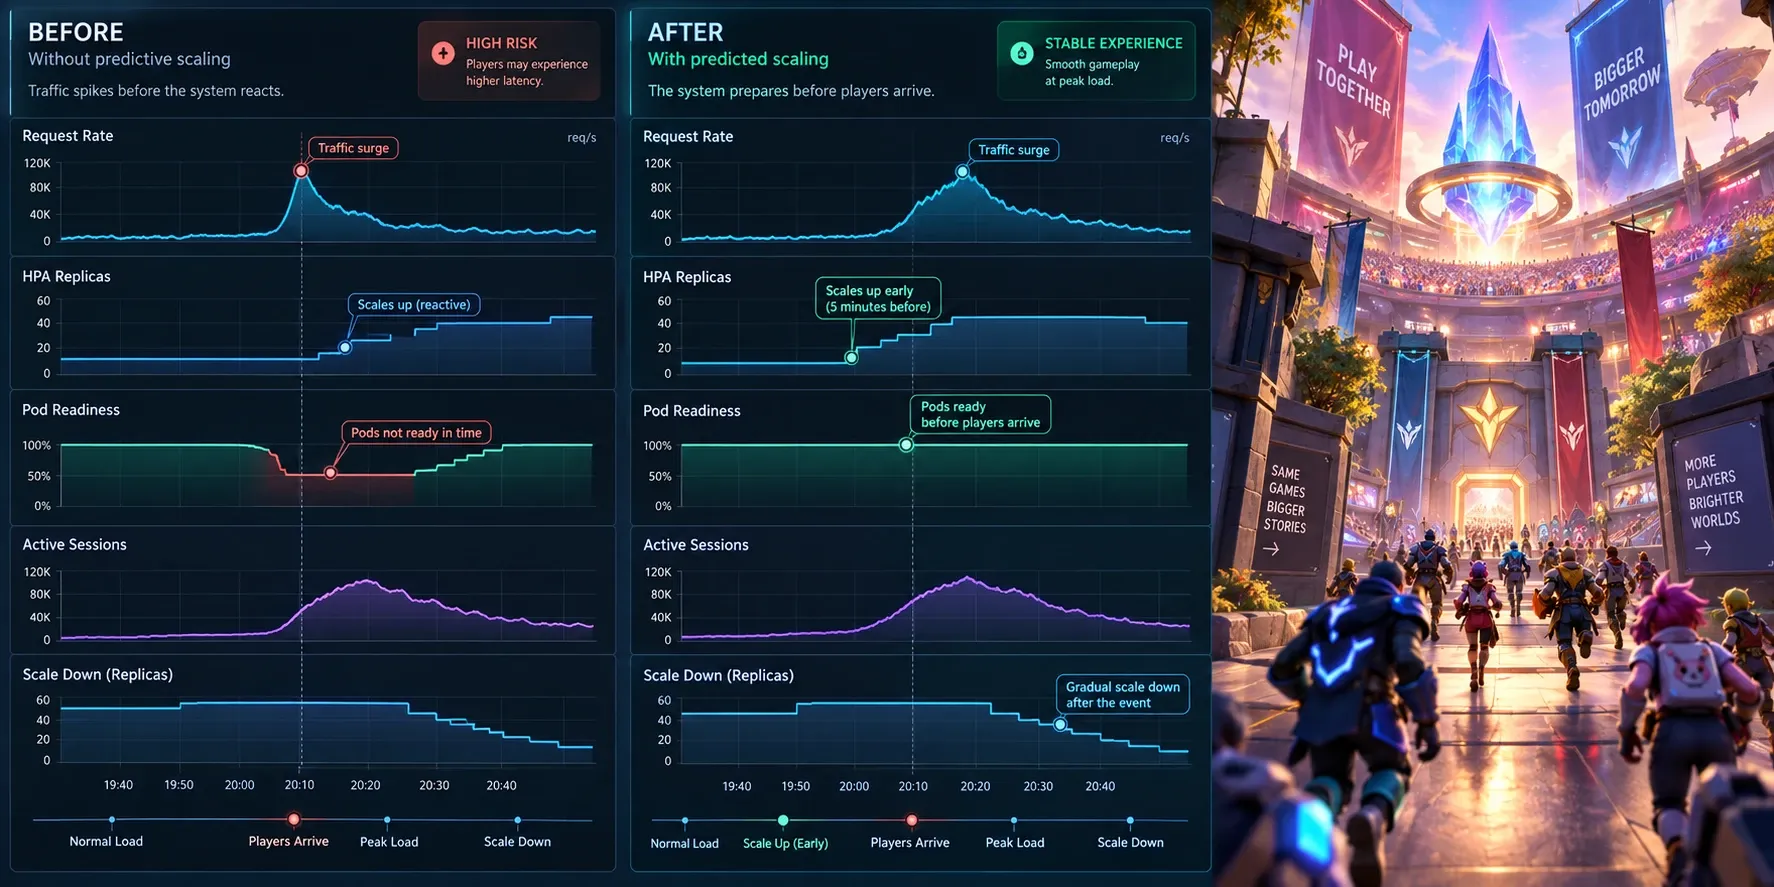
- HPA가 현재 메트릭을 확인한 뒤 확장하므로 새 Pod가 준비되기 전에 장애가 발생할 수 있다.
Kubernetes HPA는 기본적으로 관측된 현재 메트릭을 기반으로 동작합니다. Pod 생성, 이미지 다운로드, 애플리케이션 초기화, readiness probe 통과까지 수십 초에서 수분이 걸릴 수 있으므로 반응형 스케일링만으로는 갑작스러운 트래픽을 따라가기 어렵습니다.
예측형 오토스케일링은 어떤 원리로 동작하는가?
구성 요소별 책임을 분리하면 운영과 장애 분석이 쉬워집니다.
| 구성 요소 | 책임 | 예시 |
|---|---|---|
| 게임 서버 | Counter 메트릭 기록 | game_http_requests_total |
| kube-prometheus-stack | ServiceMonitor와 PrometheusRule 제공 | 메트릭 수집과 Recording Rule |
| Prometheus | 현재 요청률과 미래 예상값 계산 | rate(), predict_linear() |
| Prometheus Adapter | PromQL 결과를 Kubernetes 메트릭 API로 변환 | predicted_game_server_rps |
| HPA | 예측 RPS와 목표값 비교 | autoscaling/v2 |
| Cluster Autoscaler | Pod를 배치할 노드 용량 확보 | 노드 확장 |
flowchart LR
    A[게임 서버 요청] --> B[game_http_requests_total]
    B --> C[Prometheus rate]
    C --> D[5분 뒤 예측 RPS]
    D --> E[Prometheus Adapter]
    E --> F[HPA autoscaling/v2]
    F --> G[게임 서버 Pod 선제 확장]
예측 신호는 다음 두 가지를 함께 보는 것이 안전합니다.
current_rps: 현재 요청률predicted_rps_5m: 최근 추세를 기준으로 계산한 5분 뒤 요청률
실제 확장 신호는 현재값과 예측값 중 큰 값을 사용하도록 구성할 수 있습니다.
이렇게 하면 트래픽이 이미 급증한 상황에서 예측값이 낮게 계산되는 문제를 일부 완화할 수 있습니다.
어떤 게임 서버 메트릭을 수집해야 하는가?
CPU 사용률만 수집하면 네트워크 대기, 데이터베이스 병목, 큐 적체를 늦게 감지할 수 있습니다. 다음 메트릭을 함께 수집하는 것이 좋습니다.
| 메트릭 | 타입 | 용도 |
|---|---|---|
game_http_requests_total | Counter | API 요청률 계산 |
game_http_request_duration_seconds | Histogram | p95와 p99 지연 시간 확인 |
game_matchmaking_queue_depth | Gauge | 매치메이킹 적체 감지 |
game_active_sessions | Gauge | 세션 수와 Pod 용량 비교 |
game_db_pool_wait_seconds | Histogram | 데이터베이스 연결 대기 확인 |
game_server_ready | Gauge | 준비된 서버 수 확인 |
Counter는 요청이 발생할 때마다 증가시키고 Prometheus에서 rate()를 적용합니다. 원시 Counter를 남기면 프로세스 재시작 이후에도 Prometheus가 증가율을 계산할 수 있어 직접 RPS Gauge를 전송하는 방식보다 일반적으로 안전합니다.
Node.js 메트릭 수집 예시
import client from 'prom-client';

const register = new client.Registry();
client.collectDefaultMetrics({ register });

const requests = new client.Counter({
  name: 'game_http_requests_total',
  help: 'Total number of game server HTTP requests',
  labelNames: ['route', 'method', 'status'],
  registers: [register]
});

app.use((req, res, next) => {
  res.on('finish', () => {
    requests.inc({
      route: req.route?.path ?? 'unknown',
      method: req.method,
      status: String(res.statusCode)
    });
  });
  next();
});

app.get('/metrics', async (_req, res) => {
  res.set('Content-Type', register.contentType);
  res.end(await register.metrics());
});
route 라벨에 원본 URL 전체를 넣으면 사용자 ID나 세션 ID가 라벨에 포함되어 높은 카디널리티가 발생할 수 있습니다. /match/{id} 같은 동적 경로는 /match/:id처럼 템플릿 경로로 정규화해야 합니다.
Kube-Prometheus에서 메트릭을 수집하려면 어떻게 설정할까?
여기서는 Helm의 kube-prometheus-stack을 사용한다고 가정합니다. 애플리케이션 Service에 메트릭 포트를 선언하고 ServiceMonitor를 연결합니다.
Service와 ServiceMonitor
apiVersion: v1
kind: Service
metadata:
  name: game-server
  labels:
    app.kubernetes.io/name: game-server
spec:
  selector:
    app.kubernetes.io/name: game-server
  ports:
    - name: http
      port: 8080
      targetPort: http
    - name: metrics
      port: 9090
      targetPort: metrics
---
apiVersion: monitoring.coreos.com/v1
kind: ServiceMonitor
metadata:
  name: game-server
  labels:
    release: kube-prometheus-stack
spec:
  selector:
    matchLabels:
      app.kubernetes.io/name: game-server
  endpoints:
    - port: metrics
      path: /metrics
      interval: 15s
      scrapeTimeout: 10s
ServiceMonitor가 검색되려면 Prometheus 리소스의 serviceMonitorSelector와 네임스페이스 정책이 현재 라벨과 맞아야 합니다. Prometheus UI의 Status > Targets에서 수집 상태를 확인하고 다음 쿼리로 원시 메트릭을 검증합니다.
game_http_requests_total{namespace="game", job="game-server"}PromQL로 5분 뒤 요청률을 어떻게 예측할까?
먼저 Pod별 요청률을 합산합니다. scrape interval과 트래픽 변동성을 고려해 rate() 범위를 선택해야 합니다.
sum by (namespace) (
  rate(game_http_requests_total{
    namespace="game",
    route=~"/match|/session"
  }[5m])
)
최근 15분의 요청률을 사용해 300초 뒤 값을 선형 예측할 수 있습니다.
predict_linear(
  sum by (namespace) (
    rate(game_http_requests_total{
      namespace="game",
      route=~"/match|/session"
    }[5m])
  )[15m:15s],
  300
)predict_linear()는 최근 시계열에 선형 회귀를 적용합니다. 반복적인 일간 패턴이나 이벤트 캘린더를 반영하지 않으므로 예측값이 음수가 되지 않도록 clamp_min()을 함께 사용할 수 있습니다.
clamp_min(
  predict_linear(
    sum by (namespace) (
      rate(game_http_requests_total{namespace="game"}[5m])
    )[15m:15s],
    300
  ),
  0
)
Recording Rule로 예측값 고정하기
복잡한 PromQL을 HPA 요청마다 실행하지 않도록 Recording Rule을 사용합니다. 현재 RPS와 예측 RPS를 별도 시계열로 기록하면 대시보드, 알림, 오토스케일러가 같은 정의를 공유할 수 있습니다.
apiVersion: monitoring.coreos.com/v1
kind: PrometheusRule
metadata:
  name: game-server-predictive-scaling
  namespace: monitoring
  labels:
    release: kube-prometheus-stack
spec:
  groups:
    - name: game-server-scaling.rules
      interval: 15s
      rules:
        - record: game:current_rps
          expr: |
            sum by (namespace) (
              rate(game_http_requests_total{
                namespace="game",
                route=~"/match|/session"
              }[5m])
            )
        - record: game:predicted_rps_5m
          expr: |
            clamp_min(
              predict_linear(
                game:current_rps{namespace="game"}[15m:15s],
                300
              ),
              0
            )
        - record: game:scale_rps
          expr: |
            max by (namespace) (
              game:current_rps{namespace="game"}
              or
              game:predicted_rps_5m{namespace="game"}
)game:scale_rps는 네임스페이스 전체의 예상 요청률입니다. Prometheus Adapter에서 HPA가 읽을 수 있는 External Metric 이름으로 변환합니다.
Prometheus Adapter와 HPA를 어떻게 연결할까?
Prometheus Adapter는 Prometheus 시계열을 Kubernetes Custom Metrics API 또는 External Metrics API 형식으로 변환합니다. kube-prometheus-stack에 자동으로 포함된다고 가정하지 말고 별도로 설치하고 관리해야 합니다.
예측 RPS가 네임스페이스 전체의 값이고 특정 Pod에 귀속되지 않는다면 External Metric이 적합합니다. 다음은 Adapter 설정의 개념 예시입니다.
rules:
  external:
    - seriesQuery: 'game:scale_rps{namespace="game"}'
      resources:
        namespaced: false
      name:
        matches: '^game:scale_rps$'
        as: 'predicted_game_server_rps'
      metricsQuery: |
        max(game:scale_rps{namespace="game"})
실제 Helm chart에서는 values.yaml의 rules.external에 같은 규칙을 넣습니다. 설치한 chart 버전에 따라 필드 구조가 다를 수 있으므로 배포 후 API 응답을 직접 확인해야 합니다.
kubectl get --raw "/apis/external.metrics.k8s.io/v1beta1/namespaces/game/predicted_game_server_rps"응답이 없으면 다음 순서로 확인합니다.
- Prometheus에서
game:scale_rps{namespace="game"}가 조회되는지 확인합니다. - Prometheus Adapter 로그에서 규칙 파싱 오류와 Prometheus 연결 오류를 확인합니다.
APIService상태와 TLS 인증서 상태를 확인합니다.- HPA의 네임스페이스와 External Metric의 네임스페이스가 일치하는지 확인합니다.
예측 RPS 기준 HPA는 어떻게 구성할까?
Pod 하나가 안정적으로 처리할 수 있는 요청률을 부하 테스트로 측정한 뒤 목표값으로 설정합니다. Pod당 목표 처리량이 80 RPS라면 기대하는 replica 수는 다음과 같습니다.
예시 HPA는 다음과 같습니다.
apiVersion: autoscaling/v2
kind: HorizontalPodAutoscaler
metadata:
  name: game-server
  namespace: game
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: game-server
  minReplicas: 4
  maxReplicas: 80
  behavior:
    scaleUp:
      stabilizationWindowSeconds: 0
      selectPolicy: Max
      policies:
        - type: Percent
          value: 100
          periodSeconds: 60
        - type: Pods
          value: 20
          periodSeconds: 60
    scaleDown:
      stabilizationWindowSeconds: 300
      selectPolicy: Min
      policies:
        - type: Percent
          value: 20
          periodSeconds: 60
  metrics:
    - type: External
      external:
        metric:
          name: predicted_game_server_rps
        target:
          type: AverageValue
averageValue: "80"AverageValue는 현재 replicas를 기준으로 외부 메트릭의 평균값이 목표에 도달하도록 replicas를 조정합니다. 네임스페이스 전체 RPS를 Pod당 목표 RPS와 비교하는 구조입니다.
배포 후에는 다음 명령으로 HPA가 메트릭을 읽는지 확인합니다.
kubectl describe hpa game-server -n game
kubectl get hpa game-server -n game --watchminReplicas는 선제적 확장의 첫 번째 방어선입니다. 예측값이 아직 충분히 올라오지 않아도 최소 Pod를 유지해 준비 시간을 줄일 수 있습니다.
예측값의 오탐과 누락을 어떻게 줄일까?
선형 예측만 사용하면 짧은 비정상 상승이나 scrape 오류도 확장 신호로 해석할 수 있습니다. 다음 안전장치를 함께 적용합니다.
예측값에 상한과 하한 적용
잘못된 증가율로 replicas가 maxReplicas까지 급증하지 않도록 예측값에 상한을 둘 수 있습니다.
clamp_max(
  clamp_min(game:scale_rps{namespace="game"}, 0),
  6000
)
상한은 maxReplicas, 노드 용량, 데이터베이스 처리량을 기준으로 정해야 합니다.
여러 신호를 함께 사용
현재 RPS, 예측 RPS, 매치메이킹 큐 길이를 하나의 숫자로 억지로 합치기보다 HPA에 여러 메트릭을 제공하는 편이 안전합니다. HPA는 여러 메트릭 중 가장 큰 replica 요구량을 사용합니다.
metrics:
  - type: External
    external:
      metric:
        name: predicted_game_server_rps
      target:
        type: AverageValue
        averageValue: "80"
  - type: External
    external:
      metric:
        name: matchmaking_queue_depth
      target:
        type: AverageValue
        averageValue: "25"
전투 서버처럼 연결이 오래 유지되는 서비스는 HTTP RPS보다 활성 세션 수나 서버별 동시 접속자 수가 더 좋은 용량 지표일 수 있습니다.
축소에는 긴 안정화 시간 적용
확장은 즉시 수행하되 축소는 느리게 수행하는 비대칭 정책이 일반적으로 안전합니다. 게임 세션이 종료되기 전에 Pod를 줄이면 연결 재분배와 세션 손실이 발생할 수 있기 때문입니다.
scaleDown.stabilizationWindowSeconds를 길게 설정하고 애플리케이션의 graceful shutdown 시간을 terminationGracePeriodSeconds와 맞춰야 합니다. HPA replicas만 줄인다고 기존 플레이어 세션이 자동으로 안전하게 이동하지는 않습니다.
이벤트를 미리 아는 경우에는 어떤 방식이 좋은가?
시즌 오픈이나 사전 공지된 점검 종료처럼 트래픽 급증 시점을 알고 있다면 Prometheus 추세 예측보다 이벤트 기반 사전 확장이 더 정확할 수 있습니다.
| 상황 | 권장 방식 |
|---|---|
| 평소의 완만한 상승 | predict_linear() 기반 외부 메트릭 |
| 정해진 이벤트 시작 | 배포 파이프라인 또는 CronJob으로 minReplicas 조정 |
| 큐가 급격히 증가 | 큐 길이 External Metric 또는 KEDA |
| 세션 수가 용량을 결정 | 활성 세션 기반 메트릭 |
| 노드가 부족함 | Cluster Autoscaler 또는 노드 프로비저닝 |
예를 들어 이벤트 10분 전에 minReplicas를 20으로 올리고 이벤트 종료 후 천천히 되돌릴 수 있습니다. maxReplicas와 노드 그룹의 최대 용량도 이벤트 규모에 맞게 검토해야 합니다.
구현 절차: 게임 서버 선제적 오토스케일링
1단계. Pod당 처리 용량 측정
동일한 인스턴스 타입과 서버 설정으로 요청률별 p95·p99 응답 시간, 동시 매치 수, 데이터베이스 연결 대기 시간, Redis 지연 시간, CPU, 메모리, 네트워크 처리량을 측정합니다.
예측 구간은 Pod 시작 시간과 노드 프로비저닝 시간을 포함해야 합니다.
2단계. 메트릭 라벨 고정
route, region, game_mode처럼 운영상 필요한 라벨만 사용합니다. 사용자 ID, 매치 ID, 세션 ID는 라벨에 넣지 않아야 합니다.
3단계. Recording Rule 검증
Grafana에서 현재 RPS, 5분 뒤 예측 RPS, 실제 5분 뒤 RPS를 같은 시간축에 표시합니다. 예측값이 반복적으로 튀거나 scrape 누락 때 0으로 떨어지면 HPA에 연결하지 않습니다.
4단계. External Metrics API 검증
HPA보다 먼저 Adapter가 올바른 값을 반환하는지 확인합니다.
kubectl get apiservice | findstr external.metrics
kubectl get --raw "/apis/external.metrics.k8s.io/v1beta1/namespaces/game/predicted_game_server_rps"
Prometheus의 RPS 단위와 Kubernetes 메트릭 응답의 단위를 테스트 환경에서 반드시 확인해야 합니다.
5단계. HPA와 노드 용량 검증
HPA가 replicas를 늘려도 스케줄 가능한 CPU와 메모리가 없으면 Pod는 Pending 상태에 머뭅니다. 다음 항목을 함께 확인합니다.
- Deployment의 resource requests가 실제 용량을 반영하는가?
- 노드 그룹에 확장 가능한 최대 노드 수가 남아 있는가?
- 이미지 풀과 CNI 주소 고갈이 없는가?
- topology spread constraints 때문에 배치가 막히지 않는가?
- PodDisruptionBudget이 운영 작업을 지나치게 제한하지 않는가?
선제적 Pod 오토스케일링은 노드 오토스케일링보다 늦게 끝나면 효과가 없습니다. 이미지 사전 캐시, 여유 노드, 빠른 노드 부팅 또는 이벤트 시작 전 노드 워밍을 함께 고려해야 합니다.
알림과 롤백 기준은 어떻게 정할까?
자동 확장은 replicas 증가 자체가 아니라 사용자 경험 개선 여부로 평가해야 합니다. 다음과 같은 알림을 구성할 수 있습니다.
groups:
  - name: game-server-scaling.alerts
    rules:
      - alert: GameTrafficPredictionSpike
        expr: |
          game:predicted_rps_5m{namespace="game"}
          > 1.5 * game:current_rps{namespace="game"}
        for: 2m
        labels:
          severity: warning
        annotations:
          summary: '게임 서버 예측 트래픽 급증'
          description: '5분 뒤 예측 RPS가 현재 RPS보다 50% 이상 높습니다.'
      - alert: GameServerPodsPending
        expr: |
          sum(kube_pod_status_phase{
            namespace="game",
            phase="Pending"
          }) > 0
        for: 3m
        labels:
          severity: critical
다음 상황에서는 예측 메트릭을 비활성화하거나 설정을 롤백할 기준을 미리 정해야 합니다.
- 예측값이 실제값보다 반복적으로 크게 높아 비용이 급증한다.
- HPA가 짧은 시간에 확장과 축소를 반복한다.
- Pod는 늘었지만 데이터베이스나 Redis가 병목이 된다.
- External Metrics API 오류로 HPA 상태가
Unknown이 된다. - 예상보다 많은 Pod가 readiness에 실패한다.
예측 메트릭이 실패했을 때 CPU 기반 HPA까지 함께 중단되지 않도록 보조 메트릭과 안전한 minReplicas를 유지해야 합니다.
자주 묻는 질문 (FAQ)
predict_linear()만으로 머신러닝 기반 트래픽 예측이 가능한가?
아닙니다. predict_linear()는 최근 시계열에 선형 회귀를 적용하는 PromQL 함수입니다. 반복적인 일간 패턴이나 외부 이벤트를 반영하려면 별도의 예측 시스템이나 이벤트 스케줄러가 필요합니다.
Kube-Prometheus-Stack에 Prometheus Adapter가 포함되는가?
일반적으로 별도 설치가 필요합니다. Kube-Prometheus-Stack은 Prometheus와 Alertmanager, Grafana 및 Kubernetes 모니터링 리소스를 제공하지만 Adapter의 설치와 규칙 설정은 별도로 관리합니다.
게임 서버는 CPU 기반 HPA와 RPS 기반 HPA 중 무엇을 사용해야 하는가?
둘 중 하나만 고르기보다 RPS, 활성 세션 수, 큐 길이, CPU를 함께 검토하는 것이 안전합니다. 연결 유지와 틱 처리 중심의 서버는 활성 세션 수가 더 직접적인 용량 지표일 수 있고 API 서버는 RPS와 지연 시간이 더 적합할 수 있습니다.
정리
Kube-Prometheus 기반 선제적 오토스케일링의 핵심은 현재 부하 측정, 미래 부하 계산, Kubernetes External Metrics 변환, HPA 확장, 노드 용량 확보를 연결하는 것입니다.
rate()와 predict_linear()는 빠르게 시작할 수 있는 실용적인 기준선입니다. 하지만 부하 테스트로 Pod당 처리 용량을 정하고 예측 오차와 Pod 준비 시간을 측정한 뒤 minReplicas, maxReplicas, 확장·축소 정책, 데이터베이스 보호 장치를 함께 조정해야 합니다.
정해진 이벤트에는 이벤트 기반 사전 확장을 사용하고 불규칙한 상승에는 Prometheus 예측 메트릭을 적용하면 게임 플레이 중 트래픽 급증으로 인한 장애 가능성을 줄일 수 있습니다.