게임 텍스트 다국어화: UI 글자 수 초과를 해결하는 AI 자동 축약 파이프라인
게임 텍스트가 번역 후 UI 영역을 넘을 때 문맥과 플레이 의도를 보존하며 자동 축약하는 방법을 정리합니다. Unity와 Unreal에 적용할 수 있는 글자 수 측정, AI 프롬프트, 금칙어, 캐시, 검수와 롤백 파이프라인을 소개합니다.
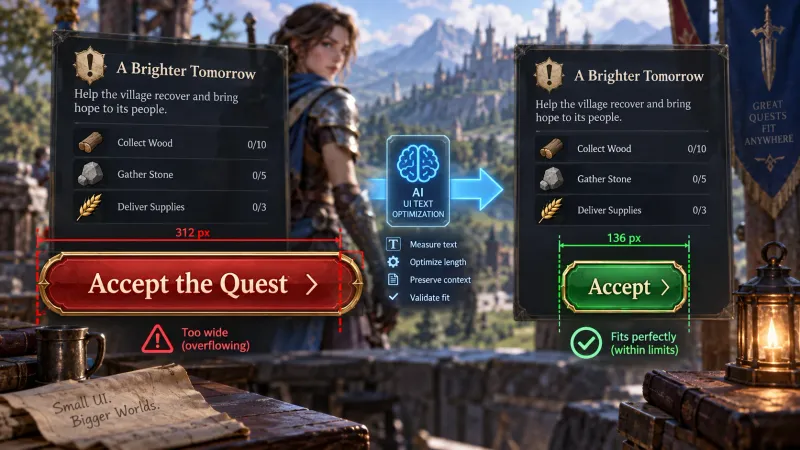
핵심 요약
게임 텍스트의 UI 초과 문제는 단순한 글자 수 제한이 아니라 언어별 렌더링 폭과 줄 수를 함께 판단해야 해결할 수 있습니다. locale, maxWidthPx, maxLines, mustKeepTerms, tone을 입력으로 받아 AI가 축약안을 만들고 게임 엔진의 실제 폰트로 다시 검증하는 방식이 안전합니다. 검증에 실패한 문구는 원문, 대체 문구, 수동 검수 큐로 분기해 런타임 오류를 막습니다.
게임 텍스트 다국어화에서 UI 글자 수 초과는 왜 발생하는가?
한국어 원문을 영어, 독일어, 프랑스어, 러시아어로 번역하면 같은 의미라도 문자열 길이와 렌더링 폭이 달라집니다. 특히 독일어처럼 복합 명사가 많은 언어는 버튼과 퀘스트 목록에서 쉽게 영역을 초과합니다.
문제는 문자 수와 화면에서 차지하는 폭이 같지 않다는 점입니다. 유니코드의 결합 문자와 이모지는 하나의 글자처럼 보이지만 여러 코드 포인트로 구성될 수 있습니다. 따라서 다음 세 가지를 분리해 관리해야 합니다.
| 기준 | 의미 | 권장 측정 방식 |
|---|---|---|
| 코드 포인트 수 | 유니코드 코드 포인트 개수 | 일반적인 길이 제한 보조값 |
| 그래핌 클러스터 수 | 사용자가 인식하는 문자 단위 | ICU 또는 유니코드 세그먼테이션 |
| 렌더링 폭 | 실제 화면에서 차지하는 픽셀 폭 | 엔진 폰트 측정 API |
Unity에서는 TextMeshPro의 GetPreferredValues()를 사용하고 Unreal Engine에서는 UTextBlock의 폰트와 레이아웃 계산 결과를 기준으로 판단하는 방식이 적합합니다. 웹 기반 툴에서는 Canvas 2D의 measureText()를 사용할 수 있지만 실제 게임 폰트와 동일한 조건인지 확인해야 합니다.
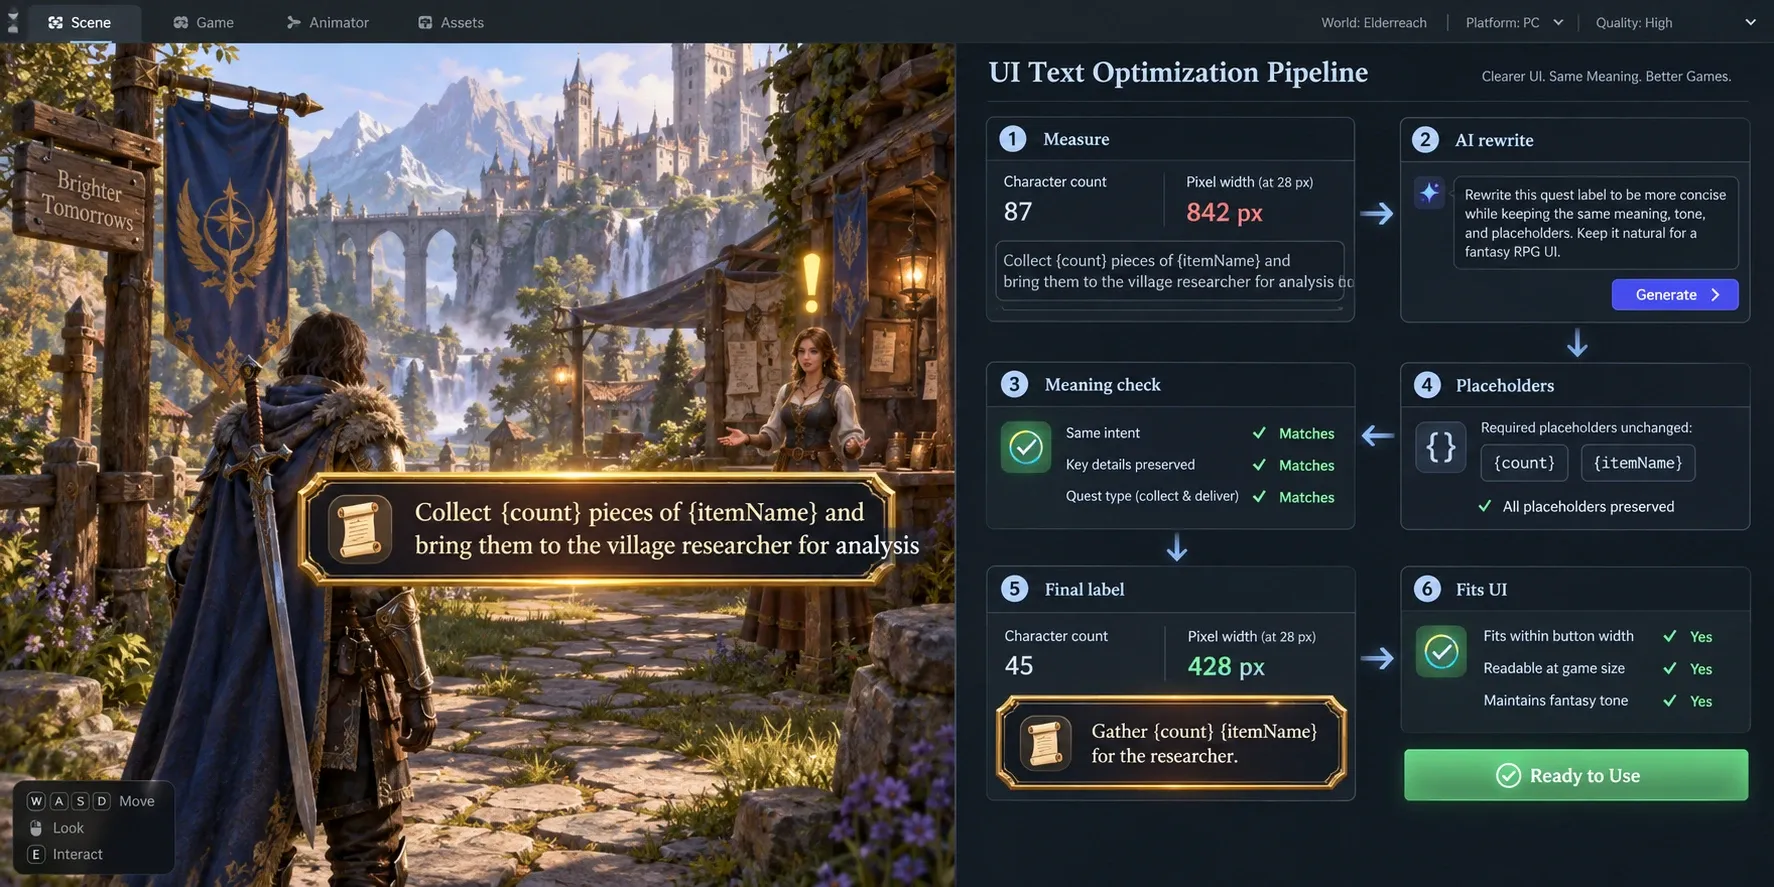
단순히 문자열을 자르는 방식이 위험한 이유
문자열을 최대 글자 수에서 잘라 ...을 붙이는 방식은 구현은 쉽지만 게임 디자인 정보를 손상시킵니다.
- 퀘스트 목표의 대상과 수량이 사라질 수 있습니다.
- 버튼의 행동 동사가 잘려 플레이어가 기능을 오해할 수 있습니다.
{playerName},{count},{itemName}같은 치환 변수가 깨질 수 있습니다.- 부정 표현이 사라져 의미가 반대로 바뀔 수 있습니다.
- 한국어와 일본어에서 조사 또는 존칭이 어색해질 수 있습니다.
- 접근성 기능인 스크린 리더와 음성 출력의 문장이 달라질 수 있습니다.
따라서 자동 축약은 문자열 자르기가 아니라 제약 조건을 가진 재작성으로 설계해야 합니다.
UI 맞춤형 AI 자동 축약은 어떻게 설계할까?
AI에 원문만 보내면 원하는 결과를 얻기 어렵습니다. UI 영역과 게임 문맥을 구조화한 요청 객체를 만들고 축약 결과를 다시 검증해야 합니다.
1단계: UI 영역을 픽셀과 줄 수로 정의한다
텍스트 영역의 조건을 다음과 같이 저장합니다.
type ShortenRequest = {
  sourceKey: string;
  locale: string;
  original: string;
  maxWidthPx: number;
  maxLines: number;
  fontProfile: string;
  tone: string;
  mustKeepTerms: string[];
  forbiddenChanges: string[];
};

const request: ShortenRequest = {
  sourceKey: 'quest.accept',
  locale: 'de-DE',
  original: 'Nimm die Belohnung für den abgeschlossenen Auftrag an',
  maxWidthPx: 260,
  maxLines: 1,
  fontProfile: 'UI_Sans_16',
  tone: 'direct',
  mustKeepTerms: ['Belohnung', 'Auftrag'],
  forbiddenChanges: ['Do not remove the action verb', 'Do not change quest state']
};maxWidthPx는 디바이스 해상도와 UI 스케일에 따라 달라질 수 있습니다. 같은 버튼이라도 16:9와 21:9 화면에서 실제 폭이 다르면 기준값을 UI 프리팹 또는 위젯 인스턴스에서 읽어야 합니다.
초과 판정의 예시 정책은 다음과 같습니다.
측정 폭이 임계값보다 작으면 원문을 사용하고 초과하면 축약을 요청합니다. 0.95는 여백을 위한 정책 예시이며 폰트 렌더링 방식과 UI 애니메이션에 따라 조정해야 합니다.
2단계: AI 요청에 보존해야 할 게임 정보를 명시한다
프롬프트에는 다음 항목을 포함합니다.
| 입력 항목 | 목적 | 예시 |
|---|---|---|
sourceKey | 동일 문구 추적과 캐시 | quest.accept |
locale | 언어별 어순과 문법 적용 | de-DE |
maxWidthPx | UI 영역 제약 전달 | 260 |
maxLines | 줄바꿈 제한 | 1 |
mustKeepTerms | 핵심 명사 보존 | 보상, 의뢰 |
forbiddenChanges | 상태와 의미 변경 방지 | 완료 상태 삭제 금지 |
tone | 게임의 말투 유지 | direct, polite |
시스템 지침은 다음처럼 구성할 수 있습니다.
You are a game localization editor.
Rewrite the localized string so it fits the specified UI constraints.
Preserve quest state, quantities, named entities, placeholders, and required terms.
Do not invent information. Do not remove the action verb.
Return only one candidate text and risk flags.
한국어로 작성하는 프로젝트라면 모델의 출력 언어와 문체를 명시해도 됩니다. 다만 프롬프트에 짧게 번역하라만 적는 것보다 금칙어와 보존 토큰을 별도 필드로 전달하는 편이 재현성이 높습니다.
3단계: 생성 결과를 엔진에서 다시 측정하고 승인한다
AI가 반환한 문장이 짧아 보여도 실제 폰트에서는 폭을 초과할 수 있습니다. 축약 결과는 반드시 게임 엔진의 폰트 프로필로 측정합니다.
function shouldAccept(
  text: string,
  measuredWidthPx: number,
  maxWidthPx: number,
  lineCount: number,
  maxLines: number,
  mustKeepTerms: string[]
): boolean {
  const termsArePresent = mustKeepTerms.every(term => text.includes(term));
  return measuredWidthPx <= maxWidthPx * 0.95 &&
    lineCount <= maxLines &&
    termsArePresent;
}
실제 구현에서는 mustKeepTerms의 단순 포함 여부만으로 충분하지 않을 수 있습니다. 변수 토큰, 숫자, HTML 태그, 리치 텍스트 마크업, 성별 문법 토큰을 각각 검사해야 합니다.
자동 축약 파이프라인은 어떤 순서로 동작해야 하는가?
flowchart TD
    A[번역 문자열 로드] --> B{UI 폭 초과?}
    B -->|아니오| C[원문 사용]
    B -->|예| D[문맥과 제약 조건 구성]
    D --> E[AI 축약 후보 생성]
    E --> F[토큰과 금칙어 검증]
    F --> G[게임 엔진 폰트로 폭 측정]
    G --> H{검증 통과?}
    H -->|예| I[캐시 저장 및 배포]
    H -->|아니오| J[재시도 또는 수동 검수]
권장 처리 순서는 다음과 같습니다.
- 번역 시스템에서
sourceKey와 로케일별 문자열을 가져옵니다. - TextMeshPro 또는 Unreal UMG의 실제 폰트 프로필로 폭과 줄 수를 측정합니다.
- 초과한 항목에만 UI 제약 조건과 게임 문맥을 붙여 AI에 전달합니다.
- AI 결과에서 변수 토큰, 숫자, 고유명사, 금칙어를 검증합니다.
- 검증을 통과한 결과를
sourceKey + locale + fontProfile + constraintVersion으로 캐시합니다. - 실패한 결과는 자동 재시도하거나 로컬라이제이션 담당자의 검수 큐로 보냅니다.
이 구조의 핵심은 AI를 런타임 의사결정자가 아니라 빌드 전 후보 생성기로 사용하는 것입니다. 플레이 중 네트워크 호출로 문구를 생성하면 응답 지연, 비용, 재현성, 오프라인 플레이 문제가 생길 수 있습니다.
어떤 문구를 보존하고 어떤 정보를 줄여야 하는가?
축약 우선순위는 게임 디자인 문맥에 따라 달라집니다. 일반적인 UI에서는 수식어와 반복 표현을 먼저 줄이고 행동과 결과를 마지막까지 보존합니다.
| 보존 우선순위 | 정보 유형 | 예시 |
|---|---|---|
| 1 | 행동 동사 | 수락, 장착, 판매, 추적 |
| 2 | 상태 변화 | 완료, 잠김, 부족함 |
| 3 | 핵심 대상 | 퀘스트 이름, 아이템 이름, NPC 이름 |
| 4 | 수량과 단위 | 3개, 20초, 500골드 |
| 5 | 조건 | 밤에만, 레벨 10 이상 |
| 6 | 수식어 | 새로운, 특별한, 현재 진행 중인 |
| 7 | 반복 안내 | 지금 바로 다시 한 번 |
예를 들어 현재 진행 중인 특별한 늑대 사냥 의뢰를 추적하기는 늑대 사냥 의뢰 추적처럼 줄일 수 있습니다. 반면 늑대 사냥 의뢰를 삭제하거나 추적을 수락으로 바꾸면 UI의 기능 의미가 달라집니다.
축약 품질을 평가할 때는 하나의 점수로 모든 것을 판단하기보다 다음 요소를 함께 기록하는 편이 좋습니다.
실무에서는 이 점수를 자동 승인 기준으로만 사용하고 최종 판단은 규칙 검증과 샘플 검수 결과를 함께 반영해야 합니다.
캐시와 버전 관리는 어떻게 해야 하는가?
같은 문구를 빌드할 때마다 AI에 다시 보내면 결과가 바뀔 수 있습니다. 다음 값을 캐시 키에 포함하면 결과를 재현하기 쉽습니다.
shorten-cache/{sourceKey}/{locale}/{fontProfile}/{constraintVersion}/{promptVersion}다음 상황에서는 캐시를 무효화해야 합니다.
- 원문 또는 번역문이 변경된 경우
- 폰트 파일이나 폰트 크기가 변경된 경우
- 위젯 폭과 최대 줄 수가 변경된 경우
- 프롬프트 또는 모델 버전이 변경된 경우
- 금칙어와 보존 용어 사전이 변경된 경우
승인된 축약문은 원문과 별도 필드로 저장하는 것이 좋습니다. 예를 들어 quest.accept.de-DE는 번역 원문을 유지하고 quest.accept.de-DE.compact에 UI용 후보를 저장합니다. 이렇게 하면 특정 화면에서만 짧은 문구를 사용하면서 스토리 로그와 음성 자막에는 전체 문장을 유지할 수 있습니다.
품질 검수와 안전장치는 무엇이 필요한가?
AI 자동화는 문장 생성보다 잘못된 결과를 차단하는 장치가 중요합니다.
- 변수 토큰 보존:
{count},{itemName},%s등의 개수와 이름을 비교합니다. - 숫자 검증: 원문에 있는 수량, 시간, 비용이 변경되지 않았는지 확인합니다.
- 금칙어 검증: 등급명, 스킬명, 세계관 고유명사를 사전과 대조합니다.
- 상태 검증:
완료,잠김,실패,사용 불가같은 상태어의 변경을 감지합니다. - 줄 수와 폭 검증: 엔진의 실제 폰트와 텍스트 쉐이더 조건에서 다시 측정합니다.
- 회귀 테스트: 주요 언어와 대표 UI 해상도를 조합해 스냅샷 테스트를 실행합니다.
- 롤백: 축약문이 실패하면 번역 원문 또는 사람이 승인한 대체 문구를 사용합니다.
특히 게임 경제와 퀘스트 UI에서는 숫자와 상태어의 변경을 가장 높은 위험으로 분류해야 합니다. 500 골드가 50 골드로 바뀌거나 구매 가능이 구매 불가로 바뀌면 문장 품질 문제가 아니라 게임 시스템 오류가 됩니다.
FAQ
AI가 축약한 문구를 런타임에 바로 사용해도 되나요?
가능하면 빌드 전 생성과 검증을 거친 뒤 로컬라이제이션 데이터에 포함하는 방식을 권장합니다. 런타임 생성은 네트워크 장애와 결과 변동성을 함께 처리해야 합니다.
글자 수 제한만으로 UI 초과를 막을 수 있나요?
어렵습니다. 언어와 폰트에 따라 같은 글자 수라도 렌더링 폭이 달라집니다. 그래핌 클러스터 수는 텍스트 분석에 사용하고 최종 판정은 실제 폰트의 픽셀 폭과 줄 수로 해야 합니다.
AI가 고유명사나 숫자를 바꾸면 어떻게 하나요?
mustKeepTerms와 변수 토큰 목록을 요청에 포함하고 결과에서 자동 비교합니다. 검증에 실패한 후보는 배포하지 말고 재생성 또는 수동 검수로 보냅니다.
정리
다국어 UI의 텍스트 초과 문제는 번역 담당자에게 무조건 더 짧게 써 달라고 요청하는 방식만으로 해결하기 어렵습니다. locale, 실제 폰트 폭, 최대 줄 수, 보존 용어, 게임 상태를 함께 전달하고 AI는 축약 후보를 생성하는 역할로 제한해야 합니다.
가장 안전한 구조는 측정 → 조건부 생성 → 토큰 검증 → 엔진 재측정 → 캐시 및 롤백의 반복 가능한 파이프라인입니다. 이 원칙을 적용하면 UI마다 필요한 길이에 맞춰 문구를 최적화하면서도 퀘스트 목표, 경제 수치, 플레이어 행동과 같은 핵심 게임 디자인 정보를 보호할 수 있습니다.