Event Sourcing 기반 인벤토리 로그 재생으로 상태 불일치 검증하는 운영 도구 설계
Event Sourcing으로 저장한 인벤토리 이벤트를 안전하게 재생하고 현재 프로젝션과 비교해 순번 누락·중복 처리·수량 불일치를 탐지하는 운영 도구 설계와 구현 절차를 정리합니다. PostgreSQL 스키마, 결정적 리플레이, 해시 검증, 권한 통제, 감사 로그까지 다룹니다.
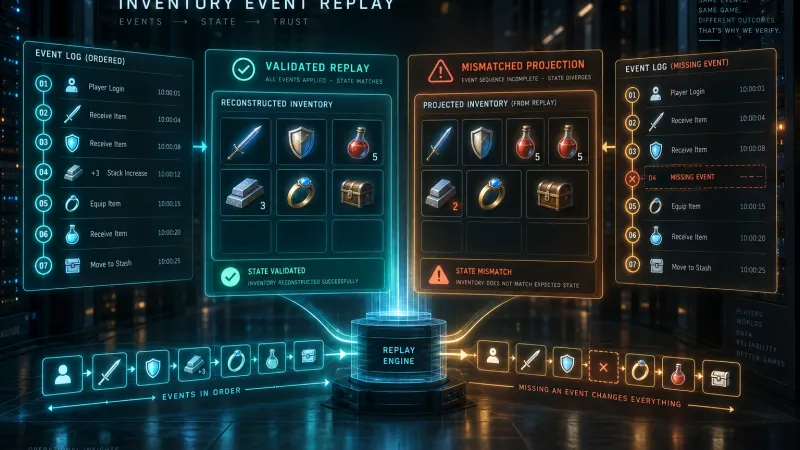
핵심 요약
Event Sourcing 기반 인벤토리는 현재 수량을 직접 저장하는 대신 ItemAdded, ItemRemoved 같은 도메인 이벤트를 순서대로 저장하고 이를 재생해 상태를 계산합니다. 운영 도구는 특정 사용자와 시점의 이벤트 로그를 결정적으로 재생한 뒤 현재 조회 프로젝션과 비교해 순번 누락, 중복 처리, 수량 불일치, 이벤트 무결성 오류를 찾아냅니다.
핵심은 리플레이를 쓰기 작업과 분리하고 aggregate_id별 순번과 해시 체인을 검증하며 동일한 입력 이벤트가 항상 같은 상태를 반환하도록 도메인 로직을 순수 함수에 가깝게 유지하는 것입니다.
인벤토리 상태 불일치는 왜 발생하는가?
멀티플레이 게임의 인벤토리는 여러 경로에서 동시에 변경됩니다.
- 게임 서버가 아이템 획득 이벤트를 기록한다.
- 거래 서버가 아이템을 차감한다.
- 우편이나 보상 시스템이 아이템을 지급한다.
- 재접속 처리나 네트워크 재전송으로 동일 요청이 다시 도착한다.
- 이벤트 저장은 성공했지만 조회용 프로젝션 갱신이 지연되거나 실패한다.
- 운영자가 복구 과정에서 일부 데이터를 직접 수정한다.
현재 수량만 저장하는 전통적인 테이블에서는 문제가 발생한 시점과 원인을 추적하기 어렵습니다. 반면 Event Sourcing은 상태를 만든 이벤트가 남기 때문에 특정 시점까지의 상태를 다시 계산할 수 있습니다.
다만 이벤트 로그가 있다고 해서 자동으로 문제가 해결되는 것은 아닙니다. 이벤트 순서가 보장되지 않거나 리플레이 코드가 운영 코드와 다르면 재생 결과 역시 신뢰할 수 없습니다.
Event Sourcing 로그 재생은 어떤 원리로 동작하는가?
인벤토리 상태를 다음과 같이 정의할 수 있습니다.
S_0은 빈 인벤토리 또는 검증된 스냅샷이고 E_n은 aggregate_id에 연결된 n번째 이벤트입니다. apply 함수가 이벤트 하나를 상태에 적용하면 마지막 상태 S_n을 얻습니다.
운영 도구는 이 결과를 현재 프로젝션의 상태와 비교합니다.
| 검증 대상 | 확인 방법 | 대표적인 오류 |
|---|---|---|
| 이벤트 순번 | sequence_no가 1씩 증가하는지 확인 | 이벤트 누락, 잘못된 정렬 |
| 이벤트 중복 | 이벤트 ID와 순번의 유일성 확인 | 재전송 중복 처리 |
| 수량 | 리플레이 결과와 조회 테이블 비교 | 지급·차감 불일치 |
| 스냅샷 | 스냅샷 버전 이후 이벤트만 재생 | 오래된 스냅샷 사용 |
| 해시 체인 | 이전 이벤트 해시와 현재 이벤트 해시 비교 | 로그 변조 또는 손상 |
| 비즈니스 규칙 | 음수 수량, 존재하지 않는 아이템 검사 | 잘못된 이벤트 기록 |
특정 시점의 상태를 검증할 때는 occurred_at만으로 정렬하지 않는 편이 안전합니다. 같은 시간에 기록된 이벤트가 있을 수 있으므로 상태 변경 순서는 aggregate_id 내부의 sequence_no를 기준으로 해야 합니다.
인벤토리 이벤트 저장소는 어떻게 설계할까?
다음은 PostgreSQL을 사용하는 간단한 이벤트 테이블 예시입니다. 실제 서비스에서는 테넌트 또는 shard 식별자, 이벤트 스키마 버전, 요청 멱등 키도 함께 저장하는 것이 좋습니다.
CREATE TABLE inventory_events (
    event_id uuid PRIMARY KEY,
    tenant_id text NOT NULL,
    aggregate_id uuid NOT NULL,
    sequence_no bigint NOT NULL,
    event_type text NOT NULL,
    schema_version integer NOT NULL,
    payload jsonb NOT NULL,
    occurred_at timestamptz NOT NULL,
    actor_id text NOT NULL,
    causation_id uuid,
    correlation_id uuid,
    idempotency_key text,
    prev_hash text,
    event_hash text NOT NULL,
    UNIQUE (tenant_id, aggregate_id, sequence_no),
    UNIQUE (tenant_id, idempotency_key)
);
이벤트를 추가할 때는 현재 마지막 순번과 클라이언트가 기대한 버전을 하나의 트랜잭션에서 비교해야 합니다. 예를 들어 클라이언트가 expected_version = 41을 보냈는데 저장소의 현재 버전이 42라면 낙관적 동시성 제어 오류로 요청을 거절합니다.
BEGIN;

-- Every writer for this aggregate must take the same transaction-scoped lock.
SELECT pg_advisory_xact_lock(
    hashtextextended($1::text || ':' || $2::text, 0)
);

SELECT COALESCE(MAX(sequence_no), 0) AS current_version
FROM inventory_events
WHERE tenant_id = $1 AND aggregate_id = $2;

-- current_version이 expected_version과 같을 때만 다음 이벤트를 INSERT

COMMIT;
운영 도구는 이 테이블에 이벤트를 추가하거나 수정하지 않아야 합니다. 검증 기능은 읽기 전용 데이터베이스 계정 또는 읽기 전용 리플리카를 사용하고 결과만 별도의 감사 테이블에 기록합니다.
결정적 리플레이어는 어떻게 구현할까?
리플레이어의 입력은 이벤트 목록과 시작 상태입니다. 시간, 난수, 외부 API, 현재 환율처럼 실행마다 달라지는 값을 apply 함수 내부에서 직접 읽으면 같은 로그를 재생해도 결과가 달라집니다.
따라서 이벤트에 필요한 값은 이벤트 payload에 포함하거나 명시적인 컨텍스트로 전달해야 합니다. 다음은 TypeScript로 작성한 단순한 리플레이 예시입니다.
type InventoryState = {
  version: number;
  items: Map<string, number>;
};

type InventoryEvent = {
  sequenceNo: number;
  type: 'ItemAdded' | 'ItemRemoved';
  payload: {
    itemId: string;
    quantity: number;
  };
};

function apply(state: InventoryState, event: InventoryEvent): InventoryState {
  if (event.payload.quantity <= 0) {
    throw new Error('quantity must be positive');
  }

  const nextItems = new Map(state.items);
  const current = nextItems.get(event.payload.itemId) ?? 0;

  if (event.type === 'ItemAdded') {
    nextItems.set(event.payload.itemId, current + event.payload.quantity);
  } else if (event.type === 'ItemRemoved') {
    const next = current - event.payload.quantity;
    if (next < 0) {
      throw new Error('inventory quantity cannot be negative');
    }
    nextItems.set(event.payload.itemId, next);
  } else {
    throw new Error(`unsupported event type: ${event.type}`);
  }

  return {
    version: event.sequenceNo,
    items: nextItems,
  };
}

function replay(events: InventoryEvent[], initial: InventoryState): InventoryState {
  let state = initial;

  for (const event of events) {
    if (event.sequenceNo !== state.version + 1) {
      throw new Error(`sequence gap at ${event.sequenceNo}`);
    }
    state = apply(state, event);
  }

  return state;
}
실제 구현에서는 이벤트 타입별 핸들러를 분리하고 알 수 없는 이벤트 타입을 조용히 무시하지 않아야 합니다. 알 수 없는 타입을 무시하면 리플레이 결과가 정상처럼 보이지만 실제 상태와 달라질 수 있습니다.
또한 Map 같은 자료구조는 결과 비교와 해시 계산 전에 정렬된 JSON 형태로 변환해야 합니다. 키 정렬 규칙이 실행 환경에 따라 달라지면 동일한 상태를 다르게 판단할 수 있습니다.
운영 검증 도구는 어떤 흐름으로 동작해야 할까?
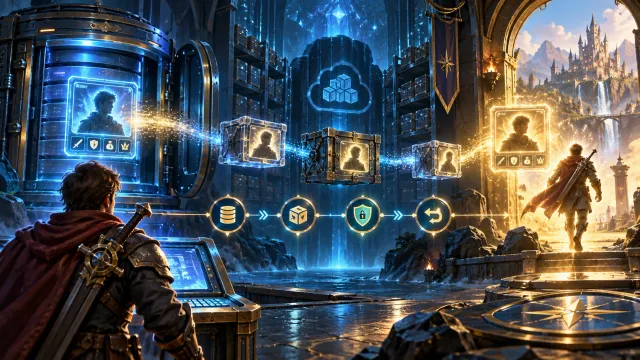
검증 도구는 다음 네 가지 영역으로 나누는 것이 관리하기 쉽습니다.
- 요청 검증: 운영자의 권한, 테넌트, 사용자 또는 aggregate 범위를 확인합니다.
- 이벤트 검증: 순번, 멱등 키, 해시 체인, 스키마 버전을 확인합니다.
- 상태 재생: 검증된 스냅샷과 이벤트를 읽기 전용으로 재생합니다.
- 결과 비교: 재생 상태와 현재 프로젝션을 비교하고 감사 가능한 리포트를 생성합니다.
flowchart LR
    A[운영자] --> B[검증 API]
    B --> C[권한 및 테넌트 확인]
    C --> D[스냅샷과 이벤트 읽기]
    D --> E[순번 및 해시 검증]
    E --> F[결정적 리플레이어]
    F --> G[현재 프로젝션과 비교]
    G --> H[검증 리포트와 감사 로그]
Step 1. 검증 범위를 고정한다
최소한 다음 입력을 받습니다.
tenant_idaggregate_id또는 플레이어 ID- 기준 순번 또는 기준 시각
- 사용할 스냅샷 버전
- 비교할 프로젝션 이름
대규모 전체 검사는 운영 DB에 부하를 줄 수 있으므로 플레이어 단위, shard 단위, 오류가 보고된 구간 단위로 실행하는 것이 안전합니다.
Step 2. 이벤트 연속성과 무결성을 확인한다
먼저 이벤트가 정상적인 순서인지 확인합니다.
해시 체인을 사용하는 경우에는 이벤트 payload, 타입, 순번, 이전 해시를 모호함 없이 결정적으로 직렬화한 뒤 해시를 계산합니다. 구현마다 canonical encoding 규칙을 고정해야 합니다.
해시만으로 운영자 접근 권한이나 원본 로그의 진위를 완전히 보장할 수는 없습니다. 해시 키 관리, 이벤트 저장소 권한, 감사 로그 보호 정책을 함께 설계해야 합니다.
Step 3. 스냅샷 이후 이벤트를 재생한다
스냅샷의 version이 1,000이면 1,001번 이벤트부터 재생합니다. 단, 스냅샷 자체의 무결성과 생성 시점도 확인해야 합니다.
SELECT sequence_no, event_type, schema_version, payload,
       occurred_at, prev_hash, event_hash
FROM inventory_events
WHERE tenant_id = $1
  AND aggregate_id = $2
  AND sequence_no > $3
  AND sequence_no <= $4
ORDER BY sequence_no ASC;
검증 도중 새 이벤트가 추가되면 비교 결과가 흔들릴 수 있습니다. 따라서 PostgreSQL의 일관된 트랜잭션 스냅샷을 사용하거나 검증 시작 시점의 마지막 순번을 end_sequence로 고정해야 합니다.
Step 4. 프로젝션과 차이를 구조화한다
문자열로 전체 JSON을 비교하면 원인을 파악하기 어렵습니다. 필드 단위 차이를 다음처럼 반환하는 편이 좋습니다.
{
  "aggregateId": "player-123",
  "replayedVersion": 1842,
  "projectedVersion": 1842,
  "status": "MISMATCH",
  "differences": [
    {
      "path": "items.item_sword.quantity",
      "expected": 3,
      "actual": 2,
      "reason": "projection missed ItemAdded at sequence 1837"
    }
  ]
}expected는 이벤트 재생 결과이고 actual은 현재 프로젝션 값입니다. 두 값의 의미를 코드와 API 문서에서 고정해야 운영자가 반대로 해석하지 않습니다.
리플레이 결과를 안전하게 운영에 적용하려면?
검증과 복구를 하나의 버튼으로 묶지 않는 것이 중요합니다. 검증 도구가 상태를 확인한 뒤 곧바로 보정 이벤트를 발행하면 잘못된 판단이 새로운 불일치를 만들 수 있습니다.
권장 운영 절차는 다음과 같습니다.
- 읽기 전용 검증을 실행하고 이벤트 구간과 차이를 저장합니다.
- 담당자가 원인과 영향 범위를 검토합니다.
- 보정이 필요하면 별도의 승인된 커맨드 또는 보정 이벤트를 생성합니다.
- 보정 이벤트를 다시 재생해 의도한 결과인지 확인합니다.
- 프로젝션을 재구축하고 동일 검증을 다시 실행합니다.
보정 이벤트에는 일반 이벤트와 구분되는 reason, ticket_id, approved_by 같은 메타데이터를 남기는 것이 좋습니다. 관리자 화면에서 수량을 직접 수정하는 방식은 이벤트 기록과 실제 상태가 분리되기 때문에 최후의 예외 처리로만 제한해야 합니다.
보안과 성능에서 놓치기 쉬운 부분은 무엇인가?
권한과 개인정보 보호
인벤토리 이벤트 payload에는 아이템, 결제, 거래 상대방, 내부 계정 식별자가 포함될 수 있습니다. 운영 도구에는 다음 통제를 적용합니다.
- RBAC로 조회 범위와 보정 권한을 분리합니다.
- 모든 요청에 운영자 ID, 사유, 티켓 ID를 남깁니다.
- 테넌트 조건을 API와 SQL 양쪽에서 강제합니다.
- 개인정보와 결제 관련 payload는 마스킹합니다.
- 대량 조회와 반복 리플레이에는 rate limit과 작업 큐를 적용합니다.
- 원본 이벤트를 브라우저에 그대로 전달하지 않고 필요한 차이만 반환합니다.
성능과 장애 격리
긴 이벤트 스트림을 매번 처음부터 재생하면 검증 비용이 커집니다. 스냅샷을 사용하되 스냅샷을 신뢰하는 것이 아니라 스냅샷 버전부터 이어지는 이벤트를 검증하는 방식으로 균형을 잡습니다.
운영 환경에서는 다음 지표를 수집할 수 있습니다.
| 지표 | 의미 |
|---|---|
| replay_duration_ms | 리플레이 소요 시간 |
| events_replayed | 재생한 이벤트 수 |
| mismatch_count | 필드 차이 개수 |
| invalid_event_count | 순번·해시·도메인 오류 이벤트 수 |
| projection_lag | 프로젝션 버전과 이벤트 버전의 차이 |
리플레이 작업은 웹 요청의 타임아웃에 묶지 않고 비동기 작업으로 실행하는 것이 안전합니다. 작업 상태를 QUEUED, RUNNING, COMPLETED, FAILED, MISMATCH처럼 명시하면 운영자가 실패와 불일치를 구분할 수 있습니다.
이벤트 스키마가 변경되면 과거 로그를 어떻게 재생할까?
이벤트 payload는 시간이 지나면서 변경됩니다. schema_version을 저장하고 리플레이 시 현재 도메인 모델로 변환하는 업캐스터를 둡니다.
예를 들어 ItemAdded 버전 1에 item_id와 quantity만 있었고 버전 2에서 source가 추가되었다면 버전 1 이벤트를 버전 2 형태로 변환합니다. 과거 이벤트를 일괄 수정하는 것보다 원본을 보존하고 읽기 시 변환하는 방식이 감사와 복구에 유리합니다.
단, 이벤트 의미 자체가 변경되면 단순한 필드 변환으로 해결되지 않습니다. 이 경우 새 이벤트 타입을 만들고 기존 타입의 해석 규칙을 유지해야 과거 상태를 재현할 수 있습니다.
자주 묻는 질문 FAQ
현재 인벤토리 테이블과 이벤트 로그가 다르면 어느 쪽이 정답인가요?
Event Sourcing을 원본 저장소로 정의했다면 이벤트를 결정적으로 재생한 결과를 기준 상태로 봅니다. 다만 이벤트 무결성 오류가 발견되면 즉시 정답을 단정하지 말고 저장 트랜잭션, 보정 이력, 프로젝션 처리 상태를 함께 조사해야 합니다.
이벤트를 시간순으로 정렬해 재생하면 안 되나요?
안 됩니다. occurred_at은 서버 간 시계 차이와 동일 타임스탬프 때문에 순서를 보장하지 않습니다. 하나의 aggregate 안에서는 저장소가 부여한 sequence_no를 사용해야 합니다.
리플레이 도구가 외부 API를 호출해도 되나요?
기본 검증 경로에서는 호출하지 않는 것이 좋습니다. 외부 API 응답이 바뀌면 같은 이벤트를 재생해도 결과가 달라지기 때문입니다. 필요한 외부 값은 이벤트에 저장하거나 검증 시점에 고정된 입력으로 주입해야 합니다.
정리
Event Sourcing 기반 인벤토리 운영 도구의 핵심은 이벤트를 다시 읽는 기능 자체가 아니라 재현 가능한 검증 절차입니다. aggregate_id별 순번을 강제하고 이벤트 무결성을 확인한 뒤 결정적 리플레이어로 상태를 계산해야 현재 프로젝션과의 차이를 신뢰할 수 있습니다.
운영 환경에서는 읽기 전용 실행, 테넌트 격리, 권한 분리, 감사 로그, 비동기 작업, 스키마 버전 관리까지 함께 설계해야 합니다. 이 구조를 갖추면 인벤토리 불일치를 단순한 고객 문의가 아니라 특정 이벤트와 프로젝션 처리 단계로 좁혀 조사할 수 있습니다.