대규모 리더보드 스냅샷 생성 중 순위 일관성을 유지하는 읽기 모델 설계
대규모 리더보드에서 스냅샷 생성 중 순위가 흔들리는 원인을 분석하고 워터마크·결정적 정렬 키·불변 읽기 모델로 페이지 간 일관성과 재현 가능한 시즌 결과를 보장하는 서버 설계, 검증, 장애 재시도 전략까지 실무 예제와 함께 다룹니다.
핵심 요약
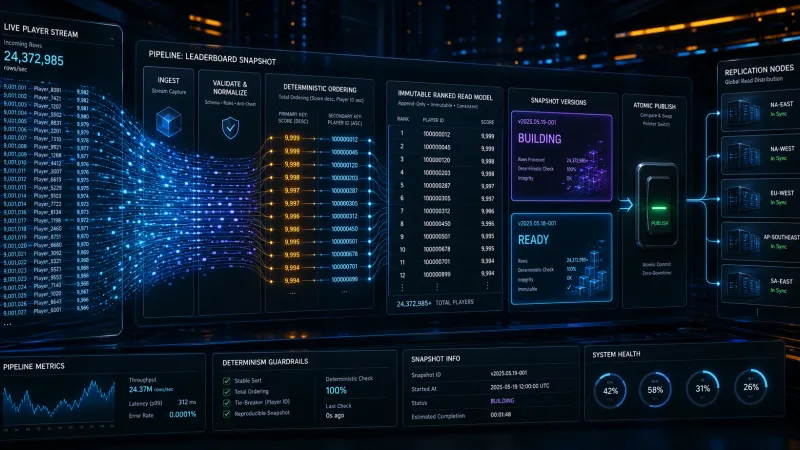
대규모 리더보드의 순위 일관성은 실시간 테이블을 페이지별로 다시 조회하지 않고 하나의 기준 시점인 cut_seq를 먼저 확정한 뒤 그 시점까지의 데이터를 읽는 방식으로 보장할 수 있습니다. 스냅샷에는 결정적인 정렬 키와 snapshot_id를 부여하고 생성이 끝난 불변 읽기 모델만 클라이언트에 노출하면 생성 중 점수 변경이나 복제 지연으로 순위가 흔들리지 않습니다.
대규모 리더보드 스냅샷에서 순위가 왜 흔들리는가?
리더보드가 작을 때는 다음과 같은 단순한 조회로 충분해 보입니다.
SELECT player_id, score
FROM leaderboard
ORDER BY score DESC
LIMIT 100 OFFSET 1000;
하지만 수백만 명의 플레이어를 여러 페이지로 내보내거나 시즌 종료 보상을 계산할 때는 이 쿼리만으로 일관된 결과를 보장하기 어렵습니다.
첫 번째 페이지를 읽은 뒤 두 번째 페이지를 읽기 전에 점수가 갱신되면 OFFSET의 기준 위치가 바뀝니다. 어떤 플레이어는 두 페이지에 중복으로 나타나고 다른 플레이어는 누락될 수 있습니다. 읽기 전용 복제본을 사용하면 페이지마다 서로 다른 복제 지점의 데이터를 읽는 문제도 생깁니다.
동점 점수 처리도 별도 문제입니다. ORDER BY score DESC만 사용하면 데이터베이스가 같은 점수 행의 순서를 보장하지 않습니다. 실행 계획이나 인덱스 상태가 바뀔 때 같은 플레이어가 페이지 경계를 넘나들 수 있습니다.
| 원인 | 발생하는 현상 | 설계에서 필요한 대응 |
|---|---|---|
| 생성 중 점수 갱신 | 페이지마다 기준 시점이 다름 | 스냅샷 워터마크 고정 |
| 동점 점수 | 동일 점수의 순서가 비결정적임 | 유일한 tie-breaker 추가 |
| 읽기 복제 지연 | 요청마다 다른 데이터가 보임 | 스냅샷 전용 읽기 모델 사용 |
OFFSET 페이지네이션 | 삽입·갱신 시 중복 또는 누락 | 커서 또는 사전 계산된 순위 사용 |
| 비동기 집계 지연 | 원장과 순위 모델의 상태가 다름 | 이벤트 순서와 적용 지점 기록 |
일관된 순위를 위한 읽기 모델의 핵심 원칙은 무엇인가?
1. 기준 시점 cut_seq를 먼저 확정한다
점수 변경을 이벤트 스트림이나 순서가 증가하는 트랜잭션 로그로 관리한다고 가정해 보겠습니다. 스냅샷 작업을 시작할 때 현재까지 확정된 마지막 이벤트 번호를 읽어 cut_seq로 저장합니다.
스냅샷의 의미는 다음과 같이 정의합니다.
이 스냅샷은 이벤트 순서가
cut_seq이하인 변경만 반영한다.
스냅샷 생성 도중 새로운 점수가 기록되어도 이벤트 순서가 cut_seq보다 크면 현재 스냅샷에는 포함하지 않습니다. 다음 스냅샷에서 반영하면 됩니다.
이 방식은 데이터베이스 종류와 관계없이 적용할 수 있지만 cut_seq가 실제로 단조 증가하고 모든 점수 변경에 연결되어 있어야 합니다. 애플리케이션 서버의 시각이나 updated_at만 기준으로 삼는 것은 피하는 편이 좋습니다. 서버 시계가 어긋날 수 있고 같은 시각에 발생한 변경의 순서도 판별하기 어렵기 때문입니다.
2. 순위 정렬 키를 결정적으로 만든다
순위는 점수 하나가 아니라 전체 정렬 키로 정의해야 합니다. 예를 들어 점수가 높은 순서, 동점이면 먼저 달성한 시각, 그래도 같으면 플레이어 ID가 작은 순서로 정렬할 수 있습니다.
데이터베이스에서는 다음처럼 모든 정렬 기준을 명시합니다.
ORDER BY
  score DESC,
  achieved_at ASC,
player_id ASCplayer_id처럼 유일한 마지막 키가 있어야 두 행의 정렬 순서가 항상 하나로 결정됩니다. 동점 규칙이 게임 기획과 다르면 achieved_at 대신 시즌 시작 후 누적 시간, 승리 수, 먼저 서버에 접수된 이벤트 번호 등을 사용할 수 있습니다. 중요한 것은 규칙을 문서화하고 쓰기 모델과 읽기 모델에서 동일하게 계산하는 것입니다.
3. 생성 중인 상태와 공개된 상태를 분리한다
읽기 모델은 다음과 같은 상태를 갖도록 설계할 수 있습니다.
| 필드 | 의미 |
|---|---|
snapshot_id | 외부에서 참조할 불변 스냅샷 식별자 |
cut_seq | 스냅샷에 포함된 마지막 이벤트 순서 |
status | building, ready, failed 등 생성 상태 |
row_count | 생성된 행 수 검증용 개수 |
checksum | 결과 무결성 검증용 해시 또는 체크섬 |
created_at | 스냅샷 생성 시각 |
클라이언트는 status = ready인 스냅샷만 읽습니다. 새 스냅샷이 완성되면 메타데이터의 published_snapshot_id를 한 번의 원자적 갱신으로 교체합니다. 그러면 클라이언트가 보는 데이터는 이전 스냅샷 전체이거나 새 스냅샷 전체이지 중간 결과가 아닙니다.
flowchart LR
    A[점수 이벤트] --> B[정렬·집계 읽기 모델]
    B --> C[cut_seq 확정]
    C --> D[임시 스냅샷 생성]
    D --> E{검증 통과?}
    E -- 예 --> F[status=ready]
    F --> G[published_snapshot_id 원자 교체]
    E -- 아니오 --> H[failed 기록 및 재시도]
    G --> I[클라이언트 조회]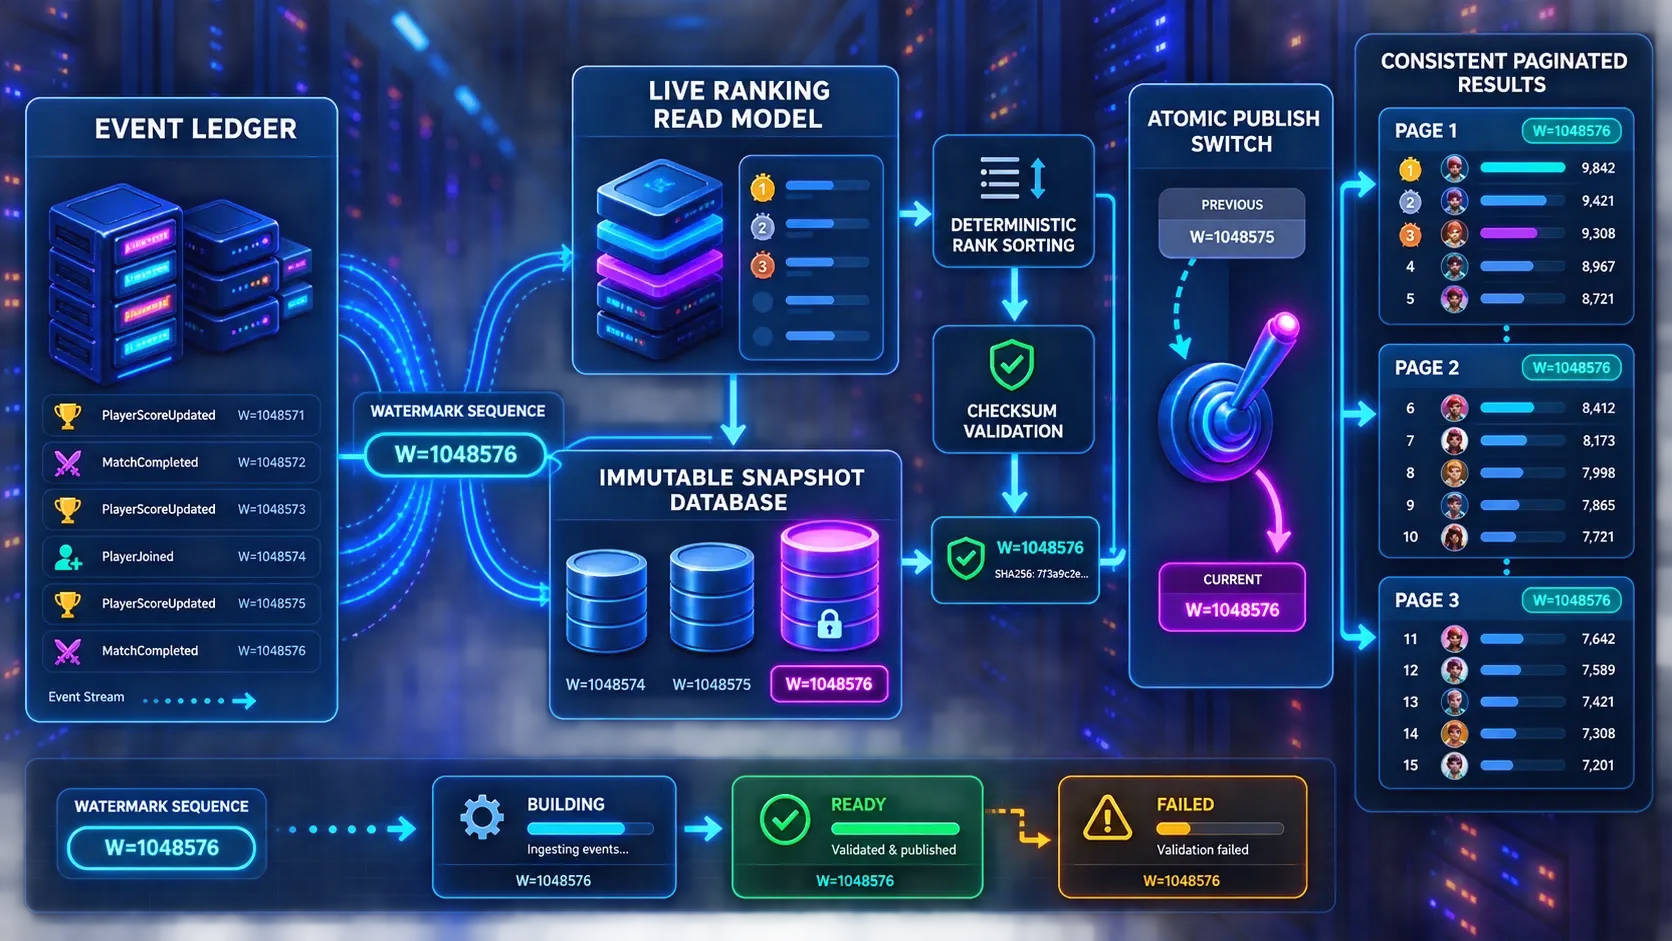
읽기 모델은 어떻게 구성할까?
가장 이해하기 쉬운 구성은 이벤트 원장, cut_seq 시점 조회가 가능한 버전형 순위 읽기 모델, 불변 스냅샷을 분리하는 것입니다. 현재 상태만 덮어쓰는 최신값 테이블만으로는 과거 시점의 순위를 재구성할 수 없습니다.
CREATE TABLE leaderboard_snapshot_meta (
  snapshot_id  BIGINT PRIMARY KEY,
  season_id    BIGINT NOT NULL,
  cut_seq      BIGINT NOT NULL,
  status       VARCHAR(16) NOT NULL,
  row_count    BIGINT,
  checksum     VARCHAR(128),
  created_at   TIMESTAMP NOT NULL,
  published_at TIMESTAMP NULL
);

CREATE TABLE leaderboard_snapshot_row (
  snapshot_id  BIGINT NOT NULL,
  rank         BIGINT NOT NULL,
  player_id    BIGINT NOT NULL,
  score        BIGINT NOT NULL,
  achieved_at  TIMESTAMP NOT NULL,
  PRIMARY KEY (snapshot_id, rank),
  UNIQUE (snapshot_id, player_id)
);

CREATE TABLE season_leaderboard_pointer (
  season_id             BIGINT PRIMARY KEY,
  published_snapshot_id BIGINT NOT NULL
);

CREATE INDEX idx_snapshot_player
ON leaderboard_snapshot_row (snapshot_id, player_id);

CREATE TABLE leaderboard_read_model_history (
  season_id       BIGINT NOT NULL,
  player_id       BIGINT NOT NULL,
  valid_from_seq  BIGINT NOT NULL,
  score           BIGINT NOT NULL,
  achieved_at     TIMESTAMP NOT NULL,
  is_active       BOOLEAN NOT NULL,
  PRIMARY KEY (season_id, player_id, valid_from_seq)
);rank를 스냅샷 생성 시점에 미리 저장하면 조회 시점에 대규모 COUNT(*)나 윈도 함수로 순위를 다시 계산할 필요가 없습니다. 다만 순위 번호 자체를 저장할 때는 동점 정책을 먼저 결정해야 합니다.
- 경쟁 순위:
1, 1, 3 - 밀집 순위:
1, 1, 2 - 고유 순위:
1, 2, 3
게임 보상처럼 순위 구간이 중요하다면 일반적으로 고유 정렬 키를 기반으로 한 고유 순위가 운영하기 쉽습니다. 동점자에게 같은 보상을 지급해야 한다면 rank와 별도로 competition_rank를 저장해 표현을 분리할 수 있습니다.
대용량 스냅샷 생성은 어떤 순서로 구현할까?
1단계: 스냅샷 메타데이터와 워터마크를 원자적으로 기록한다
먼저 시즌별 중복 생성을 막고 cut_seq를 한 번만 확정합니다. 이벤트 저장소가 PostgreSQL이라면 메타데이터 잠금과 워터마크 조회를 같은 트랜잭션에서 처리할 수 있습니다. 이벤트 스트림을 사용한다면 소비자가 마지막으로 성공 처리한 순서를 기준으로 삼고 생성 작업에 그 값을 명시적으로 전달합니다.
BEGIN;

SELECT pg_advisory_xact_lock(:season_lock_key);

INSERT INTO leaderboard_snapshot_meta (
  snapshot_id, season_id, cut_seq, status, created_at
)
VALUES (
  :snapshot_id, :season_id, :cut_seq, 'building', CURRENT_TIMESTAMP
);

COMMIT;
여기서 cut_seq는 애플리케이션이 임의로 추정하지 않고 이벤트 저장소의 확정된 위치에서 가져와야 합니다.
2단계: 임시 테이블에 정렬 결과를 기록한다
대규모 데이터는 한 번에 메모리에 적재하지 말고 스트리밍 방식으로 읽습니다. PostgreSQL에서는 COPY나 서버 측 커서를 사용할 수 있고 분산 데이터베이스에서는 파티션별 범위 스캔과 외부 정렬을 사용할 수 있습니다.
버전형 읽기 모델에서 각 플레이어의 cut_seq 시점 최신 상태를 고른 뒤 정렬 키를 계산합니다. 현재 상태만 보관하는 테이블은 cut_seq 이후 갱신된 플레이어의 과거 점수를 복구할 수 없으므로 이 쿼리의 원본으로 쓸 수 없습니다.
WITH state_at_cut AS (
  SELECT
    player_id,
    score,
    achieved_at,
    is_active,
    ROW_NUMBER() OVER (
      PARTITION BY player_id ORDER BY valid_from_seq DESC
    ) AS version_rank
  FROM leaderboard_read_model_history
  WHERE season_id = :season_id
    AND valid_from_seq <= :cut_seq
)
INSERT INTO leaderboard_snapshot_row (
  snapshot_id, rank, player_id, score, achieved_at
)
SELECT
  :snapshot_id,
  ROW_NUMBER() OVER (
    ORDER BY score DESC, achieved_at ASC, player_id ASC
  ) AS rank,
  player_id,
  score,
  achieved_at
FROM state_at_cut
WHERE version_rank = 1
  AND is_active = TRUE;
위 쿼리는 valid_from_seq가 해당 플레이어 상태를 만든 마지막 이벤트 순서를 나타내는 이력 테이블을 전제로 합니다. 이벤트를 직접 합산하는 구조라면 cut_seq 이하 이벤트만 집계해야 하며 읽기 모델의 last_applied_seq가 cut_seq에 도달하지 않은 경우 스냅샷을 완성하면 안 됩니다.
즉 다음 조건을 별도로 확인해야 합니다.
read_model_applied_seq >= cut_seq이 조건을 만족하지 않으면 원장에는 존재하지만 읽기 모델에는 아직 반영되지 않은 점수가 생깁니다. 그런 상태에서 스냅샷을 만들면 순위가 일관되더라도 최신 기준 시점의 완전한 결과가 아닙니다.
3단계: 행 수와 정렬 규칙을 검증한 뒤 공개한다
생성이 끝나면 다음 검증을 수행합니다.
- 예상 플레이어 수와 실제
row_count를 비교합니다. snapshot_id안에서player_id가 중복되지 않는지 확인합니다.- 인접한 행의 정렬 키가 역전되지 않았는지 확인합니다.
- 읽기 모델의 적용 순서가
cut_seq이상인지 확인합니다. - 필요하면
(player_id, score, rank)목록으로 체크섬을 계산합니다.
검증이 끝난 뒤에만 상태를 ready로 바꾸고 공개 포인터를 교체합니다.
BEGIN;

WITH ready AS (
  UPDATE leaderboard_snapshot_meta
  SET status = 'ready',
      row_count = :row_count,
      checksum = :checksum,
      published_at = CURRENT_TIMESTAMP
  WHERE snapshot_id = :snapshot_id
    AND status = 'building'
  RETURNING snapshot_id
)
INSERT INTO season_leaderboard_pointer (season_id, published_snapshot_id)
SELECT :season_id, snapshot_id FROM ready
ON CONFLICT (season_id) DO UPDATE
SET published_snapshot_id = EXCLUDED.published_snapshot_id;

-- 애플리케이션은 영향 행이 1개인지 확인하고, 아니면 롤백한다.
COMMIT;
실제 운영에서는 두 갱신이 같은 데이터베이스에 있거나 하나의 버전 매니페스트를 원자적으로 교체할 수 있어야 합니다. 서로 다른 저장소를 사용한다면 ready 상태와 공개 포인터 사이에 불일치가 생길 수 있으므로 매니페스트 버전이나 데이터베이스 트랜잭션 아웃박스 같은 조정 장치를 추가해야 합니다.
클라이언트 조회는 snapshot_id를 어떻게 사용해야 할까?
클라이언트가 첫 요청에서 현재 공개된 snapshot_id를 받고 이후 요청마다 그 값을 보내도록 하면 페이지 간 일관성을 명시적으로 유지할 수 있습니다.
GET /seasons/42/leaderboard?limit=100

200 OK
{
  "snapshot_id": 9812,
  "cut_seq": 73482910,
  "items": [
    {
      "rank": 1,
      "player_id": 501,
      "score": 92000
    }
  ],
  "next_cursor": "signed-cursor-token"
}
다음 페이지에서는 snapshot_id=9812와 커서를 함께 검증합니다. 공개 포인터가 그 사이에 9813으로 바뀌어도 기존 요청은 9812를 계속 읽습니다.
커서는 최소한 다음 정보를 서명된 토큰에 포함하는 것이 안전합니다.
snapshot_id- 마지막으로 읽은 정렬 키
- 시즌 ID
- 만료 시각
커서에 서명을 적용하면 클라이언트가 rank나 score를 바꿔 임의의 위치를 조회하는 일을 막을 수 있습니다. 단 순위 데이터 자체가 공개 데이터가 아니거나 보상 계산과 연결되어 있다면 플레이어 권한, 시즌 접근 권한, 요청 빈도 제한도 별도로 적용해야 합니다.
REPEATABLE READ만 사용하면 충분한가?
항상 그렇지는 않습니다. PostgreSQL의 REPEATABLE READ는 하나의 트랜잭션 안에서 일관된 스냅샷을 제공하지만 수백만 행을 읽는 동안 트랜잭션을 오래 유지해야 합니다. 이 경우 MVCC 버전이 오래 남아 테이블 팽창, 정리 지연, 연결 점유가 발생할 수 있습니다.
| 방식 | 장점 | 주의할 점 | 적합한 경우 |
|---|---|---|---|
긴 REPEATABLE READ 트랜잭션 | 구현이 단순함 | 트랜잭션 장기화와 MVCC 부담 | 데이터 규모가 작거나 생성 빈도가 낮을 때 |
cut_seq 기반 재생 | 저장소와 분리된 기준 시점 | 이벤트 순서와 재생 로직 필요 | 대규모·비동기 시스템 |
| 임시 스냅샷 테이블 | 공개 시점이 명확함 | 저장 공간과 정리 정책 필요 | 페이지 조회와 보상 계산을 오래 유지할 때 |
| 컬럼형 분석 저장소 | 대량 스캔과 집계에 유리 | 운영 복잡도와 지연 | 통계·리포트 중심의 대형 리더보드 |
실시간 점수판과 시즌 결과판은 요구사항이 다릅니다. 실시간 점수판은 약간의 지연을 허용하고 최신 읽기 모델을 보여줄 수 있지만 시즌 결과판은 재현성과 감사 가능성이 더 중요합니다. 같은 테이블을 두 목적에 동시에 사용하기보다 실시간 모델과 불변 스냅샷을 분리하는 편이 명확합니다.
장애와 재시도는 어떻게 처리할까?
스냅샷 생성 작업은 중간에 실패할 수 있으므로 멱등성을 설계해야 합니다.
season_id와cut_seq조합에 유일 제약을 둡니다.- 재시도마다 같은
snapshot_id를 이어서 쓰거나 새 ID로 완전히 격리합니다. building상태가 일정 시간 이상 지속되면 워치독이 실패 처리합니다.ready스냅샷은 수정하지 않고 새 스냅샷을 생성합니다.- 오래된 스냅샷은 보상 이의 제기 기간과 감사 보존 기간을 고려해 삭제합니다.
특히 생성 중인 테이블을 먼저 비우고 다시 채우는 방식은 피해야 합니다. 기존 공개 버전까지 손상될 수 있기 때문입니다. 항상 새 버전을 별도로 만들고 검증 후 포인터만 전환하는 방식이 안전합니다.
자주 묻는 질문 (FAQ)
스냅샷 생성 중 들어온 점수는 어느 리더보드에 표시되나요?
cut_seq보다 큰 이벤트라면 현재 스냅샷에는 포함하지 않고 다음 스냅샷에 반영합니다. 현재 결과의 기준 시점을 고정하는 것이 중간에 순위를 섞는 것보다 중요합니다.
동점 점수의 순위가 실행마다 달라지는 이유는 무엇인가요?
score만 정렬하고 유일한 보조 키를 지정하지 않았기 때문입니다. achieved_at, 이벤트 순서, player_id처럼 게임 규칙에 맞는 결정적 tie-breaker를 마지막까지 지정해야 합니다.
읽기 모델이 cut_seq를 따라잡지 못하면 어떻게 해야 하나요?
스냅샷을 ready로 공개하지 말고 생성 작업을 대기하거나 실패 처리합니다. read_model_applied_seq >= cut_seq를 만족하는지 확인해야 원장 기준으로 완전한 스냅샷을 만들 수 있습니다.
정리
대규모 리더보드 스냅샷의 핵심은 빠른 ORDER BY 하나가 아니라 읽기의 기준 시점과 공개 버전을 고정하는 것입니다. cut_seq로 포함 범위를 정의하고 유일한 정렬 키로 순위를 결정하며 별도의 불변 읽기 모델을 ready 상태에서 원자적으로 공개하면 생성 중 변경, 복제 지연, 페이지 경계 이동을 통제할 수 있습니다.
이 구조는 순위 조회뿐 아니라 시즌 보상, 랭크 이력, 고객센터 재현, 부정 행위 조사에도 같은 결과를 제공한다는 장점이 있습니다. 운영 환경에서는 스냅샷의 보존 기간, 재시도 정책, 체크섬 검증, 커서 서명까지 함께 설계해야 일관성이 실제 서비스 품질로 이어집니다.