장시간 미접속 계정 콜드 데이터 계층형 저장 설계: 저비용 저장소와 로그인 시 투명 복원
장시간 미접속 게임 계정의 콜드 데이터를 PostgreSQL과 S3 호환 오브젝트 스토리지로 계층화하는 실전 설계입니다. 로그인 시 지연, 중복 복원, 무결성 검증, 암호화, 장애 복구와 비용 기준까지 정리합니다.
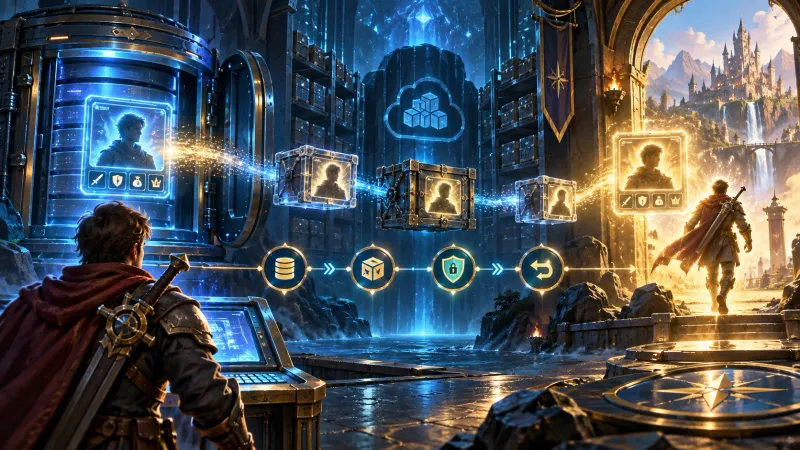
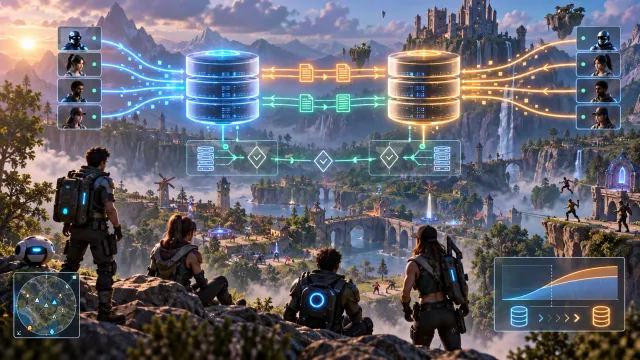
장기간 접속하지 않은 게임 계정은 플레이 빈도가 낮지만 인벤토리, 퀘스트, 업적, 결제 이력처럼 보존해야 할 데이터가 많습니다. 핵심 설계는 로그인에 필요한 계정 메타데이터만 PostgreSQL 핫 티어에 유지하고 나머지 콜드 데이터를 S3 호환 오브젝트 스토리지로 이동하는 것입니다. 로그인 시에는 상태 머신과 멱등성 보장을 사용해 사용자의 별도 조작 없이 데이터를 검증하고 복원합니다.
핵심 요약
- PostgreSQL에는 계정 상태, 저장소 상태, 스냅샷 버전, 오브젝트 키만 남기고 상세 게임 상태는 콜드 티어로 이동합니다.
- 아카이빙은
ACTIVE → MIGRATING → COLD, 복원은COLD → RESTORING → ACTIVE상태 전이로 관리합니다. - Zstandard 압축, AES-256-GCM 봉투 암호화, SHA-256 체크섬, PostgreSQL 조건부 업데이트를 함께 사용하면 비용과 동시성 문제를 동시에 줄일 수 있습니다.
- S3 Glacier Deep Archive처럼 복구 시간이 긴 계층은 로그인 요청에서 즉시 복원할 수 없으므로 별도의 비동기 복원 정책이 필요합니다.
이 글의 예시는 PostgreSQL 16, Node.js 22 LTS, AWS SDK for JavaScript v3, S3 API, Zstandard 압축을 기준으로 합니다. 다른 관계형 데이터베이스나 오브젝트 스토리지에도 상태 머신, 무결성 검증, 멱등성이라는 핵심 원리는 그대로 적용할 수 있습니다.
콜드 데이터는 무엇이며 왜 비용을 줄이는가?
콜드 데이터는 생성된 뒤 오랫동안 읽히지 않지만 삭제할 수 없는 데이터를 의미합니다. 게임에서는 장기 미접속 계정의 전체 인벤토리, 완료 퀘스트, 캐릭터 성장 기록, 비활성 길드 정보 등이 대표적입니다.
핫 데이터와 콜드 데이터의 차이는 데이터의 중요도가 아니라 접근 빈도입니다. 콜드 데이터도 로그인 직후 다시 필요할 수 있으므로 단순 삭제가 아니라 복원 가능한 형태로 보관해야 합니다.
| 구분 | 핫 티어 | 콜드 티어 |
|---|---|---|
| 저장소 | PostgreSQL, SSD 기반 DB | S3 Standard-IA, S3 Intelligent-Tiering 또는 유사한 오브젝트 스토리지 |
| 접근 빈도 | 매 요청 또는 세션마다 읽음 | 수개월에 한 번 이하 |
| 접근 특성 | 보통 온라인 DB에서 조회 | 저장 클래스에 따라 즉시 접근 또는 별도 복원 필요 |
| 데이터 형태 | 정규화된 현재 상태 | 버전이 고정된 스냅샷 |
| 주요 비용 | DB 인스턴스, 스토리지, IOPS | 저장 용량, GET 요청, 검색·복원·전송 비용 |
| 복원 방식 | 별도 복원 불필요 | 다운로드, 검증, 복호화, 역직렬화, DB 반영 |
저장 비용은 다음처럼 단순화해 비교할 수 있습니다.
따라서 모든 계정을 무조건 콜드 티어로 옮기는 것이 최적은 아닙니다. 복원 빈도가 높거나 로그인 지연에 민감한 계정은 핫 또는 웜 티어에 남겨야 합니다.
저장소 계층은 어떻게 나눌까?
실무에서는 두 단계보다 세 단계가 운영하기 편합니다.
| 계층 | 대상 | 권장 용도 |
|---|---|---|
| Hot | 최근 접속 계정과 로그인 직후 자주 사용하는 상태 | PostgreSQL의 정규화 테이블 |
| Warm-cold | 180일 이상 미접속했지만 즉시 복원이 필요한 계정 | S3 Standard-IA, S3 Intelligent-Tiering의 빈도 낮은 접근 계층 |
| Archive | 장기간 보관만 필요하고 복원 지연을 허용할 수 있는 데이터 | Glacier Flexible Retrieval, Deep Archive와 유사한 보관 계층 |
여기서 중요한 제약은 아카이브 계층의 복원 시간이 저장소 정책에 따라 달라진다는 점입니다. 사용자가 로그인 버튼을 누른 뒤 수 분 이상 기다려야 하는 계층을 선택하면 이를 완전한 투명 복원이라고 부르기 어렵습니다.
따라서 일반적인 로그인 흐름에는 웜-콜드 계층을 사용하고 장기 보관·감사·삭제 유예 데이터에는 아카이브 계층을 사용하는 식으로 목적을 분리합니다.
flowchart LR
    A[로그인 요청] --> B{저장 상태 확인}
    B -->|ACTIVE| C[핫 DB에서 로드]
    B -->|COLD| D[RESTORING 선점]
    D --> E[오브젝트 다운로드]
    E --> F[복호화 무결성 검증 압축 해제]
    F --> G[PostgreSQL 트랜잭션 복원]
    G --> H[ACTIVE 전환 후 세션 발급]
    E -->|실패| I[재시도 또는 복구 큐]
어떤 계정 데이터를 콜드 티어로 옮겨야 할까?
로그인 과정에서 반드시 필요한 값과 실제 게임 플레이 중에 필요한 값을 분리해야 합니다.
| 데이터 | 핫 티어 유지 | 콜드 티어 이동 |
|---|---|---|
account_id, 인증 식별자, 계정 상태 | 예 | 복구용 사본만 보관 |
| 정지·법적 보존·결제 분쟁 플래그 | 예 | 별도 보존 정책 적용 |
| 캐릭터 상세 능력치와 인벤토리 | 최근 계정만 | 예 |
| 완료 퀘스트와 업적 | 최근 계정만 | 예 |
| 매치 로그와 오래된 이벤트 기록 | 요약값만 | 예 |
| 세션 토큰, 비밀번호 해시, MFA 시크릿 | 예외적으로 별도 보안 영역 | 원칙적으로 아카이브 스냅샷에 포함하지 않음 |
특히 세션 토큰과 인증 시크릿은 게임 상태 스냅샷에 섞지 않는 편이 안전합니다. 인증 시스템은 핫 티어에 남기고 게임 도메인 데이터만 별도로 아카이빙하면 복원 시 공격 표면을 줄일 수 있습니다.
아카이브 포맷은 어떻게 설계할까?
데이터베이스 테이블을 그대로 덤프하는 방식은 스키마 변경과 서비스 버전 변경에 취약합니다. 애플리케이션 모델 기준의 버전이 있는 스냅샷 포맷을 정의하는 편이 안전합니다.
권장 포맷은 다음과 같습니다.
- 게임 상태를 canonical JSON 또는 Protocol Buffers로 직렬화합니다.
- Zstandard level 3 정도로 압축합니다. 압축 레벨은 CPU 비용과 저장 용량을 측정해 조정합니다.
- AWS KMS 또는 호환 KMS로 데이터 키를 발급하고 AES-256-GCM으로 암호화합니다.
- SHA-256 체크섬을 계산하고 S3의
x-amz-checksum-sha256메타데이터에도 기록합니다. account_id,revision,schema_version을 AES-GCM의 추가 인증 데이터로 넣어 객체 바꿔치기를 방지합니다.
스냅샷 헤더는 다음처럼 구성할 수 있습니다.
{
  "format": "account-snapshot",
  "schema_version": 3,
  "account_id": "7f3f7b9a-...",
  "revision": 1842,
  "created_at": "2026-08-29T09:00:00Z",
  "compression": "zstd",
  "encryption": "aes-256-gcm-envelope",
  "checksum_algorithm": "sha256"
}
실제 객체 키에는 사용자 입력을 그대로 사용하지 말고 UUID 또는 내부 식별자를 사용합니다. 예를 들면 다음과 같습니다.
accounts/7f/3f/7f3f7b9a-.../revisions/1842.snapshot.zst.enc계정 하나의 스냅샷이 너무 커지면 인벤토리, 캐릭터, 퀘스트, 통계 영역을 별도 청크로 나누고 manifest 객체가 각 청크의 키와 체크섬을 가리키도록 합니다. 청크 크기는 워커 메모리와 복원 지연 목표에 맞춰 정하며 8MiB에서 64MiB 범위부터 측정하는 방법이 실용적입니다.
자동 아카이빙은 어떤 순서로 구현할까?
아카이빙 작업은 로그인 트래픽과 분리된 워커가 처리해야 합니다. 한 번에 많은 계정을 옮기면 DB I/O와 오브젝트 스토리지 요청이 동시에 증가하므로 배치 크기와 동시성을 제한합니다.
1단계: 후보 계정을 안전하게 선점한다
마지막 접속 시각은 인증 성공과 계정 상태 로드가 끝난 뒤 갱신합니다. 후보 기준은 서비스 정책에 따라 다르지만 예시는 180일입니다.
SELECT account_id, revision
FROM account_storage
WHERE storage_state = 'ACTIVE'
  AND last_login_at < now() - interval '180 days'
  AND legal_hold = false
ORDER BY last_login_at
FOR UPDATE SKIP LOCKED
LIMIT 100;
선택한 행은 짧은 트랜잭션에서 MIGRATING으로 변경하고 migration_id를 기록합니다. 이후 계정 쓰기 요청은 상태가 MIGRATING인 동안 대기하거나 거부해야 스냅샷 이후의 변경이 유실되지 않습니다.
2단계: 고정된 revision으로 스냅샷을 만든다
계정의 여러 테이블을 읽을 때는 애플리케이션이 관리하는 revision을 기준으로 일관성을 확인합니다. 가장 단순한 방법은 마이그레이션 중 계정 쓰기를 막고 모든 도메인 데이터를 읽는 것입니다.
대규모 계정이나 쓰기 중단이 어려운 서비스는 PostgreSQL의 REPEATABLE READ 트랜잭션, 이벤트 로그, 도메인별 revision을 사용할 수 있습니다. 중요한 것은 스냅샷에 포함된 revision보다 최신 변경이 콜드 전환 과정에서 사라지지 않는지 검증하는 것입니다.
3단계: 업로드를 완료한 뒤 상태를 전환한다
객체 업로드가 성공했다고 바로 DB 원본을 삭제하면 안 됩니다. 먼저 업로드 결과와 체크섬을 저장하고 다음 조건부 업데이트를 수행합니다.
UPDATE account_storage
SET storage_state = 'COLD',
    cold_object_key = $2,
    cold_checksum = $3,
    cold_schema_version = $4,
    updated_at = now()
WHERE account_id = $1
  AND storage_state = 'MIGRATING'
  AND revision = $5;
업데이트된 행이 1개일 때만 핫 데이터를 정리합니다. 0개라면 다른 작업이 상태를 바꾼 것이므로 오브젝트는 고아 객체 정리 큐로 보내고 원본은 삭제하지 않습니다.
DB에서 상세 상태를 제거한 뒤에는 테이블에 빈 공간이 남을 수 있습니다. 계정 데이터가 파티션 구조라면 오래된 계정 파티션을 교체하거나 제거하는 방법이 효율적입니다. 일반 테이블에서 DELETE를 사용한다면 PostgreSQL autovacuum과 테이블 팽창을 함께 관찰해야 합니다.
PostgreSQL 메타데이터는 어떻게 구성할까?
콜드 상태에서도 로그인 라우터가 빠르게 판단할 수 있도록 메타데이터는 핫 DB에 남깁니다.
CREATE TABLE account_storage (
    account_id uuid PRIMARY KEY,
    storage_state text NOT NULL CHECK (storage_state IN ('ACTIVE', 'MIGRATING', 'COLD', 'RESTORING')),
    revision bigint NOT NULL,
    last_login_at timestamptz NOT NULL,
    legal_hold boolean NOT NULL DEFAULT false,
    cold_object_key text,
    cold_checksum bytea,
    cold_schema_version integer,
    restore_id uuid,
    restore_started_at timestamptz,
    lease_until timestamptz,
    updated_at timestamptz NOT NULL DEFAULT now()
);

CREATE INDEX account_storage_cold_login_idx
ON account_storage (last_login_at)
WHERE storage_state = 'ACTIVE' AND legal_hold = false;restore_id와 lease_until은 복원 워커가 중단됐을 때 복구하는 데 사용합니다. 일정 시간이 지난 RESTORING 행은 워커가 lease를 회수하고 다시 시도할 수 있어야 합니다.
로그인 시 투명한 복원은 어떻게 구현할까?
투명 복원은 클라이언트가 별도의 복원 버튼을 누르지 않아도 백엔드가 필요한 작업을 수행한다는 의미입니다. 다만 인증 전에 복원을 시작하면 공격자가 임의의 계정에 대해 비싼 오브젝트 GET과 복호화를 유발할 수 있으므로 자격 증명 검증 후에 복원합니다.
복원 절차는 다음과 같습니다.
- 인증 정보를 검증하고 계정의
storage_state를 읽습니다. COLD인 경우 조건부 업데이트로RESTORING상태를 선점합니다.- 이미 다른 요청이 복원을 시작했다면 같은
restore_id를 관찰하며 결과를 기다립니다. - S3 객체를 다운로드하고 SHA-256 체크섬, AES-GCM 인증 태그, manifest를 검증합니다.
- 복호화 후 Zstandard 압축을 해제하고
schema_version을 현재 모델로 마이그레이션합니다. - PostgreSQL 트랜잭션 안에서 상세 데이터를 삽입하거나 갱신합니다.
- 모든 검증과 반영이 성공하면
ACTIVE로 전환하고 정식 세션을 발급합니다.
핵심 선점 코드는 다음과 같은 형태입니다.
const restoreId = crypto.randomUUID();

const result = await db.query(
  `UPDATE account_storage
   SET storage_state = 'RESTORING',
       restore_id = $2,
       restore_started_at = now(),
       lease_until = now() + interval '5 minutes',
       updated_at = now()
   WHERE account_id = $1
     AND storage_state = 'COLD'
   RETURNING cold_object_key, cold_checksum, cold_schema_version, revision`,
  [accountId, restoreId]
);

if (result.rowCount === 1) {
  const meta = result.rows[0];
  const encrypted = await objectStore.download(meta.cold_object_key);
  const snapshot = await verifyDecryptAndDecompress(encrypted, meta);

  await db.transaction(async tx => {
    await importAccountSnapshot(tx, snapshot, meta.revision);
    const activation = await tx.query(
      `UPDATE account_storage
       SET storage_state = 'ACTIVE',
           restore_id = NULL,
           restore_started_at = NULL,
           lease_until = NULL,
           updated_at = now()
       WHERE account_id = $1
         AND storage_state = 'RESTORING'
         AND restore_id = $2`,
      [accountId, restoreId]
    );
    if (activation.rowCount !== 1) {
      throw new Error('restore_ownership_lost');
    }
  });
} else {
  await waitForExistingRestore(accountId);
}
실제 서비스에서는 importAccountSnapshot이 현재 스키마와 snapshot의 schema_version 차이를 처리해야 합니다. 과거 버전마다 복원 코드를 영구적으로 유지하기 어렵다면 주기적인 백필 작업으로 스냅샷을 최신 포맷으로 변환하는 정책을 추가합니다.
복원 실패와 동시성 문제를 어떻게 다룰까?
복원은 네트워크, 오브젝트 스토리지, KMS, DB 중 어느 곳에서도 실패할 수 있습니다. 실패 시 부분 복원 상태가 남지 않도록 임시 테이블이나 임시 namespace에 먼저 적재한 뒤 검증 완료 후 한 트랜잭션으로 교체합니다.
다음 원칙을 적용하면 재시도에 안전합니다.
- 계정별
restore_id를 멱등성 키로 사용합니다. COLD → RESTORING은 조건부 업데이트로 한 요청만 성공하게 합니다.RESTORING상태에는 lease 만료 시각을 기록합니다.- 체크섬이나 GCM 인증 태그 검증 실패 시 재시도 횟수를 제한하고 운영 알림을 발생시킵니다.
- 복원 중에는 캐릭터 변경, 아이템 지급, 매치 참가 같은 쓰기 요청을 차단하거나 계정별 큐에 넣습니다.
- 복원 완료 후에만 전체 세션 토큰을 발급합니다.
- 아카이브 객체는 즉시 삭제하지 않고 검증 유예 기간 동안 보관합니다.
복원 중에 최신 게임 이벤트가 발생할 수 있는 서비스라면 이벤트 로그를 함께 사용합니다. 스냅샷을 revision 1842에서 만들었다면 복원 후 revision 1843 이후의 이벤트를 순서대로 재생하는 방식입니다.
보안과 삭제 정책은 어떻게 연결할까?
콜드 티어는 접근 빈도가 낮기 때문에 오히려 권한과 감사가 느슨해지기 쉽습니다. 다음 항목을 기본 정책으로 두는 것이 좋습니다.
- 버킷을 공개하지 않고 게임 백엔드 전용 IAM 역할만 읽기 권한을 갖게 합니다.
- KMS 키 정책과 오브젝트 저장소 권한을 분리합니다.
- 계정 ID, revision, schema version을 AES-GCM 추가 인증 데이터로 사용합니다.
- 오브젝트 키, 로그, 메트릭에 이메일이나 결제 식별자를 넣지 않습니다.
- 다운로드, 복호화, 복원 완료, 삭제 작업을 감사 로그에 남깁니다.
- 법적 보존, 결제 분쟁, 이용자 삭제 요청 계정은 아카이빙 대상에서 제외하거나 별도 보존 정책을 적용합니다.
- 이용자 데이터 삭제 시 현재 DB 행뿐 아니라 오브젝트 버전, 백업, 복제본, 고아 객체까지 삭제 범위를 확인합니다.
저장소의 버전 관리와 오브젝트 락을 사용한다면 삭제 요청과 충돌할 수 있습니다. 보존 기간이 끝나지 않은 객체를 삭제할 수 없는 정책이라면 이용자에게 적용되는 보존 사유와 만료 시점을 별도로 기록해야 합니다.
비용과 운영 지표는 무엇을 봐야 할까?
콜드 티어의 비용 절감은 저장 단가만으로 판단하면 안 됩니다. GET 요청 수, KMS 호출 수, 데이터 전송량, 아카이브 복원 비용, 워커 실행 비용까지 포함해야 합니다.
| 지표 | 의미 | 확인할 문제 |
|---|---|---|
active_to_cold_bytes_total | 이동한 데이터 양 | 실제 저장 비용 절감 규모 |
cold_restore_latency_ms | 복원 지연 시간 | 로그인 SLO 위반 여부 |
cold_restore_success_total | 성공한 복원 수 | 저장소와 변환기의 안정성 |
snapshot_checksum_mismatch_total | 무결성 검증 실패 수 | 손상, 잘못된 키, 업로드 오류 |
duplicate_restore_attempt_total | 중복 복원 시도 수 | 로그인 폭주와 CAS 동작 상태 |
orphan_object_bytes | DB 메타데이터가 없는 객체 | 업로드 후 상태 전환 실패 |
stuck_restoring_total | lease가 만료된 복원 | 워커 장애와 재시도 정책 |
복원 실패율과 p95 로그인 지연은 계정 전체 평균이 아니라 콜드 계정 로그인만 따로 집계해야 합니다. 또한 계정 규모별로 복원 시간을 나눠야 대형 인벤토리나 특정 도메인 청크가 병목인지 확인할 수 있습니다.
자주 묻는 질문 (FAQ)
S3 Glacier Deep Archive에서 로그인 시 바로 복원해도 되나요?
권장하지 않습니다. 해당 계층은 저장 비용은 낮출 수 있지만 복원 시간이 서비스 정책과 요청 옵션에 따라 달라집니다. 로그인 지연을 허용할 수 없다면 S3 Standard-IA나 즉시 접근이 가능한 웜-콜드 계층을 사용하고 Deep Archive는 장기 보관용으로 분리하세요.
로그인 요청을 여러 번 보내면 복원이 중복 실행되지 않나요?
COLD → RESTORING 조건부 업데이트와 restore_id를 사용하면 한 요청만 복원을 선점할 수 있습니다. 나머지 요청은 같은 복원 작업의 상태를 기다리거나 짧은 재시도 후 결과를 공유해야 합니다.
마지막 로그인 날짜만으로 아카이빙해도 되나요?
아닙니다. 법적 보존, 결제 분쟁, 진행 중인 환불, 운영자 조사, 친구·길드 상호작용 같은 예외 조건을 함께 확인해야 합니다. 후보 선정은 last_login_at으로 시작하되 최종 이동 전에는 보존 플래그와 계정 쓰기 상태를 다시 검증하세요.
정리
장시간 미접속 계정의 콜드 데이터 저장은 단순히 DB 행을 오브젝트 스토리지로 옮기는 작업이 아닙니다. 저장소 계층, 스냅샷 포맷, 암호화, 무결성 검증, 상태 전이, 동시성 제어, 삭제 정책을 하나의 수명주기로 설계해야 합니다.
실전에서 가장 중요한 기준은 세 가지입니다. 첫째, 로그인 경로에 필요한 메타데이터는 핫 DB에 남깁니다. 둘째, 복원은 조건부 상태 전이와 멱등성 키로 한 번만 실행되게 합니다. 셋째, 비용이 낮은 아카이브 계층을 선택하더라도 실제 복원 지연과 삭제·보존 정책을 서비스 요구사항에 맞춰 검증합니다.
이 구조를 적용하면 사용 빈도가 낮은 계정의 DB 용량과 운영 비용을 줄이면서도 사용자가 다시 돌아왔을 때 원래의 게임 상태를 일관되고 안전하게 복원할 수 있습니다.