멀티플레이어 게임 매치메이킹 핑 최적화: AI 지연 시간 예측 라우팅 구현 가이드
멀티플레이어 게임의 매치메이킹 핑을 줄이는 AI 라우팅 설계를 정리합니다. RTT·지터·패킷 손실·서버 부하를 예측 모델에 반영하고 안전한 폴백과 히스테리시스, 관측성까지 구현하는 백엔드 가이드입니다.
핵심 요약
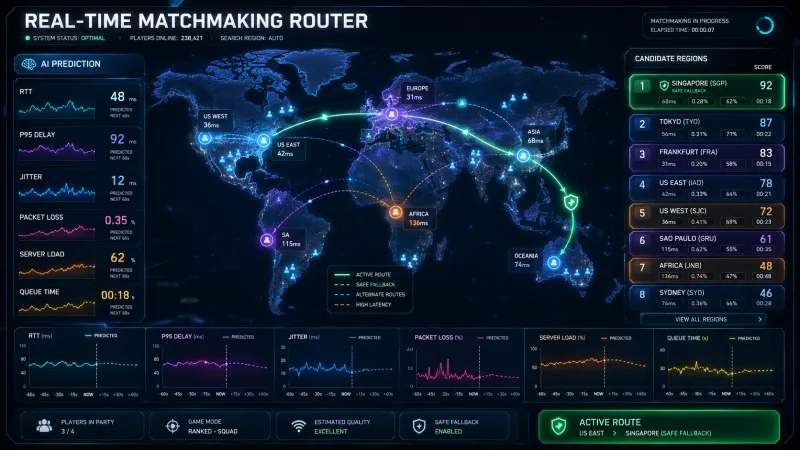
멀티플레이어 게임의 매치메이킹 핑 최적화는 단순히 플레이어와 가까운 리전을 고르는 문제가 아닙니다. 최근 RTT, RTT 지터, 패킷 손실률, ISP·ASN, 시간대별 혼잡도, 리전별 서버 부하를 함께 사용해 각 게임 서버의 예상 지연 시간을 계산해야 합니다.
실시간 라우팅에서는 AI 모델이 예측한 p95 RTT와 패킷 손실을 후보 리전 점수에 반영하고 허용 가능한 최대 지연 시간과 파티 분할 금지 같은 하드 제약을 먼저 적용합니다. 모델 장애나 데이터 부족에 대비해 EWMA 기반 규칙과 고정 리전 우선순위를 폴백으로 유지해야 합니다.
멀티플레이어 게임의 핑은 왜 갑자기 튀는가?
핑은 일반적으로 클라이언트와 게임 서버 사이의 왕복 시간인 RTT(Round-Trip Time)를 의미합니다. 하지만 실제 플레이 품질은 RTT 하나로 결정되지 않습니다.
| 지표 | 의미 | 게임 플레이 영향 |
|---|---|---|
| RTT | 요청과 응답 사이의 왕복 시간 | 입력 반응 지연 |
| RTT 지터 | 이 예시에서는 같은 측정 창의 RTT 표준편차 | 보간·판정 안정성 점검 |
| 패킷 손실률 | 전송된 패킷 중 유실된 비율 | 재전송, 상태 누락 |
| 서버 틱 지연 | 게임 루프가 한 틱을 처리하는 시간 | 판정 및 물리 업데이트 지연 |
| 큐 대기 시간 | 매치 서버나 네트워크 큐에서 기다린 시간 | 연결 직후 지연 증가 |
가상의 예로 평균 RTT가 45ms여도 상위 지연 표본 때문에 p95 RTT가 180ms일 수 있습니다. 이는 특정 리전의 실측값이 아니며, 평균과 분위수를 함께 확인해야 하는 이유를 설명하는 예시입니다.
또한 플레이어와 리전의 지리적 거리는 네트워크 경로의 실제 품질을 보장하지 않습니다. 해저 케이블 경로, ISP 피어링, 모바일 통신망, 클라우드 리전의 트래픽 상태가 함께 영향을 줍니다.
AI 지연 시간 예측 라우팅은 어떻게 동작할까?
라우팅 대상은 보통 다음 세 가지입니다.
- 플레이어가 접속할 수 있는 리전 후보
- 각 리전에서 실행 가능한 매치 서버 그룹
- 파티 전체의 품질을 만족하는 공통 리전
각 후보 리전 r에 대해 다음 특징을 수집합니다.
- 최근 1분, 5분, 15분 단위의 RTT 평균과 p95
- RTT 지터와 패킷 손실률
- 클라이언트 리전, 국가, ISP ASN, 연결 유형
- UTC 시간대와 요일
- 리전별 CPU 사용률, 네트워크 사용률, 매치 서버 큐 길이
- 최근 라우팅 결과와 연결 성공률
- 클라이언트에서 엣지 노드까지의 측정값
모델은 각 리전의 미래 품질을 다음처럼 예측할 수 있습니다.
초기 후보로 XGBoost나 LightGBM 같은 그래디언트 부스팅 모델을 비교할 수 있습니다. 모델 크기와 특징 수에 따라 추론 비용이 달라지므로 실제 요청 경로에서 측정해야 합니다. XGBoost의 분위수 회귀처럼 조건부 p50·p95를 학습하는 방법을 사용할 수 있지만, 학습 목표에 쓰는 지연 표본의 측정 창과 예측 시점을 먼저 정의해야 합니다. 미래 창의 관측 p95 자체를 목표로 학습하는 방식과 개별 RTT의 조건부 95% 분위수를 학습하는 방식은 구분합니다. 분위수 교차나 지역별 보정 오차도 검증합니다.
라우팅 점수는 다음과 같이 구성할 수 있습니다.
점수가 낮을수록 유리합니다. 다만 점수 계산 전에 최대 RTT, 최대 손실률, 지원 지역, 데이터센터 장애 여부 같은 하드 제약을 먼저 적용해야 합니다.
flowchart LR
  A[클라이언트 텔레메트리] --> B[특징 집계 Redis]
  B --> C[AI 지연 시간 예측]
  C --> D[리전 후보 필터]
  D --> E[가중치 점수 계산]
  E --> F[매치 서버 할당]
  F --> G[서버 검증 RTT 지터 손실]
  G --> B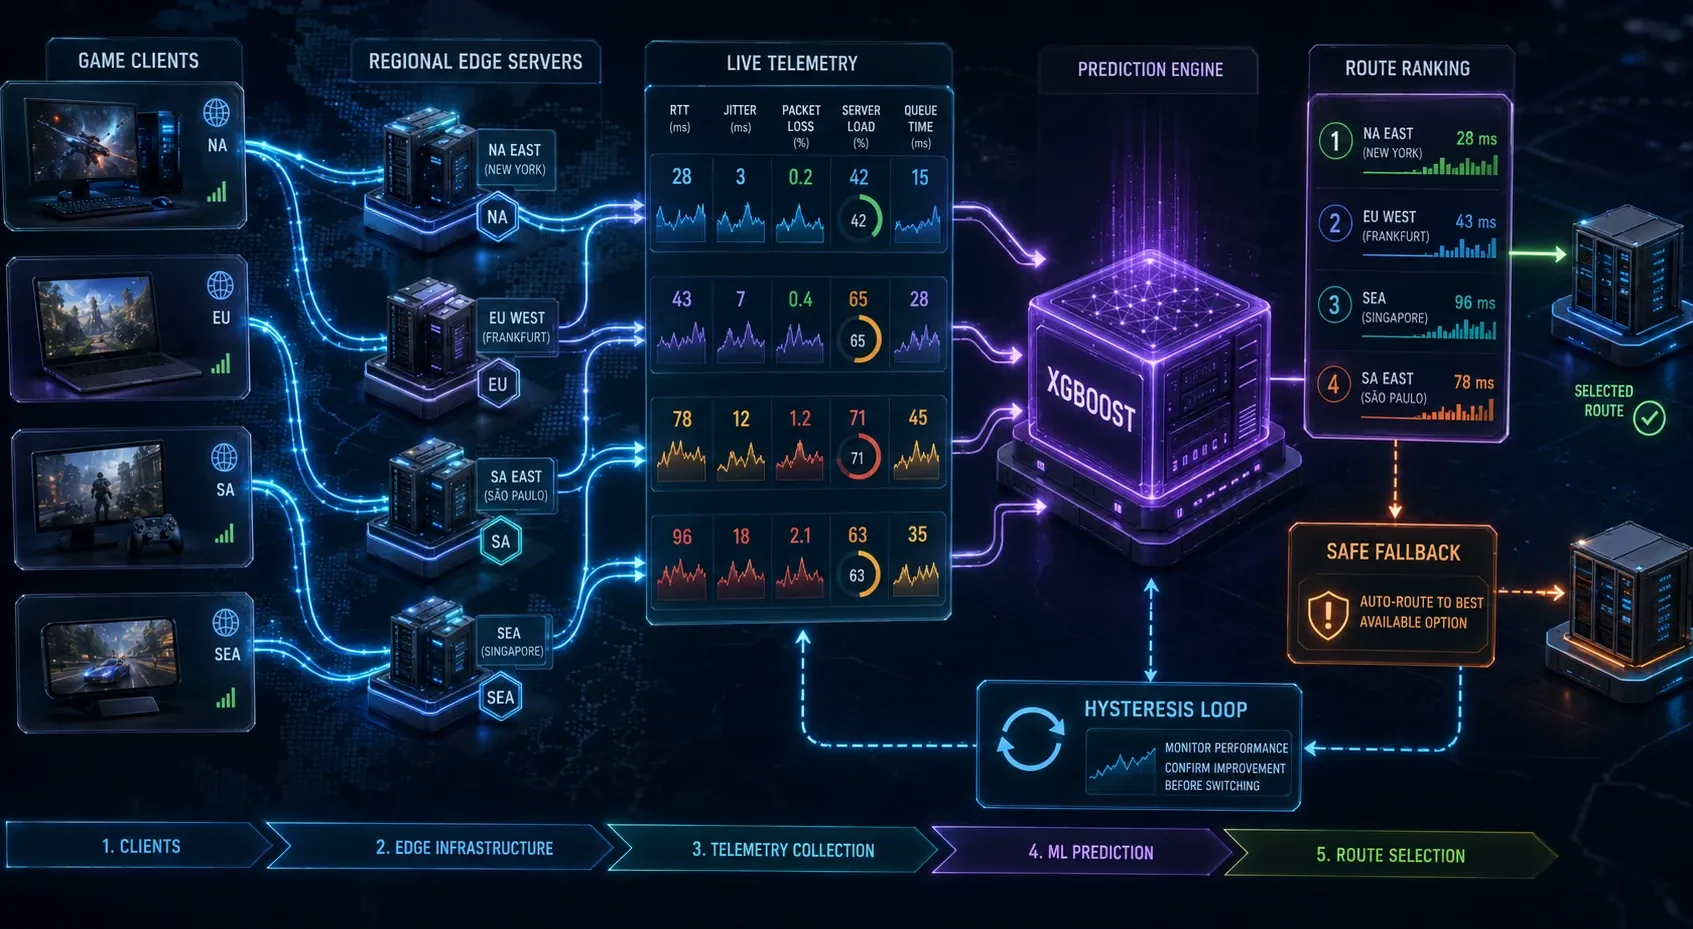
AI 지연 시간 예측 라우팅을 어떻게 구현할까?
1단계: 서버 기준의 네트워크 텔레메트리를 수집한다
클라이언트가 직접 보고한 핑을 그대로 신뢰하면 치팅이나 측정 오류에 취약합니다. 클라이언트 측 측정값은 참고 특징으로만 사용하고 최종 품질 평가는 게임 세션 서버와 엣지 노드가 수집한 데이터를 기준으로 삼는 편이 안전합니다.
서버 측 관측도 순수한 회선 지연의 정답은 아닙니다. 클라이언트가 응답을 지연하거나 단말 처리가 늦으면 RTT에 포함되므로 응답 지연·결측과 표본 수를 기록하고 단일 사용자 표본으로 지역 전체의 품질을 바꾸지 않도록 제한합니다.
매치 서버는 연결 직후 짧은 핸드셰이크 구간에서 다음 값을 기록할 수 있습니다.
session_id
player_region
server_region
client_asn
transport
rtt_ms
jitter_ms
packet_loss_ratio
measured_at
개인정보 보호를 위해 원시 IP를 장기간 저장하지 말고 ASN, 국가, 네트워크 유형처럼 라우팅에 필요한 값으로 축약합니다. 원시 데이터가 필요하다면 짧은 보존 기간과 접근 권한을 별도로 적용합니다.
2단계: 최근 상태와 장기 기준선을 함께 만든다
네트워크 품질은 빠르게 변하므로 최근 데이터와 장기 기준선을 동시에 사용합니다. 예를 들어 최근 관측값에는 높은 가중치를 주는 EWMA(Exponentially Weighted Moving Average)를 적용할 수 있습니다.
0 < alpha <= 1에서 alpha가 클수록 최근 관측의 가중치가 커집니다(NIST 지수 평활 설명). 초기값은 첫 유효 관측값이나 정의된 기준선으로 설정합니다. 이 설계에서는 RTT와 손실률의 alpha를 따로 검증하고, 관측 수가 적을 때 장기 기준선과 혼합하는 정책을 시험합니다. 고정 alpha는 관측 간격이 일정하다는 가정이므로 불규칙한 수집 주기에는 경과 시간을 반영한 가중치를 검토합니다.
모델 입력 데이터에는 반드시 데이터 신선도도 포함해야 합니다.
| 상태 | 처리 방법 |
|---|---|
| 최근 1분 내 충분한 관측 | AI 예측 사용 |
| 관측 수 부족 | EWMA와 지역 기준선 혼합 |
| 데이터가 오래됨 | 예측 신뢰도 감소 |
| 모델 타임아웃 | 규칙 기반 폴백 |
| 리전 장애 감지 | 후보에서 즉시 제외 |
3단계: 하드 제약과 점수 기반 선택을 분리한다
매치메이킹 라우터는 다음 순서로 동작시키는 것이 좋습니다.
- 장애 리전과 지원하지 않는 리전을 제거합니다.
- 파티 구성원의 최대 허용 RTT와 손실률을 확인합니다.
- 남은 후보에 대해 AI 예측 점수를 계산합니다.
- 서버 부하와 큐 대기 시간을 반영해 최종 리전을 선택합니다.
- 예측값과 실제 핸드셰이크 결과를 다시 텔레메트리로 저장합니다.
간단한 TypeScript 구현은 다음과 같습니다.
RTT·지터·큐 시간은 ms, 손실률과 서버 부하는 0~1 비율을 사용합니다. 아래 가중치는 단위 변환을 포함한 예시 정책 계수이며, 부하가 상대적으로 거의 반영되지 않을 수 있으므로 목표에 맞게 정규화·조정해야 합니다. 파티 정책·데이터 신선도·모델 타임아웃은 이 함수 밖에서 검사합니다.
type RegionCandidate = {
  id: string;
  predictedRttP95: number;
  predictedJitter: number;
  predictedLoss: number;
  serverLoad: number;
  queueTime: number;
  available: boolean;
};

type RoutingLimits = {
  maxRttP95: number;
  maxLoss: number;
};

function selectRegion(
  candidates: RegionCandidate[],
  limits: RoutingLimits
): RegionCandidate | null {
  if (
    !Number.isFinite(limits.maxRttP95) || limits.maxRttP95 < 0 ||
    !Number.isFinite(limits.maxLoss) || limits.maxLoss < 0 || limits.maxLoss > 1
  ) return null;

  const eligible = candidates.filter((region) => {
    return (
      [region.predictedRttP95, region.predictedJitter, region.predictedLoss,
       region.serverLoad, region.queueTime].every(Number.isFinite) &&
      region.predictedRttP95 >= 0 && region.predictedJitter >= 0 &&
      region.predictedLoss >= 0 && region.predictedLoss <= 1 &&
      region.serverLoad >= 0 && region.serverLoad <= 1 && region.queueTime >= 0 &&
      region.available &&
      region.predictedRttP95 <= limits.maxRttP95 &&
      region.predictedLoss <= limits.maxLoss
    );
  });

  if (eligible.length === 0) return null;

  const score = (region: RegionCandidate) => {
    return (
      region.predictedRttP95 * 0.45 +
      region.predictedJitter * 0.2 +
      region.predictedLoss * 1000 * 0.15 +
      region.serverLoad * 0.1 +
      region.queueTime * 0.1
    );
  };

  return eligible.reduce((best, current) => {
    return score(current) < score(best) ? current : best;
  });
}
실제 서비스에서는 model_version, feature_timestamp, 표본 수와 검증된 불확실성 지표도 함께 반환하는 것이 좋습니다. prediction_confidence라는 임의 점수를 정확할 확률로 취급하지 말고 산출 방식과 보정 여부를 명시합니다. 모델 버전과 오래된 특징 데이터를 추적할 수 있도록 선택 근거를 기록합니다.
매치메이킹 핑 최적화에서 파티 처리는 어떻게 할까?
솔로 플레이어는 가장 낮은 점수의 리전을 선택하면 되지만 파티는 모든 구성원이 수용 가능한 리전을 찾아야 합니다. 파티원별 예측값을 단순 평균으로 합치면 한 명의 높은 지연 시간이 가려질 수 있습니다.
따라서 다음과 같은 집계 방식이 실용적입니다.
- 파티 최대 RTT: 가장 느린 플레이어의 예측 지연까지 제약에 포함
- 파티 p90 RTT: 구성원 분포의 상위 지연을 요약하되 소규모 파티에서는 최대값을 숨길 수 있음
- 파티 평균 RTT: 전체 효율을 평가
- 파티 내 최대 손실률: 연결 불안정 사용자 보호
예를 들어 점수에 파티 최대값을 포함할 수 있습니다.
경쟁 게임은 최대값의 비중을 높이고 캐주얼 협동 게임은 평균값과 매칭 대기 시간의 비중을 높이는 식으로 조정할 수 있습니다.
라우팅 변경으로 핑이 더 불안정해지는 문제는 어떻게 막을까?
예측 점수만 매칭 직전에 계속 비교하면 작은 측정 차이에도 리전이 반복해서 바뀔 수 있습니다. 이를 라우팅 플래핑이라고 합니다.
다음 세 가지 정책을 함께 사용합니다.
- 히스테리시스: 새 리전 점수가 현재 리전보다 일정 비율 이상 낮을 때만 변경
- 쿨다운: 같은 플레이어 또는 파티의 재라우팅을 일정 시간 제한
- 결정 고정: 매치가 생성된 뒤에는 네트워크 품질이 나빠져도 세션 중 리전을 변경하지 않음
매치 생성 전의 재시도는 허용하되 매치가 시작된 후에는 서버 마이그레이션을 별도 기능으로 취급해야 합니다. 서버 마이그레이션은 상태 동기화와 판정 일관성 문제가 있으므로 일반적인 매치메이킹 라우팅과 같은 로직에 섞지 않는 편이 좋습니다.
데이터베이스와 인프라는 어떻게 구성할까?
라우팅 경로의 요청 처리와 분석용 데이터 저장을 분리하면 지연 시간을 관리하기 쉽습니다.
| 영역 | 권장 역할 | 예시 기술 |
|---|---|---|
| 매치메이킹 API | 인증, 파티 검증, 후보 조회 | Go 또는 Kotlin 서비스 |
| 실시간 특징 저장소 | 최근 RTT와 모델 특징 조회 | Redis Cluster |
| 모델 추론 | 낮은 지연 시간의 예측 | Python FastAPI 또는 ONNX Runtime |
| 분석 저장소 | 원시 텔레메트리와 집계 | ClickHouse |
| 영속 데이터베이스 | 계정, 파티, 정책, 리전 설정 | PostgreSQL |
| 장애 전파 | 리전 상태와 회로 차단 | Kubernetes, Prometheus, Alertmanager |
모델 추론 서비스가 매치메이킹 요청의 동기 경로에 있다면 타임아웃을 짧게 설정해야 합니다. 예를 들어 추론 요청이 20ms 안에 응답하지 않으면 Redis의 최신 EWMA를 사용하고 Redis도 사용할 수 없으면 리전 우선순위 목록으로 폴백합니다.
20ms는 이 설계의 초기 예시다. 폴백에서도 장애·지역·파티 제약을 유지하며, 유효한 지연 데이터 없이 최대 RTT를 충족한다고 보장하지 않는다. 제약을 확인할 수 없는 후보만 남으면 재측정·대기·명시적 완화 정책 중 하나를 적용한다. GameLift의 지연 정책도 요청 플레이어의 지연 상한을 기준으로 배치 후보를 제한한다.
모델 서비스가 매치메이킹 API를 직접 호출하는 구조는 피하는 것이 좋습니다. API가 모델 서비스에 요청하고 모델 서비스가 다시 API나 데이터베이스를 호출하면 순환 의존성과 장애 전파가 발생할 수 있습니다. 모델 추론 서비스는 읽기 전용 특징 조회와 예측 반환에 집중시키는 편이 안전합니다.
AI 라우팅 모델의 데이터 오염과 보안 문제는 어떻게 처리할까?
네트워크 텔레메트리는 모델 학습 데이터이면서 운영 의사결정의 입력입니다. 공격자가 특정 지역이나 ISP의 핑을 의도적으로 높게 보고하면 라우팅 결과와 학습 데이터가 함께 오염될 수 있습니다.
다음 방어책을 적용합니다.
- 서버가 관측한 RTT와 클라이언트가 보고한 RTT를 별도 필드로 저장
- 플레이어별·IP 대역별 텔레메트리 수집 빈도 제한
- 비정상적으로 반복되는 값과 불가능한 RTT 변화 제거
- 평균보다 중앙값과 절사 평균을 우선 사용
- 학습 데이터에 포함되기 전 최소 표본 수와 신뢰도 기준 적용
- 모델과 특징 저장소에 서비스 간 인증 및 권한 분리 적용
- 라우팅 정책 변경에 승인 절차와 감사 로그 적용
보안상 중요한 점은 매치메이킹 결과 자체도 서버가 검증해야 한다는 것입니다. 클라이언트가 선호 리전을 보내더라도 서버는 계정 정책, 파티 구성, 지역 제한, 리전 상태를 다시 확인해야 합니다.
효과를 어떻게 측정할까?
평균 핑만 보면 최적화 효과를 잘못 판단할 수 있습니다. 다음 지표를 함께 비교해야 합니다.
- 매치 생성 시점의 예측 p50·p95 RTT
- 실제 게임 세션의 p50·p95 RTT
- 지터와 패킷 손실률
- 매치메이킹 성공률
- 매치 생성까지 걸린 시간
- 리전별 서버 부하와 큐 대기 시간
- 라우팅 폴백 비율
- 예측값과 실제값의 오차
모델 성능은 MAE만으로 평가하지 말고 실제 라우팅 의사결정으로 검증해야 합니다. 예측 오차가 조금 커도 높은 지연 시간의 리전을 안정적으로 피한다면 운영 가치는 있을 수 있습니다. 반대로 평균 오차가 낮아도 특정 ISP나 국가에서 반복적으로 잘못된 리전을 선택하면 모델을 배포해서는 안 됩니다.
권장 검증 순서는 다음과 같습니다.
- 과거 텔레메트리로 오프라인 예측 성능을 측정합니다.
- 실제 선택에는 사용하지 않는 섀도 모드로 라우팅 결과를 기록합니다.
- 일부 트래픽에만 적용해 규칙 기반 라우팅과 비교합니다.
- 지역, ISP, 연결 유형별 품질 편차를 확인합니다.
- 모델 장애와 오래된 데이터 상황에서 폴백이 작동하는지 검증합니다.
자주 묻는 질문 FAQ
AI 모델이 항상 가장 낮은 핑의 서버를 선택하나요?
아닙니다. 모델은 미래의 RTT와 손실률을 예측할 뿐이며 실제 경로는 변할 수 있습니다. 하드 제약, 서버 부하, 파티 구성, 매치 대기 시간까지 함께 고려해야 합니다.
딥러닝 모델이 그래디언트 부스팅보다 좋은가요?
이 글에서는 그래디언트 부스팅과 단순 기준선을 초기 비교 후보로 제안합니다. 데이터 양만으로 우열을 정하지 말고 시계열 분리 검증, 지역별 오차, 추론 지연을 같은 조건에서 비교합니다. 신경망 모델도 필요에 따라 비교 후보에 포함할 수 있습니다.
모델이 중단되면 매치메이킹도 중단해야 하나요?
이 설계에서는 최신 EWMA와 장애 리전 차단 규칙을 폴백으로 사용합니다. 다만 필요한 제약을 확인할 수 없으면 매칭을 대기시키거나 실패로 반환하는 정책도 필요합니다. 폴백 비율과 품질을 관측하고, 폴백으로 선택된 데이터에 따른 표본 편향을 고려해 재학습합니다.
정리
AI 지연 시간 예측 라우팅의 핵심은 모델 자체보다 데이터와 운영 정책의 결합에 있습니다. RTT p95, 지터, 패킷 손실, ISP별 경로 품질, 서버 부하를 함께 수집하고 하드 제약 이후에 예측 점수를 적용해야 안정적인 매치메이킹이 가능합니다.
처음부터 복잡한 딥러닝 시스템을 만들 필요는 없습니다. EWMA 기반 기준선을 마련한 뒤 그래디언트 부스팅 모델을 섀도 모드로 검증하고 히스테리시스와 안전한 폴백을 갖춘 뒤 트래픽을 단계적으로 확대하는 접근이 현실적입니다.