AWS Spot 인스턴스 중단 사전 감지와 데디케이티드 게임 세션 자동 이전 파이프라인
AWS Spot 인스턴스의 중단 예고를 감지해 게임 세션 상태를 저장하고 대체 서버로 안전하게 이전하는 백엔드 설계와 구현 방법을 정리합니다.
핵심 요약
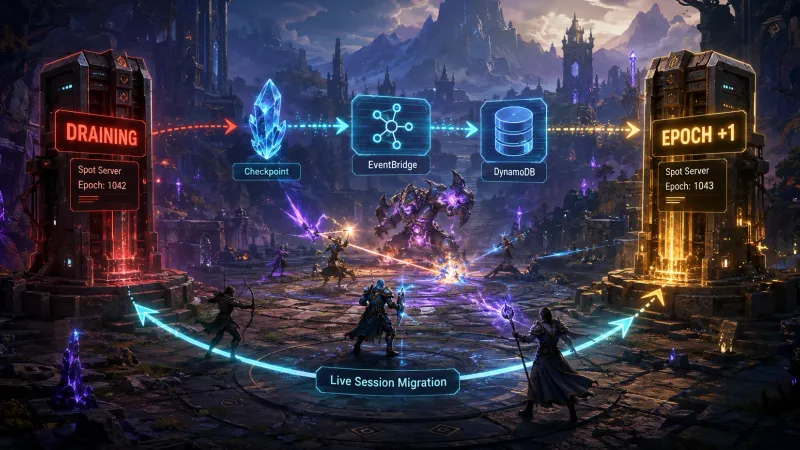
AWS Spot 인스턴스는 IMDS의 spot/instance-action 엔드포인트와 Amazon EventBridge의 Spot 중단 이벤트를 통해 중단 신호를 전달합니다. 이 신호를 감지한 뒤 게임 세션을 drain하고 체크포인트를 저장한 다음 대체 인스턴스에서 상태를 복구하면 자동 이전 파이프라인을 구축할 수 있습니다.
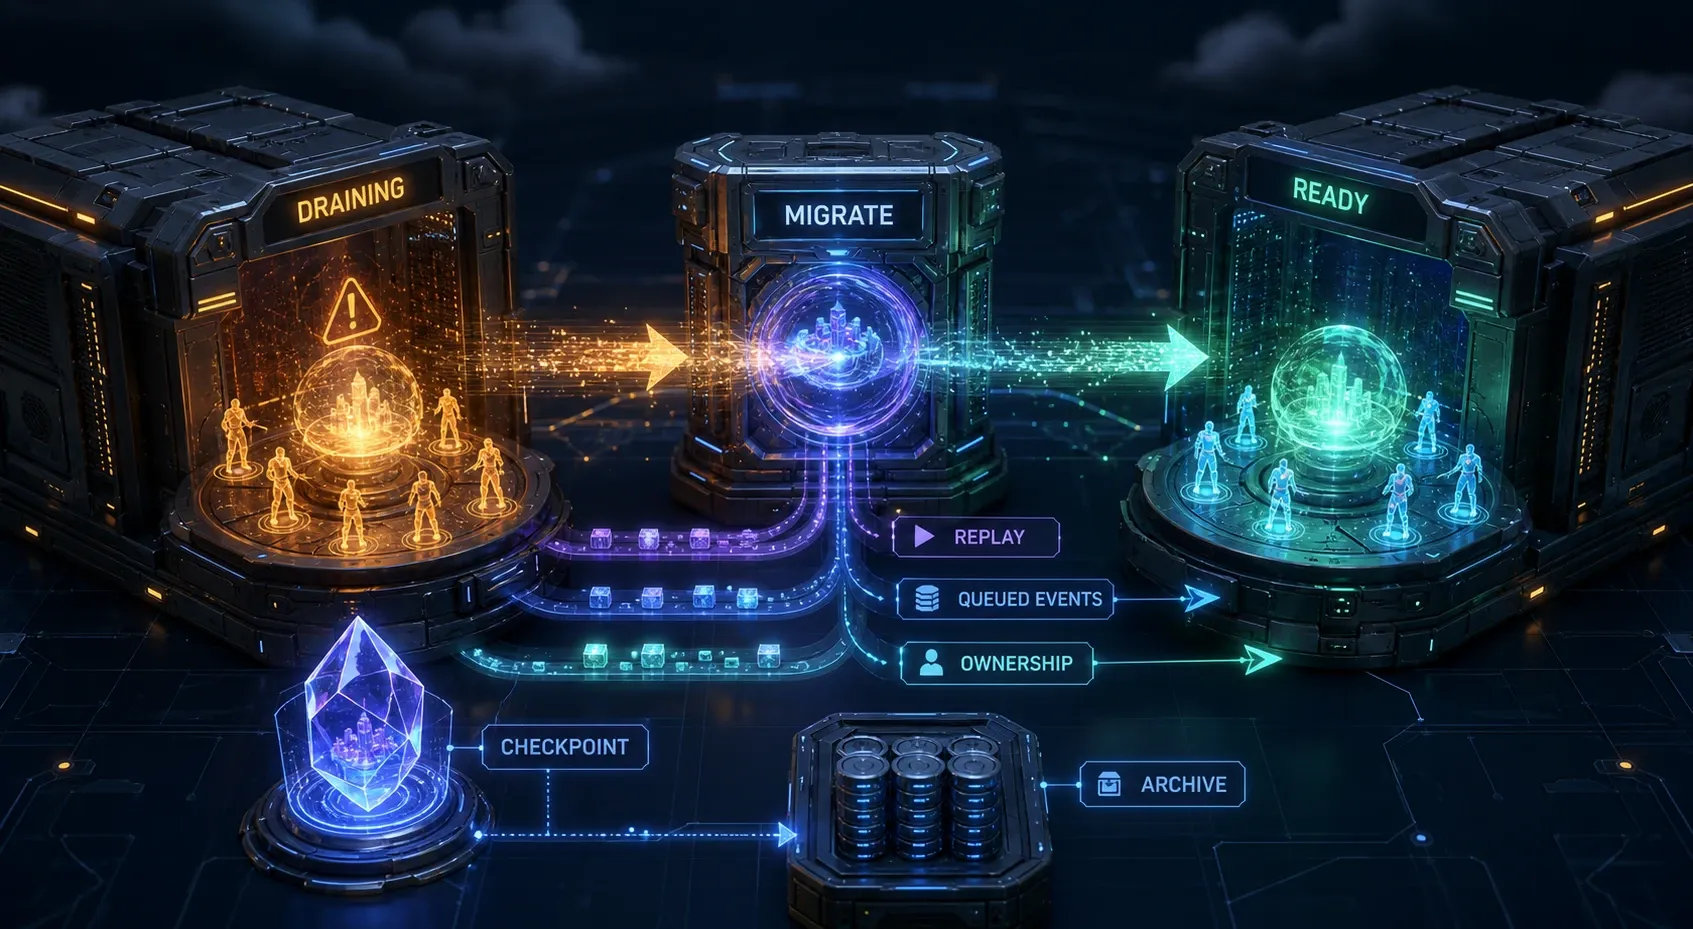
핵심은 실행 중인 프로세스를 그대로 복사하는 것이 아니라 체크포인트 저장 → 대체 서버 준비 → 세션 디렉터리 전환 → 기존 서버 fencing 순서를 보장하는 것입니다. 세션별 epoch와 조건부 쓰기를 사용하면 이전 서버와 새 서버가 동시에 세션을 소유하는 문제를 막을 수 있습니다.
AWS Spot 인스턴스 중단 사전 감지는 어떻게 동작하는가?
중단 감지는 인스턴스 내부의 IMDS 폴링과 중앙 이벤트 수집을 함께 사용하는 방식이 안정적입니다.
| 감지 경로 | 주요 신호 | 용도 | 주의점 |
|---|---|---|---|
| IMDS 폴링 | /latest/meta-data/spot/instance-action | 인스턴스 내부에서 즉시 drain 시작 | IMDSv2 토큰 필요 |
| EventBridge | EC2 Spot Instance Interruption Warning | 중앙 Coordinator에 중단 전달 | 중복 이벤트 처리 필요 |
| EventBridge | EC2 Instance Rebalance Recommendation | 중단 전 선제적 이전 시작 | 중단이 확정됐다는 뜻은 아님 |
| Auto Scaling 이벤트 | 인스턴스 종료 이벤트 | 용량 보충과 정리 | 이전 트리거로만 사용하면 늦을 수 있음 |
Spot 중단 알림은 일반적으로 중단 약 2분 전에 제공되지만, 하이버네이션은 절차가 바로 시작될 수 있고 알림은 최선 노력 방식이므로 이를 보장된 복구 시간으로 간주하면 안 됩니다. 네트워크 지연과 프로비저닝 시간을 고려하면 이 시간 안에 대규모 월드 상태를 새로 만들기는 어렵습니다. 평상시에도 주기적인 체크포인트를 저장하고 중단 시점에는 마지막 체크포인트 이후의 변경 로그만 재적용하는 구조가 적합합니다.
권장 아키텍처
| 구성 요소 | 책임 |
|---|---|
| Game Server Agent | IMDSv2 폴링, 세션 drain, 체크포인트 생성 |
| Amazon EventBridge | Spot 중단 및 Rebalance 이벤트 수집 |
| Amazon SQS | 이벤트 버퍼링과 재시도 |
| Migration Coordinator | 이전 상태 머신과 멱등성 관리 |
| Amazon DynamoDB | 세션 소유권, epoch, 체크포인트 메타데이터 저장 |
| Session Directory | 현재 게임 서버의 주소와 포트 관리 |
| Replacement Scheduler | Spot 우선 배치와 On-Demand fallback |
| Amazon S3 | 큰 체크포인트와 리플레이 파일 저장 |
flowchart TD
    A[Spot 인스턴스] -->|IMDSv2 폴링| B[Game Server Agent]
    A -->|EC2 이벤트| C[Amazon EventBridge]
    B --> D[Amazon SQS]
    C --> D
    D --> E[Migration Coordinator]
    E --> F[DynamoDB 세션 락과 epoch 갱신]
    E --> G[대체 게임 서버 시작]
    G --> H[체크포인트 복구와 헬스 체크]
    H --> I[Session Directory 원자적 전환]
    I --> J[기존 서버 drain 및 종료]
IMDS와 EventBridge는 동일한 중단을 각각 감지할 수 있습니다. 따라서 이벤트 ID만으로 중복을 제거하지 말고 instanceId + interruptionType + sessionId를 논리 키로 사용해야 합니다. Coordinator는 같은 키를 여러 번 받아도 이전 작업이 한 번만 실행되도록 설계합니다.
데디케이티드 게임 세션 이전은 어떻게 모델링할까?
세션 상태는 다음 세 가지로 나누는 것이 좋습니다.
- 복구 가능한 상태: 월드 시드, 플레이어 위치, 체력, 인벤토리, 퀘스트, 매치 규칙
- 변경 로그: 마지막 체크포인트 이후 발생한 입력과 게임 이벤트
- 복사하지 않는 런타임 상태: 소켓 객체, 스레드, OS 핸들, 커널 타이머, GPU 리소스
새 서버는 기존 프로세스의 메모리를 복사하는 대신 체크포인트와 이벤트 로그를 이용해 상태를 재구성합니다.
여기서 는 이벤트를 순서대로 재적용하는 연산입니다. 이벤트 순서가 게임 결과에 영향을 주는 장르라면 모든 이벤트에 단조 증가하는 sequence를 부여하고 누락·중복·역순 적용을 검증해야 합니다.
세션 레코드는 다음과 같이 구성할 수 있습니다.
{
  "sessionId": "match-7f3b",
  "epoch": 42,
  "status": "MIGRATING",
  "ownerInstanceId": "i-old",
  "targetInstanceId": "i-new",
  "checkpointVersion": 18420,
  "lastAppliedSequence": 901233
}epoch는 세션 소유권의 세대 번호입니다. 새 서버가 성공적으로 복구되면 epoch를 43으로 올리고 패킷 처리와 상태 저장 전에 현재 epoch의 소유자인지 확인합니다.
Spot 중단 감지 에이전트는 어떻게 구현할까?
IMDSv2 토큰을 발급받은 뒤 spot/instance-action을 짧은 주기로 폴링합니다. 응답이 없다는 것은 정상 상태일 수 있으므로 네트워크 오류와 실제 중단 경고를 구분해야 합니다.
import time
import requests

IMDS = "http://169.254.169.254"


def get_imds_token():
    response = requests.put(
        f"{IMDS}/latest/api/token",
        headers={"X-aws-ec2-metadata-token-ttl-seconds": "21600"},
        timeout=1,
    )
    response.raise_for_status()
    return response.text


def poll_spot_action(on_notice):
    token = get_imds_token()
    headers = {"X-aws-ec2-metadata-token": token}

    while True:
        response = requests.get(
            f"{IMDS}/latest/meta-data/spot/instance-action",
            headers=headers,
            timeout=1,
        )

        if response.status_code == 401:
            token = get_imds_token()
            headers["X-aws-ec2-metadata-token"] = token
            time.sleep(1)
            continue

        if response.status_code == 200:
            on_notice(response.json())
            return

        if response.status_code != 404:
            response.raise_for_status()

        time.sleep(5)
실서비스에서는 구조화 로그와 함께 spot_notice_detected, imds_poll_error, migration_deadline_seconds 같은 메트릭을 기록합니다. 에이전트가 신호를 받으면 즉시 신규 매칭을 막고 기존 서버를 DRAINING 상태로 전환해야 합니다.
세션 이전 상태 머신은 어떤 순서로 실행해야 하는가?
- DETECTED: 중단 신호를 수신하고 멱등 키로 이전 작업을 생성합니다.
- DRAINING: 신규 입장을 차단하고 기존 연결의 종료 정책을 적용합니다.
- CHECKPOINTING: 월드 상태와 마지막 이벤트 sequence를 저장합니다.
- ALLOCATING: 대체 서버를 시작합니다. Spot 용량이 없으면 On-Demand로 전환합니다.
- RESTORING: 새 서버가 체크포인트와 이벤트 로그를 복구합니다.
- VALIDATING: 맵, 모드, 프로토콜 버전, 체크포인트 해시와 마지막 sequence를 검증합니다.
- CUTOVER: Session Directory의 호스트와 epoch를 조건부로 교체합니다.
- FINALIZING: 기존 서버를 fencing하고 연결을 종료합니다.
이전 작업에 남은 여유 시간은 현재 시각을 포함해 다음처럼 계산할 수 있습니다.
T_remaining이 작아지면 전체 체크포인트를 기다리지 말고 마지막 정상 체크포인트와 이벤트 로그만 사용해야 합니다. 복구 시간이 deadline을 넘을 가능성이 높으면 플레이어를 매치 로비로 되돌리는 정책도 필요합니다.
DynamoDB 조건부 쓰기로 이중 소유를 막는 방법
세션 디렉터리 전환은 일반 업데이트가 아니라 조건부 쓰기로 처리해야 합니다. 기존 소유자의 epoch가 42일 때 새 서버만 43으로 승격할 수 있도록 제한합니다.
import boto3
from botocore.exceptions import ClientError

table = boto3.resource("dynamodb").Table("game-sessions")


def cutover(session_id, old_instance_id, new_instance_id, new_epoch):
    try:
        table.update_item(
            Key={"sessionId": session_id},
            UpdateExpression=(
                "SET ownerInstanceId = :new, epoch = :epoch, #status = :ready"
            ),
            ConditionExpression=(
                "ownerInstanceId = :old AND epoch < :epoch "
                "AND #status = :migrating"
            ),
            ExpressionAttributeNames={"#status": "status"},
            ExpressionAttributeValues={
                ":old": old_instance_id,
                ":new": new_instance_id,
                ":epoch": new_epoch,
                ":migrating": "MIGRATING",
                ":ready": "READY",
            },
        )
        return True
    except ClientError as error:
        if error.response["Error"]["Code"] == "ConditionalCheckFailedException":
            return False
        raise
TTL은 오래된 레코드 정리용으로만 사용해야 합니다. TTL 만료를 세션 락 해제 수단으로 사용하면 삭제 지연 때문에 이중 소유가 생길 수 있습니다. 모든 패킷 처리와 상태 저장 API에서 epoch를 검증하는 fencing 로직이 필요합니다.
네트워크 전환과 플레이어 재접속 정책
UDP 기반 게임은 기존 소켓을 새 인스턴스로 이동할 수 없습니다. 따라서 다음 방식 중 하나를 선택해야 합니다.
| 방식 | 장점 | 한계 |
|---|---|---|
| Directory 재조회 후 재접속 | 구현이 단순함 | 짧은 끊김 발생 |
| 고정 주소 뒤의 프록시 전환 | 클라이언트 주소 변경을 줄임 | 프록시 상태 관리 필요 |
| 애플리케이션 레벨 세션 재개 | 사용자 경험이 좋음 | 토큰과 순서 검증을 직접 구현해야 함 |
재접속 토큰에는 sessionId, 새 epoch, 플레이어 ID, 만료 시각, HMAC 서명을 포함합니다. 서버는 토큰 서명과 Session Directory의 현재 epoch를 비교해 이전 세대의 토큰을 거부해야 합니다.
resumeToken = HMAC-SHA256(secret, CanonicalEncode(sessionId, playerId, epoch, expiresAt))토큰 필드는 고정 폭 또는 길이 접두 방식처럼 모호하지 않은 규칙으로 직렬화하고, 실제 구현에서는 서명 비교도 상수 시간 방식으로 수행합니다. 서버 간 복구 통신은 private subnet에서 수행하고 보안 그룹으로 필요한 포트만 허용합니다. 클라이언트가 DynamoDB나 내부 Coordinator를 직접 호출하지 않도록 IAM 역할과 네트워크 경계를 분리해야 합니다.
실패 시나리오와 재시도 기준
- 중단 이벤트가 여러 번 도착하면 동일한 멱등 키로 한 번만 작업을 생성합니다.
- 체크포인트 저장 중 서버가 종료되면 마지막 정상 체크포인트와 이벤트 로그로 복구합니다.
- 대체 Spot 용량이 없으면 배치 전략을 변경하거나 On-Demand 용량으로 fallback합니다.
- 새 서버가 복구 후 응답하지 않으면
VALIDATING타임아웃을 발생시키고 다른 서버를 준비합니다. - 기존 서버가 전환 후에도 실행되면 epoch 검증으로 패킷과 상태 저장을 차단합니다.
- Coordinator가 재시작되면 DynamoDB 상태를 기준으로 워크플로를 재개합니다.
ALLOCATING, RESTORING, CUTOVER 단계마다 deadline과 최대 재시도 횟수를 설정해야 합니다. 무제한 재시도는 중단 유예 시간을 소진하고 세션 복구 가능성까지 낮출 수 있습니다.
운영 메트릭과 테스트 체크리스트
다음 지표를 세션과 인스턴스 단위로 수집합니다.
- Spot 중단 신호 감지 지연 시간
- 체크포인트 생성 시간과 크기
- 대체 서버 프로비저닝 시간
- 복구 성공률과 마지막 적용 sequence
- 감지부터 cutover까지의 p95 시간
- 플레이어 재접속률과 세션 이탈률
- stale epoch 패킷 차단 횟수
- On-Demand fallback 비율
테스트에서는 체크포인트 직전·도중·직후 종료, 중복 EventBridge 이벤트, 기존 서버와 새 서버의 동시 패킷 처리, DynamoDB 쓰기 실패, SQS 중복 전달, 대체 용량 부족을 반복적으로 재현해야 합니다.
자주 묻는 질문(FAQ)
Spot 인스턴스 중단 전에 항상 정확히 2분이 주어지나요?
아닙니다. 일반적으로 약 2분의 알림 시간이 제공되지만 실제 처리 시간은 감지 지연과 서비스 상태에 따라 달라질 수 있습니다. 평상시 체크포인트와 빠른 복구 경로가 필요합니다.
데디케이티드 게임 서버 프로세스를 다른 인스턴스로 그대로 옮길 수 있나요?
대부분의 경우 어렵습니다. 소켓과 OS 런타임 상태를 복사하기보다 체크포인트와 이벤트 로그로 새 프로세스를 재구성하고 클라이언트를 재접속시키는 방식이 일반적입니다.
EventBridge만 사용하면 IMDS 폴링이 필요한가요?
중앙 EventBridge 소비자만으로도 이전을 시작할 수 있지만 IMDS 폴링을 함께 두면 인스턴스 내부에서 즉시 drain을 시작할 수 있습니다. 두 경로는 중복을 전제로 멱등 처리해야 합니다.
정리
AWS Spot 인스턴스를 게임 서버에 사용할 때 중요한 것은 중단을 예외 상황이 아니라 정상적인 세션 상태 전이로 다루는 것입니다. IMDSv2와 EventBridge로 감지하고 DynamoDB 조건부 쓰기와 epoch fencing으로 소유권을 통제하며 체크포인트 기반 복구와 Session Directory 전환을 결합하면 데디케이티드 게임 세션을 자동으로 이전할 수 있습니다.
최종 파이프라인은 감지 → drain → 체크포인트 → 대체 서버 준비 → 복구 검증 → 원자적 전환 → 기존 서버 fencing으로 구성하고 각 단계에 deadline, 멱등성, 관측 지표를 부여해야 합니다.