FGT 유저 텍스트 피드백 AI 감성 분석: 핵심 요청을 우선순위로 바꾸는 법
플레이테스트(FGT) 설문과 자유 의견을 AI 감성 분석으로 분류하고 불만의 원인과 반복 요청을 우선순위로 정리하는 실무 절차를 설명합니다. Steam 출시 전 개선 항목을 빠르게 결정하는 방법을 제공합니다.
핵심 요약
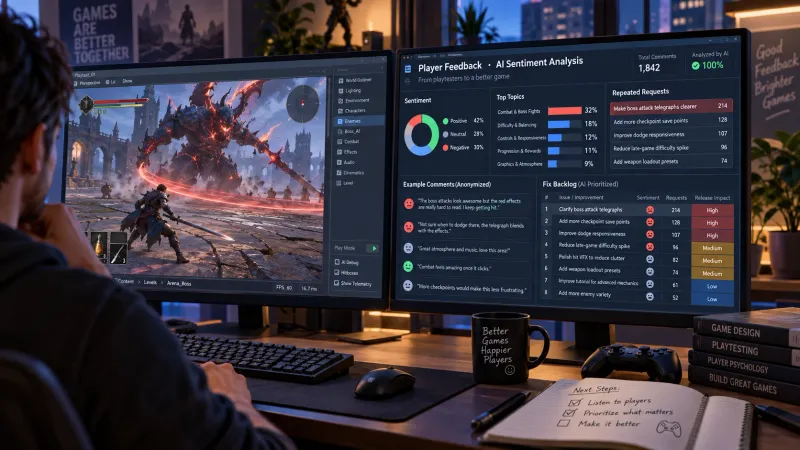
FGT 자유 의견은 긍정·부정 비율만 세면 의사결정에 도움이 되지 않는다. 감성(어조)·주제(무엇에 대한 말인가)·요청(무엇을 바꾸라는가)·영향도(출시 판단에 얼마나 중요한가)를 분리해 분석해야 한다.
가장 간단한 운영 방식은 원문을 보존한 채 LLM으로 구조화 분류하고 같은 주제의 반복 수와 부정 강도를 합산해 개선 백로그로 연결하는 것이다. AI 결과는 자동 확정값이 아니라 표본 원문을 사람이 검수하는 빠른 정리 도구로 사용한다.
FGT 텍스트 피드백 분석이 출시 의사결정에 중요한 이유
FGT(포커스 그룹 테스트)에서는 점수형 설문보다 자유 의견에 출시 리스크가 먼저 드러나는 경우가 많다. 예를 들어 “재미없다”는 문장 하나는 막연하지만 실제로는 튜토리얼 이해 실패, 전투 가독성 부족, 세션 길이 과다, 보상 동기 부족 중 하나일 수 있다.
Steam 출시 준비에서 중요한 것은 부정 의견의 총량이 아니라 구매 전환이나 환불 사유로 이어질 문제를 식별하는 것이다. 특히 데모와 FGT에서 반복되는 첫 30분 경험, 조작 불편, 성능 문제, 가격 대비 콘텐츠 인식은 위시리스트 전환과 초기 평가에 직접 영향을 줄 수 있다.
AI 감성 분석은 무엇을 분류해야 하는가?
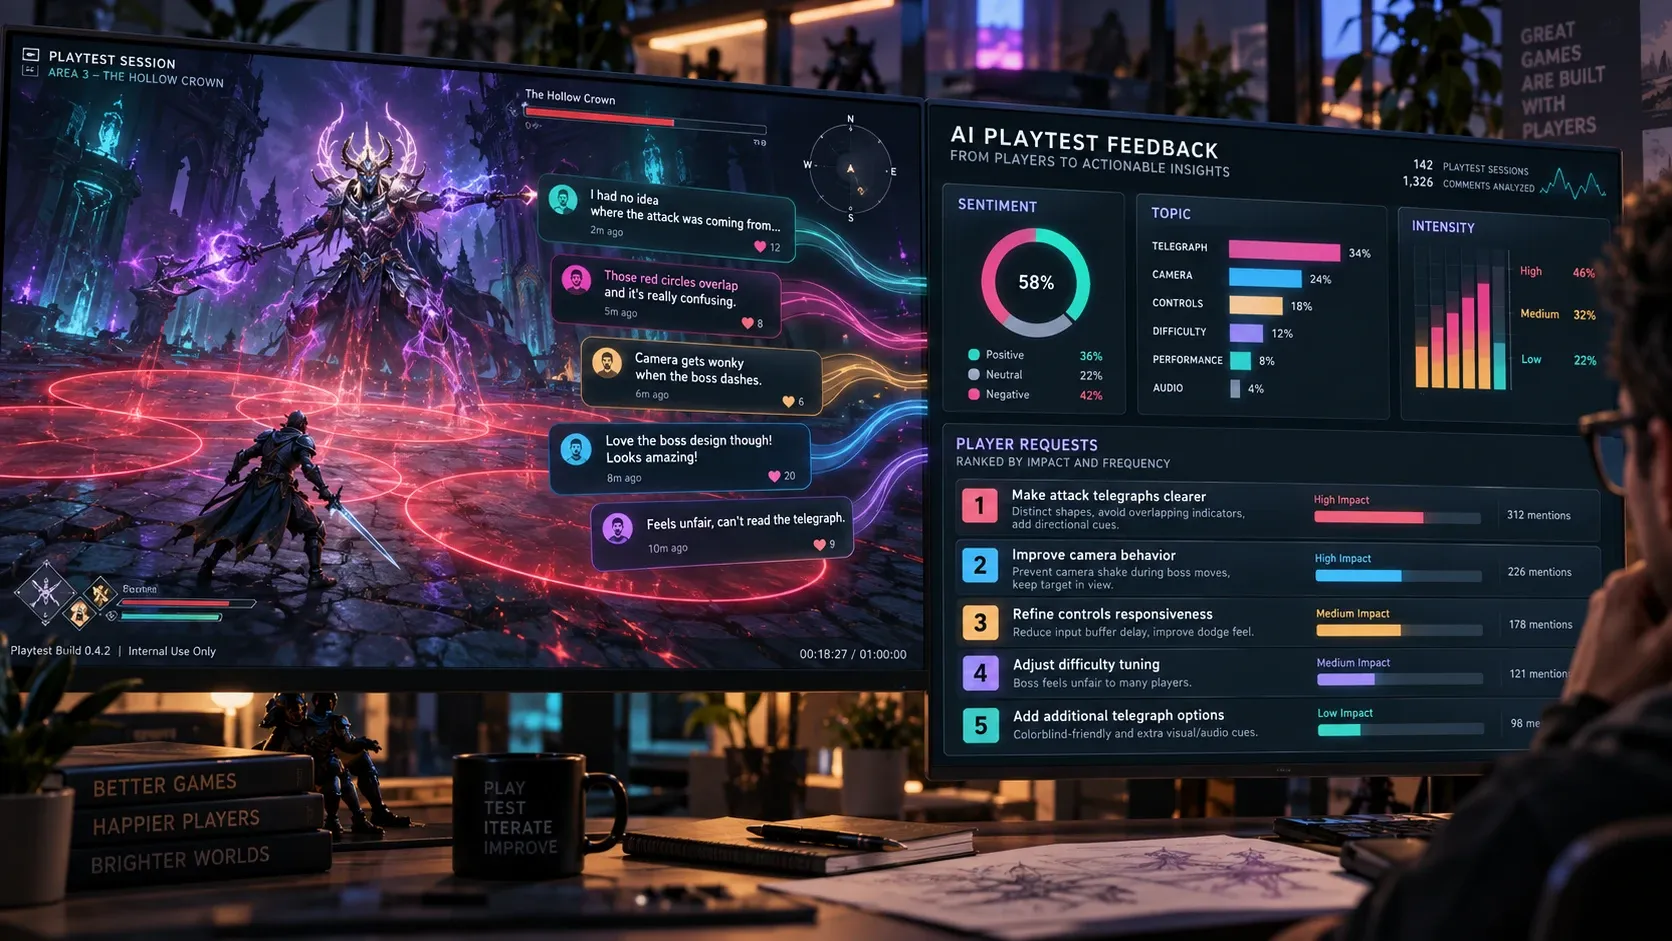
감성 분석을 ‘긍정/부정/중립’ 세 분류로 끝내면 “보스는 멋있지만 공격 범위가 읽히지 않는다” 같은 혼합 피드백을 잃는다. 한 문장에 여러 감성과 여러 요청이 있을 수 있으므로 원문을 의견 단위로 나눈 뒤 아래 필드를 함께 기록한다.
| 필드 | 예시 | 활용 목적 |
|---|---|---|
| sentiment | positive, negative, mixed, neutral | 경험의 방향 파악 |
| intensity | 1~5 | 불만 또는 만족의 강도 비교 |
| topic | combat-telegraph, tutorial, performance | 담당 영역 묶기 |
| request_type | bug, usability, balance, content, localization | 대응 방식 결정 |
| explicit_request | true, false | 실제 변경 요구와 감상 분리 |
| evidence | 원문 인용 | AI 분류 검수 |
| player_context | 장르 경험, 플레이 시간, 진행 구간 | 세그먼트별 해석 |
감성과 핵심 요청은 어떻게 다른가?
- 감성: “조작이 답답하다”처럼 경험이 좋았는지 나빴는지 나타낸다.
- 주제: 조작, 전투, UI, 성능처럼 문제가 발생한 영역을 나타낸다.
- 핵심 요청: “회피 입력 버퍼를 늘려 달라”처럼 팀이 실행할 수 있는 변경 요구다.
따라서 부정 감성이 강하더라도 요청이 없는 의견은 곧바로 기능을 추가할 근거가 아니다. 반대로 중립적인 문장이라도 “키보드 재설정을 지원해 달라”처럼 명확한 접근성 요구라면 높은 우선순위를 가질 수 있다.
FGT 유저 피드백을 AI로 분석하는 3단계
1. 원문과 맥락을 정리한다
AI에 보내기 전에 개인정보, 닉네임, 이메일, 외부 계정 ID를 제거한다. 설문 응답에는 최소한 response_id, playtime_minutes, build_version, progress_point, free_text를 붙인다.
빌드 버전은 반드시 필요하다. 0.6.2에서 이미 고친 버그가 0.6.3 FGT 데이터에 섞이면 오래된 부정 의견이 현재 출시 리스크처럼 보일 수 있다.
2. LLM에 고정된 JSON 스키마로 분류를 요청한다
프롬프트는 감상 요약이 아니라 구조화 추출을 요구해야 한다. 다음처럼 결과 형식을 제한하면 스프레드시트, SQL, BI 도구로 이어 붙이기 쉽다.
다음은 게임 FGT 자유 의견이다. 추측하지 말고 원문 근거가 있는 내용만 추출하라.
한 의견 안에 독립적인 이슈가 여러 개면 issues 배열로 분리하라.

반환 형식은 JSON만 사용한다.
{
  "overall_sentiment": "positive|negative|mixed|neutral",
  "issues": [
    {
      "topic": "combat|tutorial|controls|ui|performance|content|price-value|localization|other",
      "sentiment": "positive|negative|mixed|neutral",
      "intensity": 1,
      "request_type": "bug|usability|balance|content|accessibility|praise|none",
      "explicit_request": true,
      "request_summary": "한국어로 1문장",
      "evidence": "원문에서 30자 이내 인용"
    }
  ]
}

의견: "보스 연출은 좋았지만 2페이즈 장판 범위를 못 알아보겠다. 색약 모드나 윤곽선을 넣어 줬으면 한다."
이 예시의 핵심 요청은 ‘보스가 별로다’가 아니라 combat, accessibility, 명확한 공격 범위 표시다. 원문 인용 필드가 있어야 요약이 과장되거나 잘못 묶였는지 검수할 수 있다.
3. 반복도와 영향도로 우선순위를 계산한다
같은 토픽의 언급 수만 세면 소수의 장문 응답자가 결과를 왜곡할 수 있다. 응답자 단위 중복을 제거하고 기능별로 다음과 같은 단순 점수를 사용하면 충분하다.
UniquePlayers: 해당 이슈를 언급한 고유 테스터 수NegativeRate: 부정 또는 혼합 감성 비율MeanIntensity: 부정 강도 평균(1~5)ReleaseImpact: 1~3의 팀 판단값. 크래시, 진행 막힘, 구매 기대와 직결된 문제는 높게 둔다.
복잡한 예측 모델보다 이 점수와 원문 5~10개를 함께 보는 편이 FGT 규모에서는 빠르고 설명 가능하다.
핵심 요청을 Steam 출시 백로그로 연결하는 방법
AI가 만든 요약을 그대로 개발 티켓으로 옮기지 말고 출시 의사결정에 필요한 단위로 재정리한다.
| AI 분류 결과 | 출시 백로그 항목 | 판단 기준 |
|---|---|---|
| “튜토리얼에서 상호작용 키를 몰랐다” 반복 | 첫 상호작용 안내와 키 힌트 개선 | 초반 이탈과 연결되는가 |
| “프레임 드롭 때문에 회피가 어렵다” | 특정 구간 성능 프로파일링 및 최저 사양 재검증 | 조작 신뢰를 훼손하는가 |
| “가격에 비해 짧아 보인다” | Steam 페이지 콘텐츠 설명, 데모 범위, 가격 검토 | 기대치 불일치인가 |
| “한국어 번역이 어색하다” | 현지화 QA 및 용어집 수정 | 상점 페이지와 게임 내에서 반복되는가 |
‘가격이 비싸다’는 의견은 즉시 할인이나 가격 인하를 뜻하지 않는다. 실제 플레이 시간, 유사 장르 경험, 콘텐츠량 인식, 지역별 구매력, Steam 상점 페이지의 정보 부족을 함께 확인해야 한다. 가격 피드백은 제품 문제와 커뮤니케이션 문제를 구분하는 것이 먼저다.
AI 분류 결과는 왜 사람 검수가 필요한가?
LLM은 문맥을 빠르게 정리하지만 풍자·농담·번역체·장르 용어를 잘못 해석할 수 있다. 또한 언급량이 많다고 반드시 제품 전체에 치명적인 문제는 아니다.
다음 최소 검수 규칙이면 충분하다.
- 우선순위 상위 10개 토픽은 원문을 직접 읽는다.
- 토픽별로 무작위 원문 5개를 뽑아 AI 분류와 비교한다.
- 분류 오류가 반복되면 토픽 정의와 프롬프트 예시를 수정한 뒤 해당 배치만 다시 처리한다.
정확도는 단순 일치율보다 ‘출시 전 반드시 고쳐야 할 이슈’를 놓치지 않았는지로 평가하는 편이 실무에 맞다. 특히 크래시, 세이브 손상, 진행 불가, 접근성 관련 피드백은 언급 수가 적어도 별도 경보로 분리한다.
자주 묻는 질문 (FAQ)
FGT 응답이 30개뿐인데 AI 감성 분석이 필요한가?
가능하다. 자동화 절감 효과보다 의견을 일관된 토픽으로 묶고 원문 근거를 남기는 데 가치가 있다. 다만 이 규모에서는 AI 결과를 전수 검수하는 편이 낫다.
긍정 의견도 분류해야 하는가?
해야 한다. 반복되는 칭찬은 Steam 상점 페이지 문구, 트레일러 메시지, 데모의 첫인상 유지 포인트를 찾는 근거가 된다.
AI가 제안한 기능 요청을 모두 구현해야 하는가?
아니다. 반복도, 출시 영향, 구현 비용, 게임의 핵심 방향을 함께 본다. AI는 정리 담당이고 제품 방향을 결정하는 사람은 팀이다.
정리
FGT 텍스트 피드백의 목적은 감성 점수를 만드는 일이 아니라 테스터의 말에서 반복되는 문제와 실행 가능한 요청을 추출해 출시 리스크를 줄이는 것이다. 원문 보존, JSON 구조화, 단순 우선순위 점수, 상위 이슈 사람 검수의 네 단계면 과한 분석 체계 없이도 Steam 출시 백로그를 만들 수 있다.
처음에는 토픽을 8~10개로 제한하고 FGT 한 회차의 상위 요청만 확실히 처리하자. 분류 체계는 데이터가 쌓인 뒤에만 늘리면 된다.