Confluence·Notion 중복 문서 자동 탐지와 최신화 가이드 봇 설계 가이드
Confluence와 Notion에 쌓인 중복 문서를 자동 탐지하고 오래된 페이지를 최신화하는 가이드 봇을 설계하는 방법을 정리합니다. 임베딩 유사도, 문서 상태 점수, 사람 승인, 알림과 운영 지표까지 PM이 정해야 할 범위와 우선순위, 팀 문서화 운영 규칙을 실무 단계로 설명합니다.
핵심 요약
Confluence와 Notion의 중복 문서 탐지는 제목 비교만으로 해결하지 않고 문서 본문 임베딩의 코사인 유사도와 제목·링크·담당자 정보를 함께 평가해야 합니다. 최신화 가이드 봇은 문서를 자동으로 삭제하거나 병합하는 대신 중복 후보와 노후 문서를 근거, 담당자, 권장 조치와 함께 제시하고 사람의 승인을 거쳐 반영하는 방식이 안전합니다.
이 글에서는 게임 개발팀이 사용할 수 있는 중복 문서 자동 탐지 및 최신화 가이드 봇의 범위, 우선순위, 데이터 구조, 운영 지표를 PM 관점에서 정리합니다.
왜 게임 개발 문서는 중복되고 빠르게 오래되는가?
게임 프로젝트의 문서는 기획, 클라이언트, 서버, QA, 아트, 사업 담당자가 각자 다른 도구에서 작성합니다. 같은 기능이 다음과 같이 여러 이름으로 기록되기 쉽습니다.
- 기획 문서에는 전투 보정 규칙이 기록되고 서버 문서에는 전투 계산 규칙이 다시 기록됩니다.
- Notion에는 최신 밸런스 표가 있지만 Confluence에는 이전 버전의 표가 남아 있습니다.
- 담당자가 바뀌었지만 페이지 소유자와 리뷰 날짜가 변경되지 않습니다.
- 스프린트 회의록의 결정 사항이 원본 기능 문서에 반영되지 않습니다.
- 페이지 제목은 다르지만 본문과 링크 구조는 사실상 동일합니다.
문서 수가 늘어날수록 문제는 검색 실패보다 더 커집니다. 팀원은 어느 문서를 믿어야 할지 판단하는 데 시간을 쓰고 잘못된 규칙을 기준으로 구현하거나 QA 케이스를 작성할 수 있습니다.
어떤 문서를 자동화하고 어떤 판단을 사람에게 남길까?
자동화의 목표는 문서 관리자의 일을 모두 대체하는 것이 아니라 검토해야 할 후보를 높은 정확도로 줄이는 것입니다.
| 작업 | 봇의 역할 | 사람의 역할 |
|---|---|---|
| 문서 수집 | Confluence·Notion API에서 허용된 문서와 메타데이터 동기화 | 연결 범위와 권한 승인 |
| 동일 문서 탐지 | 해시와 임베딩으로 후보군 생성 | 실제 중복 여부 확인 |
| 최신 문서 추정 | 수정일, 상태, 릴리스 버전, 링크를 비교 | 기준 문서 지정 |
| 통합 제안 | 유지·병합·보관·재검토 조치 추천 | 최종 조치 승인 |
| 페이지 수정 | 승인된 변경안만 업데이트 | 변경 이력과 책임 확인 |
| 알림 | Slack, 이메일 또는 이슈 트래커로 전달 | 기한 내 처리 |
특히 자동 삭제와 자동 병합은 MVP에서 제외하는 편이 좋습니다. 페이지 간 권한, 링크, 첨부 파일, 결정 이력까지 완전히 이해하지 못한 상태에서 문서를 합치면 추적성이 훼손될 수 있습니다.
중복 문서는 어떻게 판별할까?
1단계: 문서 내용을 비교 가능한 형태로 정규화한다
원본 플랫폼마다 데이터 구조가 다르므로 먼저 공통 문서 모델로 변환합니다. 제목, 본문, URL, 작성자, 소유자, 스페이스 또는 데이터베이스, 태그, 상태, 생성일, 수정일, 릴리스 버전을 표준 필드로 저장합니다.
정규화 과정에서는 다음 값을 제거하거나 별도로 보관합니다.
- 목차와 자동 생성된 네비게이션
- 문서 템플릿의 고정 문구
- HTML, Markdown, Notion 블록의 표현 차이
- 날짜 형식과 사용자 표시명 차이
- 자동 생성된 댓글 및 변경 이력
완전히 동일한 문서는 콘텐츠 해시로 빠르게 찾을 수 있습니다.
from hashlib import sha256

def canonicalize(text: str) -> str:
    return ' '.join(text.lower().split())

def content_hash(text: str) -> str:
    normalized = canonicalize(text)
    return sha256(normalized.encode('utf-8')).hexdigest()
해시가 다르더라도 문장 순서나 표현만 바뀐 동일 문서가 있으므로 의미 기반 검색이 필요합니다.
2단계: 임베딩으로 의미가 비슷한 문서를 검색한다
예시 기술 스택은 Python 3.12, FastAPI, PostgreSQL 16, pgvector, sentence-transformers입니다. 한국어와 영어가 함께 쓰이는 게임 개발 문서라면 다국어 임베딩 모델을 선택하고 실제 문서 샘플로 검색 품질을 검증해야 합니다.
긴 문서는 한 번에 임베딩하지 말고 400~700토큰 단위로 나눕니다. 인접 청크에는 50토큰 안팎의 겹침을 두면 문단 경계에서 의미가 끊기는 문제를 줄일 수 있습니다. 검색 시에는 문서당 상위 10개 후보를 가져온 뒤 제목과 메타데이터를 포함해 재평가합니다.
3단계: 여러 신호를 하나의 중복 점수로 결합한다
중복 점수는 본문 유사도만으로 결정하지 않고 제목, 링크, 소유자 정보를 함께 사용합니다.
S_body: 정규화한 본문 임베딩 간 코사인 유사도S_title: 제목 토큰의 Jaccard 유사도S_link: 참조 링크 집합의 교집합 대비 합집합 비율S_owner: 같은 소유자면 1, 같은 팀이면 0.5, 관련성이 없으면 0
초기 운영 기준은 다음처럼 설정할 수 있습니다. 임계값은 정답 데이터셋으로 검증한 뒤 조정해야 합니다.
| 점수 | 분류 | 권장 조치 |
|---|---|---|
| 0.86 이상 | 높은 확률의 중복 | 담당자 승인 큐에 등록 |
| 0.75~0.85 | 중복 가능성 | 근거를 포함해 수동 검토 |
| 0.75 미만 | 낮은 확률 | 검색 인덱스에만 유지 |
임계값을 낮추면 놓치는 중복은 줄지만 오탐 알림이 늘어납니다. PM은 정확도 하나만 보지 말고 검토 가능한 알림량까지 함께 관리해야 합니다.
오래된 문서는 어떻게 최신화 우선순위를 계산할까?
수정일이 오래됐다는 이유만으로 폐기 대상이라고 판단하면 안 됩니다. 안정적인 시스템 문서나 출시된 콘텐츠 가이드처럼 오래됐지만 여전히 유효한 문서가 있기 때문입니다.
문서의 최신성은 문서 유형별 반감기와 최신 근거의 품질을 함께 계산하는 방식이 유용합니다.
age_days: 마지막 검토 이후 경과 일수half_life_days: 문서 유형별 최신성 반감기Q: 최신 릴리스 노트, 승인된 결정 문서, 담당자 확인 여부를 반영한 품질 계수F가 낮을수록 최신화 검토 우선순위가 높음
예를 들어 라이브 밸런스 문서의 반감기는 14일, 아트 파이프라인 문서는 90일로 다르게 설정할 수 있습니다. 최종 우선순위는 중복 가능성과 노후화를 함께 반영합니다.
봇은 점수만 보내지 말고 다음 정보를 함께 전달해야 합니다.
- 비교된 문서의 제목과 링크
- 겹치는 문단 또는 핵심 키워드
- 서로 다른 릴리스 버전
- 현재 소유자와 추천 검토자
- 유지, 병합, 보관, 재검토 중 추천 조치
- 추천 근거가 된 최신 결정 문서
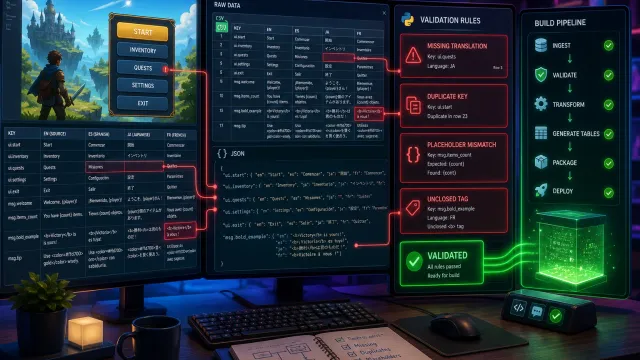
중복 탐지 및 최신화 봇은 어떤 구조로 만들까?
flowchart LR
  A[Confluence · Notion 수집] --> B[정규화 및 권한 필터]
  B --> C[해시·임베딩 생성]
  C --> D[유사도 후보 검색]
  D --> E{중복 또는 노후 후보}
  E -->|예| F[근거 포함 리뷰 티켓]
  E -->|아니오| G[지식 인덱스 유지]
  F --> H{담당자 승인}
  H -->|통합 또는 갱신| I[페이지 링크·변경 이력 기록]
  H -->|보류| J[재검토일 예약]
핵심 컴포넌트는 다섯 가지입니다.
- 수집기: 플랫폼별 API 호출, 페이지네이션, 재시도, 변경 시각 기준 증분 동기화를 담당합니다.
- 정규화기: Confluence의 본문 표현과 Notion 블록을 공통 문서 모델로 변환합니다.
- 검색 인덱스: PostgreSQL과 pgvector에 임베딩을 저장하고 근접 벡터 검색을 수행합니다.
- 판정기: 해시, 유사도, 문서 상태, 버전, 소유자 정보를 사용해 우선순위를 계산합니다.
- 가이드 봇: 검토자에게 추천 조치와 근거를 전달하고 승인 결과를 기록합니다.
플랫폼 어댑터는 다음처럼 최소 필드를 공통으로 반환하도록 설계합니다.
| 공통 필드 | Confluence 예시 | Notion 예시 |
|---|---|---|
source | confluence | notion |
external_id | 페이지 ID | 페이지 ID |
title | 페이지 제목 | 페이지 제목 또는 데이터베이스 속성 |
body | 본문 저장 형식에서 변환한 텍스트 | 중첩 블록을 순회해 추출한 텍스트 |
owner | 페이지 소유자 또는 담당자 | 사람 속성 또는 지정 담당자 |
updated_at | 마지막 수정 시각 | 마지막 편집 시각 |
version | 릴리스 또는 문서 버전 속성 | 버전 속성 또는 태그 |
url | 원본 페이지 URL | 원본 페이지 URL |
권한 필터는 임베딩 생성보다 먼저 적용해야 합니다. 사용자가 원본 문서를 볼 권한이 없다면 검색 결과와 봇 메시지에도 해당 문서가 노출되지 않아야 합니다.
MVP 범위와 우선순위는 어떻게 정할까?
PM은 처음부터 모든 문서를 정리하려고 하기보다 영향도가 높은 문서 유형을 좁혀야 합니다.
| 단계 | 범위 | 성공 조건 |
|---|---|---|
| MVP | 주요 프로젝트의 기획서와 릴리스 결정 문서, 후보 알림 | 중복 후보에 원본 링크와 근거가 표시됨 |
| 2단계 | 담당자 승인, 재검토일, Slack 또는 이슈 알림 | 처리 상태와 책임자가 추적됨 |
| 3단계 | 승인된 페이지의 요약 갱신과 문서 상태 자동 변경 | 변경 전후 diff와 이력이 보존됨 |
| 확장 | QA 테스트 계획, 서버 운영 문서, 아트 파이프라인 | 문서 유형별 임계값이 운영됨 |
첫 번째 대상은 게임 플레이 규칙, 출시 일정, 플랫폼별 빌드 정책처럼 변경 영향도가 높고 여러 팀이 참조하는 문서가 적합합니다. 개인 메모와 프로젝트 아카이브는 초기 인덱스에서 제외하면 오탐을 줄일 수 있습니다.
가이드 봇의 응답은 어떤 형식이어야 할까?
봇 메시지는 결론보다 검증 가능한 근거를 먼저 보여줘야 합니다. 다음 템플릿을 사용할 수 있습니다.
[문서 최신화 후보]
문서 A: 전투 보정 규칙 v3
문서 B: 서버 전투 계산 규칙
중복 점수: 0.89
최신성 점수: 문서 A 0.42, 문서 B 0.18

근거:
- 핵심 문단 4개가 의미상 유사함
- 문서 B는 릴리스 1.8 이후 검토 기록이 없음
- 문서 A는 최근 승인된 밸런스 결정 문서를 참조함

추천 조치: 문서 A를 기준 문서로 지정하고 문서 B에는 링크와 보관 상태를 기록
담당자: 서버팀 문서 담당자
응답 기한: 다음 스프린트 계획 회의 전
LLM을 사용해 요약할 수는 있지만 요약 결과만 보여줘서는 안 됩니다. 봇은 원문 문단 링크, 비교 점수, 사용한 기준 문서, 확신이 낮은 항목을 함께 표시해야 합니다. 근거를 찾지 못하면 추측하지 않고 검토 필요 상태로 남겨야 합니다.
운영 지표와 협업 규칙은 무엇을 봐야 할까?
PM이 매주 확인할 지표는 알림 수보다 실제 개선 효과에 초점을 맞춰야 합니다.
- 중복 후보 정밀도: 승인된 실제 중복 수를 전체 검토 후보 수로 나눈 값
- 오탐률: 중복이 아니라고 판정된 후보의 비율
- 평균 처리 시간: 알림 생성부터 승인 또는 보류까지 걸린 시간
- 미검토 문서 비율: 리뷰 기한을 넘긴 후보의 비율
- 최신화된 기준 문서 비율: 팀별 핵심 문서 중 최근 검토일이 있는 문서의 비율
- 자동 수정 롤백 수: 승인된 변경 이후 되돌린 횟수
운영 규칙도 문서로 고정해야 합니다.
- 모든 문서에는 소유자, 문서 상태, 마지막 검토일, 적용 릴리스가 있어야 합니다.
- 봇은 원본 페이지의 권한을 상속하고 권한이 없는 문서는 알림에서 제외합니다.
- 병합 전에는 원본 링크를 보존하고 변경 전후 diff를 저장합니다.
- 보류된 후보에는 다음 재검토일과 보류 사유를 남깁니다.
- 임베딩 모델, 임계값, 프롬프트가 바뀌면 탐지 결과의 버전을 기록합니다.
실패를 줄이는 검증 절차
실서비스에 연결하기 전에 과거 문서로 평가 세트를 만듭니다. PM 또는 각 직군 대표가 문서 쌍을 실제 중복, 부분 중복, 관련 없음으로 라벨링하고 봇 점수와 비교합니다.
다음 순서로 검증합니다.
- 읽기 전용 모드에서 문서를 수집하고 권한 누락 여부를 확인합니다.
- 정답 데이터셋에서 임베딩 모델과 중복 임계값을 비교합니다.
- 담당자에게 알림만 보내고 자동 수정은 잠급니다.
- 승인된 문서 유형 하나에 한해 변경 제안을 생성합니다.
- 변경 이력, 링크 보존, 롤백 절차를 확인한 후 적용 범위를 넓힙니다.
정기적으로 새로운 오탐과 누락 사례를 평가 세트에 추가해야 합니다. 문서 표현, 팀 구조, 프로젝트 상태가 바뀌면 과거에 적합했던 임계값도 달라질 수 있습니다.
자주 묻는 질문 FAQ
제목이 다르면 중복 문서로 탐지할 수 있나요?
가능합니다. 본문 임베딩 유사도와 링크 집합을 함께 비교하면 제목이 다른 문서도 후보로 찾을 수 있습니다. 다만 임계값 이하의 후보는 자동 병합하지 말고 수동 검토로 보냅니다.
오래된 문서는 자동으로 삭제해도 되나요?
권장하지 않습니다. 오래된 문서도 결정 이력이나 감사 근거로 필요할 수 있으므로 보관 상태와 기준 문서 링크를 남기는 방식이 안전합니다.
Confluence와 Notion을 동시에 사용하면 무엇을 기준으로 삼아야 하나요?
도구 자체보다 문서 유형별 공식 저장 위치를 정해야 합니다. 예를 들어 출시 결정은 Confluence, 실시간 운영 체크리스트는 Notion처럼 소유 팀과 변경 흐름에 맞춰 기준 시스템을 지정하고 다른 위치에는 링크를 남깁니다.
정리
중복 문서 자동 탐지 봇의 핵심은 AI 요약 기능이 아니라 신뢰할 수 있는 문서 상태 모델과 승인 흐름입니다. Python 3.12 기반 수집·정규화 파이프라인, 임베딩과 pgvector 검색, 다중 신호 점수, 담당자 승인, 변경 이력 보존을 작은 범위에서 시작하면 운영 가능한 문서화 시스템으로 확장할 수 있습니다.
PM은 탐지 정확도만 관리하지 말고 누가 어떤 근거로 문서를 최신 기준으로 승인했는지까지 추적해야 합니다. 그래야 봇이 또 하나의 알림 도구가 아니라 팀의 지식 부채를 줄이는 협업 장치가 됩니다.