데디케이티드 서버 자동 웜업과 매치 수요 예측 스케줄러 구현
멀티플레이 게임의 매치 대기 시간을 줄이는 데디케이티드 서버 자동 웜업과 매치 수요 예측 스케줄러 설계법을 정리합니다. .NET 8, PostgreSQL 16, Redis 7 기반 예제와 중복 실행 방지, 비용 제어, 보안, 관측성까지 다룹니다.
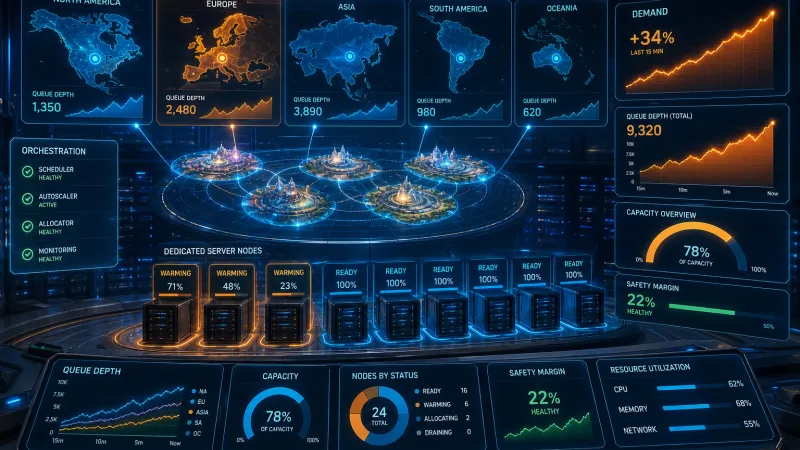
핵심 요약
매치 수요 예측 스케줄러는 5분 단위의 매치 시작 수, 대기열 길이, 지역별 접속자 수를 기반으로 앞으로 필요한 서버 수를 계산하고 프로비저닝 리드타임만큼 미리 웜업합니다.
핵심은 예측값 자체보다 안전 여유율, 중복 실행 방지, 상한선, 장애 시 보수적인 폴백 정책입니다.
왜 데디케이티드 서버 웜업이 필요한가?
멀티플레이 게임에서 매치메이킹이 완료된 직후 서버를 생성하면 다음과 같은 지연이 발생합니다.
- 컨테이너 이미지와 게임 바이너리 다운로드
- 노드 스케줄링 및 네트워크 연결
- 게임 프로세스 부팅과 맵 로딩
- 인증 서버, 데이터베이스, 릴레이 서버와의 초기 연결
- 헬스 체크와 매치메이커 등록
이 지연은 플레이어가 체감하는 매치 대기 시간에 직접 반영됩니다. 반대로 모든 서버를 항상 실행하면 유휴 컴퓨팅 비용과 운영 비용이 커집니다.
따라서 목표는 서버를 무조건 많이 실행하는 것이 아니라 수요가 증가하기 전에 필요한 수만큼 준비하는 것입니다.
| 상황 | 관찰 지표 | 기본 대응 |
|---|---|---|
| 매치 수요가 안정적임 | 대기열과 서버 가동 수의 변동이 작음 | 최소 웜 풀 유지 |
| 단기 피크가 예상됨 | 매치 시작 수와 대기열 증가율 상승 | 예측 리드타임만큼 선행 웜업 |
| 예측 실패 가능성이 큼 | 신규 이벤트, 패치, 외부 장애 | 안전 여유율과 수동 오버라이드 적용 |
| 수요가 급감함 | 서버 이용률과 매치 생성률 하락 | 유휴 서버 드레이닝 후 축소 |
전체 구조는 어떻게 설계할까?
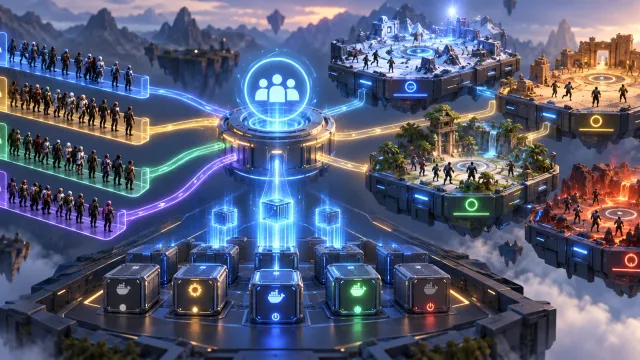
권장 구조는 실시간 매치 요청 경로와 예측 배치 경로를 분리하는 것입니다. 매치메이커는 예측 모델을 기다리지 않고 현재 준비된 서버를 사용해야 합니다.
예측 스케줄러는 별도 작업으로 실행되며 오케스트레이터의 원하는 서버 수를 갱신합니다.
- 게임 클라이언트: 매치 요청과 재접속
- 매치메이커: 플레이어 그룹 구성 및 서버 할당
- 메트릭 수집기: 매치 이벤트와 대기열 상태 수집
- PostgreSQL 16: 원천 이벤트와 집계 버킷 저장
- Redis 7: 최신 예측값, 분산 락, 짧은 TTL 상태 저장
- 예측 배치: Python 3.12와 LightGBM 또는 설명 가능한 통계 모델 사용
- 스케줄러: .NET 8 ASP.NET Core
BackgroundService - 오케스트레이터: Kubernetes, Agones 또는 사내 서버 프로비저닝 API
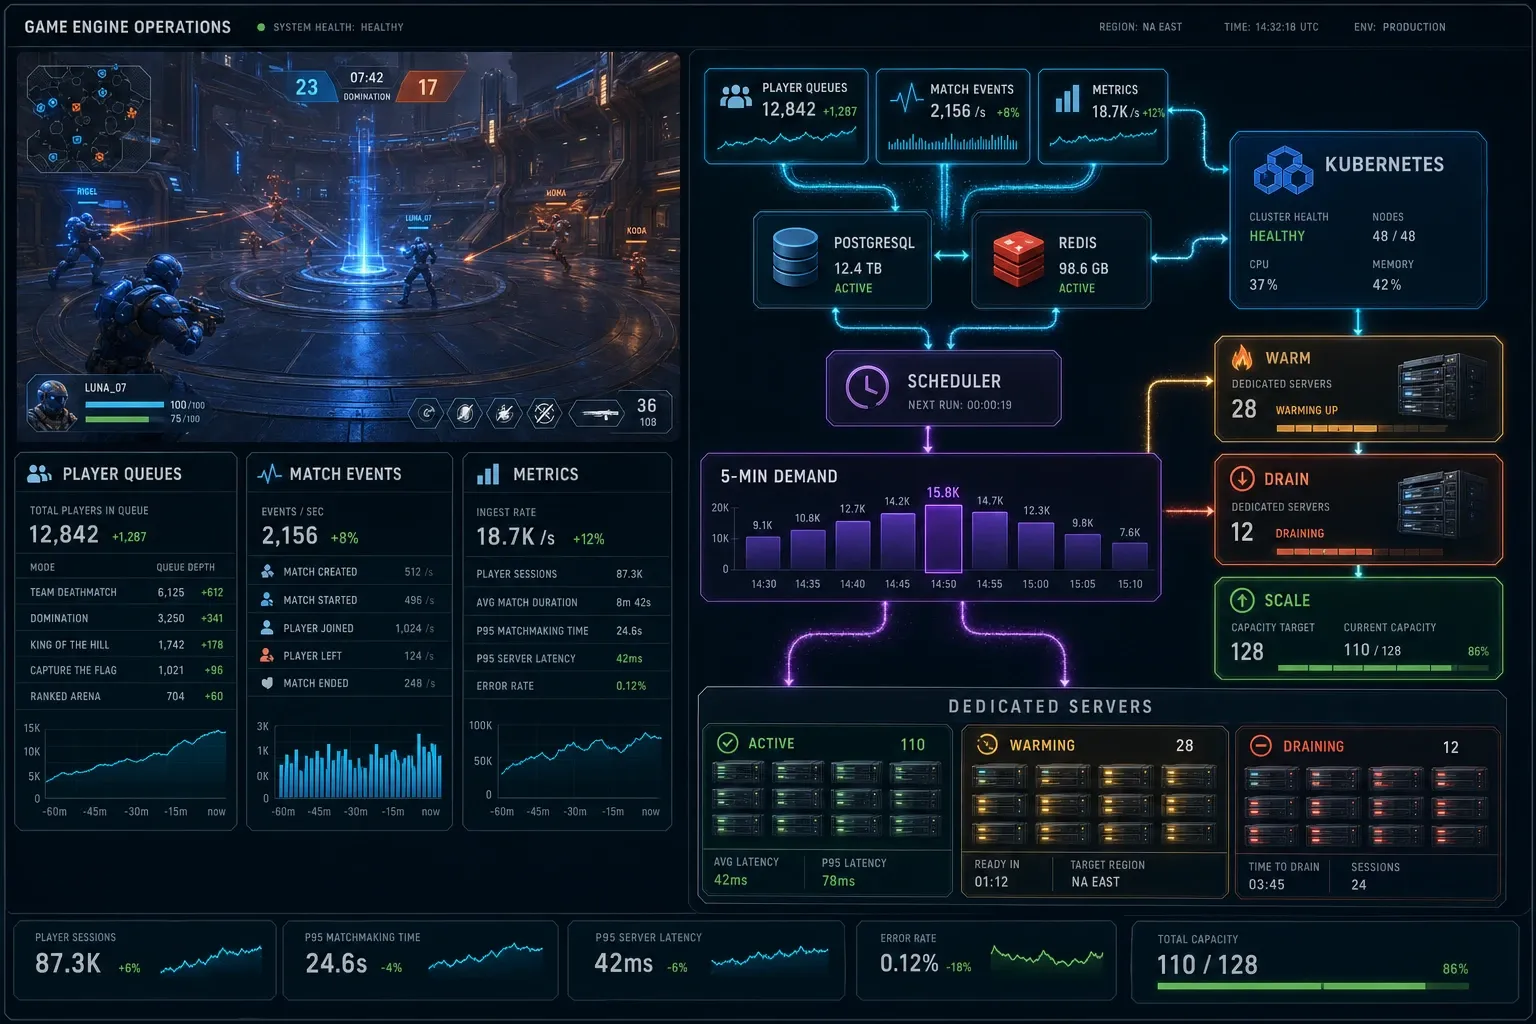
flowchart TD
    A[매치 이벤트 수집] --> B[5분 단위 집계]
    B --> C[수요 예측 배치]
    C --> D[필요 서버 수 계산]
    D --> E[분산 락과 상한선 검증]
    E --> F[오케스트레이터 웜업 요청]
    F --> G[헬스 체크 및 매치메이커 등록]
    G --> H[예측 오차와 지연 시간 기록]
    H --> B
매치 수요는 어떻게 예측할까?
처음부터 복잡한 딥러닝 모델을 도입할 필요는 없습니다. 5분 단위의 서버 웜업에서는 추론 지연보다 예측 안정성과 운영 가능성이 중요합니다.
1. 예측 단위를 정의한다
다음 중 무엇을 예측하는지 먼저 고정해야 합니다.
| 예측 대상 | 장점 | 주의점 |
|---|---|---|
| 신규 매치 수 | 매치메이커와 직접 연결하기 쉬움 | 매치 길이 변화를 반영해야 함 |
| 동시 접속 플레이어 수 | 서버 용량 계산이 직관적임 | 게임 모드별 수용 인원을 관리해야 함 |
| 필요한 서버 수 | 바로 스케일 조정 가능 | 모델이 인프라 상태에 종속됨 |
실무에서는 신규 매치 수 또는 동시 접속 플레이어 수를 먼저 예측한 뒤 필요한 서버 수로 변환하는 방식을 권장합니다.
2. 시간 버킷과 특징량을 만든다
5분 버킷마다 다음 데이터를 집계합니다.
match_started_count: 시작된 매치 수queue_depth_p50,queue_depth_p95: 대기열 길이queue_wait_p95_ms: 대기 시간의 95퍼센타일active_players: 지역과 게임 모드별 동시 접속자 수ready_servers: 즉시 할당 가능한 서버 수- 요일, 시간대, 공휴일 여부
- 패치, 시즌 시작, 게임 내 이벤트 플래그
- 최근 1시간의 매치 시작 증가율
집계 이벤트는 중복 전송될 수 있으므로 event_id에 유니크 제약을 설정합니다.
CREATE TABLE match_demand_bucket (
    bucket_start TIMESTAMPTZ NOT NULL,
    region TEXT NOT NULL,
    mode TEXT NOT NULL,
    match_started_count INTEGER NOT NULL,
    queue_depth_p95 INTEGER NOT NULL,
    queue_wait_p95_ms INTEGER NOT NULL,
    active_players INTEGER NOT NULL,
    ready_servers INTEGER NOT NULL,
    is_event_window BOOLEAN NOT NULL DEFAULT FALSE,
    PRIMARY KEY (bucket_start, region, mode)
);

CREATE TABLE processed_match_event (
    event_id UUID PRIMARY KEY,
    received_at TIMESTAMPTZ NOT NULL DEFAULT now()
);
3. 필요한 서버 수를 계산한다
예측 모델이 다음 5분 동안의 최대 동시 접속 플레이어 수를 반환한다고 가정합니다.
서버 한 대가 수용할 수 있는 플레이어 수를 C_server, 안전 여유율을 b라고 하면 목표 서버 수는 다음과 같이 계산할 수 있습니다.
예를 들어 예측 동시 접속자가 180명이고 서버 한 대의 정원이 40명, 안전 여유율이 25퍼센트라면 목표 서버 수는 6대입니다.
여기서 b는 고정 상수가 아니라 예측 오차와 프로비저닝 실패율에 따라 조정해야 합니다.
forecast_players = 180
server_capacity = 40
safety_buffer = 0.25

target_servers = ceil(180 * 1.25 / 40)
# target_servers = 6
초기 모델은 다음처럼 구성할 수 있습니다.
- 기준선: 최근 동일 요일·시간대의 가중 이동 평균
- 통계 모델: 지수 평활 또는 SARIMA
- 피처 기반 모델: Python 3.12와 LightGBM
- 이벤트가 많은 게임: 이벤트 플래그와 패치 버전을 포함한 LightGBM
가중 이동 평균은 결과를 설명하기 쉽고 장애 시 폴백으로 사용하기 좋습니다.
LightGBM을 사용하더라도 최근 관측값, 동일 시간대 과거값, 이벤트 여부를 함께 사용하고 예측값에 상한선을 적용해야 합니다.
자동 웜업 스케줄러는 어떻게 구현할까?
스케줄러는 일정한 주기로 다음 작업을 수행합니다.
- 최신 집계 데이터와 예측값을 읽습니다.
- 지역과 게임 모드별 목표 서버 수를 계산합니다.
- 현재
ready,starting,draining서버 수를 조회합니다. - 프로비저닝 리드타임을 고려해 부족한 수만큼 웜업합니다.
- 수요가 줄면 새 매치 배정을 중단하고 드레이닝합니다.
웜업 리드타임은 이미지 다운로드, 프로세스 시작, 헬스 체크 시간을 합친 값입니다. 예측 구간의 시작 시점이 다음과 같아야 합니다.
예측값이 현재 준비 서버보다 적더라도 즉시 종료하지 말고 최소 유지 시간과 드레이닝 시간을 적용해야 합니다.
그래야 짧은 수요 변동 때문에 서버가 반복적으로 생성되고 종료되는 플래핑을 막을 수 있습니다.
.NET 8 BackgroundService 예제
다음 예제는 서버 수를 계산하는 핵심 로직을 단순화한 형태입니다.
실제 코드에서는 오케스트레이터 API 호출과 재시도 정책을 별도 서비스로 분리합니다.
using System;

public sealed record WarmupDecision(int DesiredServers, string Reason);

public static class WarmupPlanner
{
    public static WarmupDecision Decide(
        int forecastPlayers,
        int readyServers,
        int startingServers,
        int serverCapacity,
        double safetyBuffer,
        int minServers,
        int maxServers)
    {
        var desired = (int)Math.Ceiling(
            forecastPlayers * (1.0 + safetyBuffer) / serverCapacity);

        desired = Math.Clamp(desired, minServers, maxServers);

        var availableSoon = readyServers + startingServers;
        var deficit = Math.Max(0, desired - availableSoon);
        var reason = deficit > 0 ? "Forecast" : "Steady";

        return new WarmupDecision(desired, reason);
    }
}
스케줄러에서 중요한 부분은 함수의 계산식보다 상태 전이와 중복 실행 제어입니다.
여러 인스턴스의 BackgroundService가 동시에 실행되면 같은 서버를 중복 생성할 수 있습니다.
public async Task RunOnceAsync(CancellationToken cancellationToken)
{
    var lockKey = $"warmup-lock:{region}:{mode}";
    await using var lease = await distributedLock.TryAcquireAsync(
        lockKey,
        TimeSpan.FromSeconds(30),
        cancellationToken);

    if (lease is null)
        return;

    var snapshot = await repository.GetSnapshotAsync(
        region,
        mode,
        cancellationToken);

    var decision = Decide(
        snapshot.ForecastPlayers,
        snapshot.ReadyServers,
        snapshot.StartingServers,
        snapshot.ServerCapacity,
        snapshot.SafetyBuffer,
        snapshot.MinServers,
        snapshot.MaxServers);

    var idempotencyKey = $"{region}:{mode}:{snapshot.ForecastBucket:O}:{decision.DesiredServers}";

    await orchestrator.SetDesiredCapacityAsync(
        region,
        mode,
        decision.DesiredServers,
        idempotencyKey,
        cancellationToken);
}
프로비저닝 API는 멱등 키를 받아 같은 용량 변경 요청의 재시도를 중복 반영하지 않도록 설계합니다.
다만 Redis 락의 TTL이 만료되면 기존 작업이 끝나기 전에 다른 인스턴스가 락을 얻을 수 있으므로, 오래 걸리는 작업은 락 갱신이나 fencing token 같은 보호 장치와 함께 사용하고 API 쪽에서도 멱등성을 보장해야 합니다.
서버 상태와 매치메이커 등록은 어떻게 관리할까?
서버가 생성되었다고 바로 매치메이커에 등록하면 안 됩니다. 다음 상태를 명확히 분리해야 합니다.
| 상태 | 의미 | 매치 할당 |
|---|---|---|
requested | 웜업 요청이 생성됨 | 불가 |
starting | 노드 또는 프로세스 시작 중 | 불가 |
ready | 헬스 체크와 버전 검증 완료 | 가능 |
allocated | 매치에 할당됨 | 해당 매치 전용 |
draining | 신규 매치를 받지 않고 종료 대기 | 불가 |
terminated | 프로세스 종료 또는 삭제 완료 | 불가 |
ready 판정에는 단순한 TCP 포트 응답보다 게임 프로세스의 상태를 반영해야 합니다.
예를 들어 프로토콜 버전, 맵 로딩 완료 여부, 데이터베이스 연결, 인증 토큰 검증, 현재 플레이어 수를 함께 확인합니다.
또한 클라이언트가 전달한 맵 이름이나 서버 실행 인자를 그대로 셸 명령에 연결하면 안 됩니다.
게임 모드와 맵은 서버 측 허용 목록에서 ID로 변환하고 실행 환경에는 검증된 값만 전달해야 합니다.
예측 오류와 비용을 어떻게 제어할까?
예측 기반 자동화는 오차를 전제로 설계해야 합니다. 모델이 과소 예측하면 대기 시간이 늘고 과대 예측하면 유휴 비용이 증가합니다.
필수 가드레일
- 지역·게임 모드별 최소 서버 수
- 시간당 최대 생성 서버 수
- 계정 또는 리전별 비용 예산
- 예측값의 최대 증가폭
- 최근 데이터가 오래되었을 때의 보수적 폴백값
- 오케스트레이터 장애 시 마지막 정상 용량 유지
- 운영자가 즉시 적용할 수 있는 수동 목표 용량
예측값은 다음 기준으로 품질을 측정합니다.
| 지표 | 용도 |
|---|---|
| MAE | 평균적인 플레이어 수 오차 확인 |
| RMSE | 큰 오차에 높은 가중치 부여 |
| WAPE | 트래픽 규모가 다른 지역 비교 |
| 예측 구간 적중률 | 안전 여유율의 적절성 판단 |
| p95 매치 대기 시간 | 실제 사용자 경험 검증 |
| 유휴 서버 비율 | 비용 효율 검증 |
모델 정확도만 최적화하면 안 됩니다. 목표 함수는 대기 시간과 비용을 함께 포함해야 합니다.
여기서 w_wait, w_cost, w_churn은 게임의 서비스 목표에 따라 조정합니다.
경쟁 게임은 대기 시간 가중치를 높이고 비동기 게임은 비용 가중치를 높일 수 있습니다.
보안과 데이터베이스 운영에서 주의할 점은?
웜업 스케줄러는 서버 생성 권한을 갖기 때문에 일반 매치메이커보다 높은 권한을 요구할 수 있습니다. 다음 원칙을 적용합니다.
- 스케줄러 전용 서비스 계정과 최소 권한 RBAC 사용
- 프로비저닝 API의 리전, 게임 모드, 이미지 버전 허용 목록 적용
- 예측 입력 이벤트의 인증과 중복 이벤트 방지
- Redis 락에 TTL 설정
- 모든 생성·삭제 요청에 요청 ID와 승인 주체 기록
- 플레이어 개인정보를 예측 피처에 직접 저장하지 않기
- 데이터 보관 기간과 삭제 정책 명시
- 비밀 값은 환경 변수보다 Secret Manager 또는 Kubernetes Secret 사용
PostgreSQL 집계 테이블은 bucket_start, region, mode를 기준으로 파티셔닝할 수 있습니다.
오래된 원천 이벤트는 장기 보관이 필요하지 않다면 집계 완료 후 별도 보관 정책에 따라 삭제하거나 저비용 저장소로 이동합니다.
운영 중 무엇을 관측해야 할까?
대시보드는 인프라 상태와 사용자 경험을 함께 보여줘야 합니다.
- 예측 영역: 예측 플레이어 수, 실제 플레이어 수, MAE, WAPE
- 서버 영역:
requested,starting,ready,allocated,draining수 - 사용자 영역: 매치 대기 시간 p50·p95, 매치 실패율, 재접속률
- 비용 영역: 서버 시간, 리전별 유휴 시간, 시간당 생성·종료 횟수
- 안정성 영역: 웜업 API 오류율, 헬스 체크 실패율, 분산 락 충돌 수
알림은 서버 수 자체보다 결과 중심으로 구성합니다. 예를 들어 ready 서버가 많아도 매치 대기 시간 p95가 목표를 초과하면 실제 용량 계산이나 서버 등록 과정에 문제가 있을 수 있습니다.
구현 순서: 최소 기능부터 안전하게 확장하기
1단계: 고정 웜 풀을 만든다
지역과 게임 모드별로 최소 서버 수를 고정하고 서버 생성부터 종료까지 상태 전이를 검증합니다.
이 단계에서는 예측 모델을 연결하지 않고 프로비저닝 API, 헬스 체크, 매치메이커 등록을 안정화합니다.
2단계: 관측 데이터를 집계한다
매치 이벤트와 서버 상태를 5분 버킷으로 저장합니다.
이벤트 중복 제거, 지연 이벤트 처리, 시간대 기준을 먼저 결정해야 합니다.
3단계: 기준선 예측을 연결한다
최근 동일 요일·시간대의 가중 이동 평균으로 예측값을 계산합니다.
실제 수요와 예측값을 비교하는 리포트를 만든 뒤 안전 여유율을 조정합니다.
4단계: 상한선과 수동 오버라이드를 추가한다
최대 서버 수, 비용 예산, 이벤트 기간의 고정 용량을 적용합니다.
예측 배치가 실패해도 서비스가 자동으로 0대까지 축소되지 않도록 마지막 정상값과 최소 용량을 사용합니다.
5단계: 피처 기반 모델로 개선한다
기준선이 충분히 안정된 뒤 Python 3.12와 LightGBM을 도입합니다.
이벤트, 패치 버전, 지역별 시간대, 최근 증가율을 피처로 추가하고 오프라인 검증 결과가 기준선보다 나을 때만 운영에 반영합니다.
자주 묻는 질문 FAQ
예측 주기는 몇 분이 적당한가?
프로비저닝 시간이 3~10분이라면 5분 버킷이 실용적인 시작점입니다.
이미지 크기와 노드 확보 시간이 길수록 예측 구간을 더 앞당겨야 합니다.
예측 모델이 실패하면 서버를 모두 종료해야 하는가?
아닙니다. 마지막 정상 예측값과 최소 서버 수를 유지해야 합니다.
데이터가 오래되었거나 예측 신뢰도가 낮으면 보수적인 안전 용량을 적용합니다.
Kubernetes HPA만 사용하면 충분한가?
일반적인 CPU·메모리 기반 HPA는 이미 실행 중인 워크로드의 스케일 조정에는 적합하지만 게임 서버 프로세스의 부팅 시간과 매치 수요를 직접 예측하지는 못합니다.
Agones나 별도 프로비저닝 계층과 수요 예측 스케줄러를 함께 사용하는 편이 적합합니다.
정리
데디케이티드 서버 자동 웜업의 핵심은 예측 모델을 복잡하게 만드는 것이 아니라 매치 수요를 일정한 시간 버킷으로 집계하고 서버 프로비저닝 리드타임 전에 목표 용량을 반영하는 것입니다.
운영 가능한 설계는 다음 조건을 만족해야 합니다.
- 5분 단위 수요 집계와 실제 대기 시간 검증
- 최소·최대 서버 수와 비용 예산
- Redis 분산 락과 프로비저닝 멱등 키
ready상태를 기준으로 한 매치메이커 등록- 예측 실패 시 마지막 정상값을 사용하는 폴백
- 모델 정확도뿐 아니라 대기 시간, 유휴 비용, 플래핑을 함께 평가
이 구조를 먼저 안정화하면 이후 게임 이벤트, 시즌 시작, 패치 배포 같은 외부 신호를 예측 피처로 추가해 자동 웜업의 정확도와 비용 효율을 단계적으로 개선할 수 있습니다.