Behavior Tree와 LLM 연동으로 예측 불가능한 보스 페이즈 설계하기
Behavior Tree의 검증 가능한 실행 흐름에 LLM의 상황 해석과 전술 후보 생성을 결합해, 공정성을 잃지 않으면서 매 전투가 달라지는 보스 페이즈를 설계하는 방법을 단계별로 설명합니다.
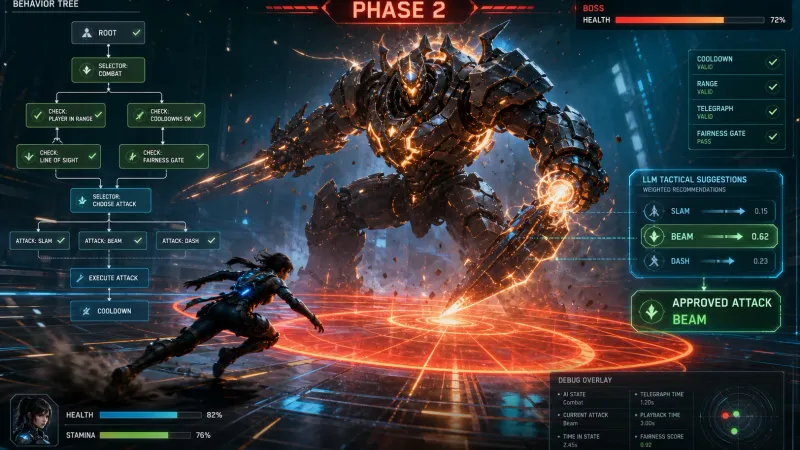
핵심 요약
Behavior Tree(BT)와 LLM을 함께 쓰는 보스 AI의 핵심은 LLM에게 보스의 최종 행동 권한을 주지 않는 것이다. BT가 쿨다운, 사거리, 무적 시간, 페이즈 규칙, 텔레그래프를 검증하고 LLM은 허용된 전술 후보 중 현재 전투 맥락에 어울리는 선택 또는 우선순위만 제안하게 하면 예측 불가능성과 공정성을 함께 확보할 수 있다.
예측 불가능한 보스 페이즈는 왜 필요한가?
고정 로테이션 보스는 플레이어가 학습하기 쉽고 밸런싱도 편하다. 반면 공략이 굳어진 뒤에는 전투가 암기 시험으로 변하기 쉽다. 반대로 완전한 무작위 행동은 패턴을 읽을 수 없게 만들어 패배 원인을 불명확하게 만든다.
좋은 변주란 무작위 행동이 아니라 플레이어가 이해 가능한 규칙 안에서 우선순위가 달라지는 것이다. 예를 들어 보스가 체력 50% 이하에서 광역 공격을 쓸 수는 있어도 플레이어가 최근 세 번 회피에 성공했다는 이유만으로 선딜 없이 즉사기를 쓰면 안 된다.
| 접근 방식 | 장점 | 문제점 | 권장 용도 |
|---|---|---|---|
| 고정 로테이션 | 학습과 테스트가 쉽다 | 반복 전투가 단조롭다 | 튜토리얼 보스 |
| 가중치 랜덤 | 구현이 간단하다 | 맥락 없는 반복이 생긴다 | 일반 몬스터 |
| LLM 직접 제어 | 표현력이 높다 | 재현성·안전성이 낮고 운영 비용이 높을 수 있다 | 권장하지 않음 |
| BT 검증 + LLM 전술 제안 | 변주와 공정성을 양립한다 | 설계 계약이 필요하다 | 반복 전투형 보스 |
Behavior Tree와 LLM의 역할은 어떻게 나눌까?
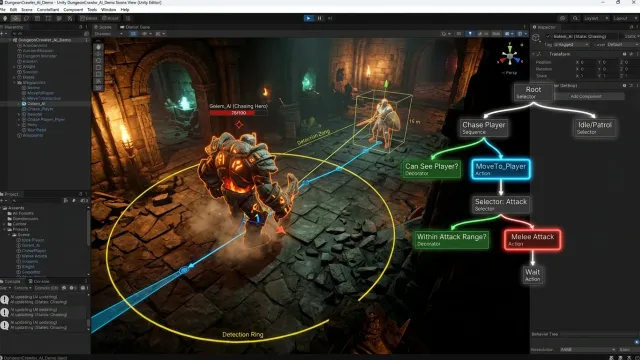
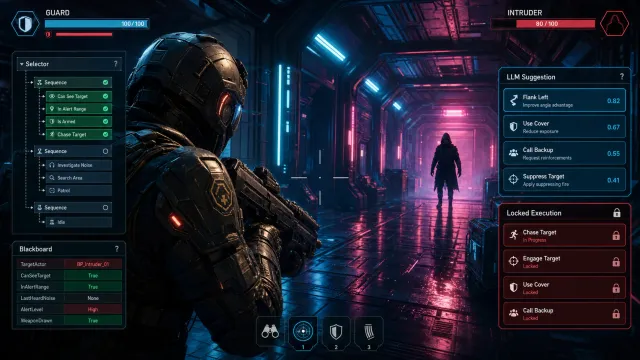
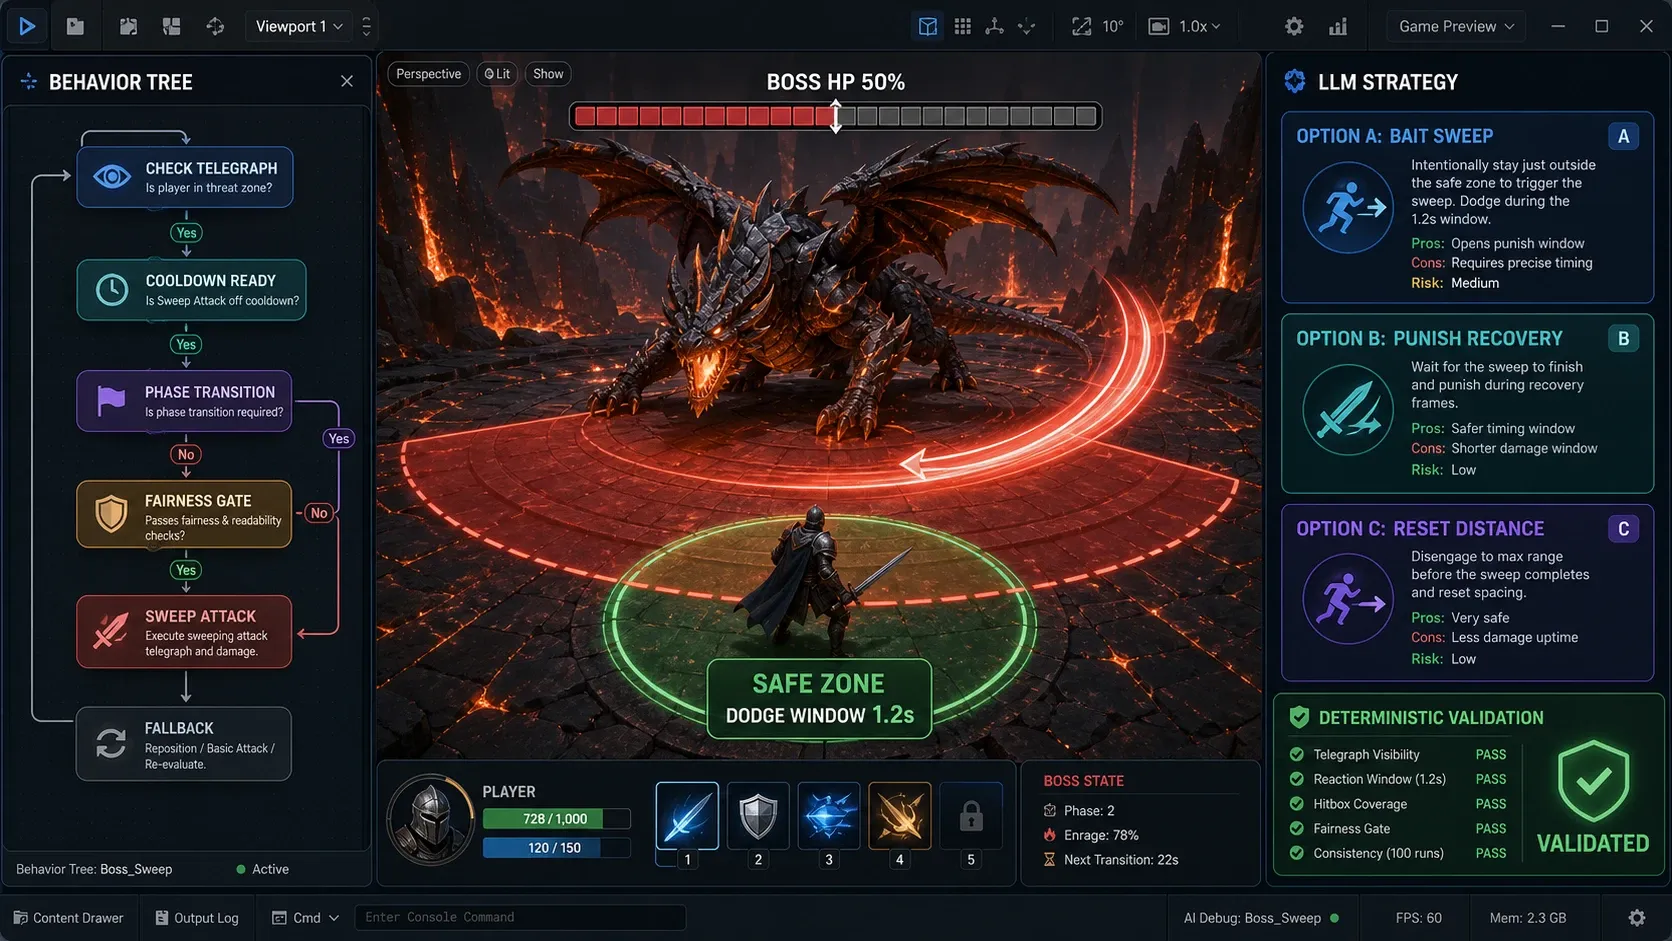
BT는 전투 규칙을 집행하는 결정론적 실행기다. LLM은 플레이 로그를 압축해 전술적 의도를 제안하는 보조 시스템이다. 이 경계를 지키면 네트워크 지연, 모델 오류, 프롬프트 변동이 있어도 전투 규칙이 무너지지 않는다.
flowchart LR
    A[전투 상태 수집] --> B[BT 가드 평가]
    B -->|허용 행동 목록| C[LLM 전술 제안]
    C --> D[스키마 검증]
    D --> E[BT 가중치 조정]
    E --> F[행동 실행]
    D -->|실패 또는 시간 초과| G[기본 가중치 선택]
    G --> F
BT가 반드시 소유해야 하는 것
- 행동 가능 조건: 거리, 시야, 자원, 쿨다운, 페이즈 잠금
- 공정성 규칙: 최소 선딜, 피격 판정, 회피 가능 창, 연속 제어 제한
- 전환 규칙: 체력 임계값, 부위 파괴, 시간제한, 연출 완료 여부
- 실패 처리: LLM 응답 지연·형식 오류·금지 행동 요청 시 기본 정책
LLM에 맡길 수 있는 것
- 플레이어 행동 요약: 근접 유지, 원거리 견제, 회복 의존, 특정 방향 회피
- 전술 의도 선택: 압박, 거리 축소, 공간 분할, 회복 방해, 리듬 전환
- 허용 행동의 우선순위 제안
- 전투 로그에 맞는 짧은 대사 또는 연출 문구 생성
LLM 출력은 자유 문장이 아니라 제한된 JSON 계약으로 받아야 한다. 예시는 다음과 같다.
{
  "intent": "close_distance",
  "preferred_actions": ["dash_slash", "arena_wall"],
  "avoid_actions": ["meteor"],
  "reason": "플레이어가 원거리에서 회복을 반복한다"
}preferred_actions에 있는 기술도 BT 가드를 통과해야만 실행한다. dash_slash가 쿨다운 중이거나 플레이어가 이미 벽에 몰린 상태라면 선택되지 않는다.
예측 불가능하지만 공정한 보스 페이즈는 어떻게 구현할까?
1. 페이즈별 행동 풀을 먼저 고정한다
LLM 연동 전에 페이즈마다 가능한 행동, 금지 조합, 최소 간격을 데이터로 정의한다. 예를 들어 2페이즈에서 돌진과 벽 생성은 가능하지만 두 기술을 3초 이내에 연속 사용하지 못하게 한다.
{
  "phase": 2,
  "actions": ["dash_slash", "arena_wall", "projectile_fan", "meteor"],
  "cooldown_seconds": {
    "dash_slash": 8,
    "arena_wall": 14,
    "projectile_fan": 6,
    "meteor": 20
  },
  "forbidden_pairs": [["arena_wall", "meteor"]],
  "minimum_telegraph_seconds": 0.8
}
2. 전투 상태를 작은 피처로 요약한다
모델에 원본 이벤트 로그를 그대로 넘기면 비용과 해석 흔들림이 커진다. 최근 10~20초를 기준으로 정규화된 피처만 전달하는 편이 낫다.
| 피처 | 예시 | 설계 목적 |
|---|---|---|
player_distance_avg | 12.4m | 근접 압박 또는 원거리 견제 판단 |
dodge_success_rate | 0.83 | 회피 가능한 패턴의 반복 완화 |
heal_count_20s | 2 | 회복 차단 전술 검토 |
arena_edge_time | 0.61 | 벽 몰이 패턴 제한 |
recent_damage_taken | 0.42 | 과도한 압박 방지 |
플레이어 압박도는 단일 지표보다 여러 피처를 합친 값으로 제한하는 편이 안전하다.
pressure가 0.75 이상이면 BT는 강한 추적기, 벽 생성, 장시간 제어 기술의 가중치를 낮추거나 차단한다. 이 값은 LLM이 바꿀 수 없는 밸런싱 상수로 둔다.
3. LLM 제안을 가중치 보정으로만 반영한다
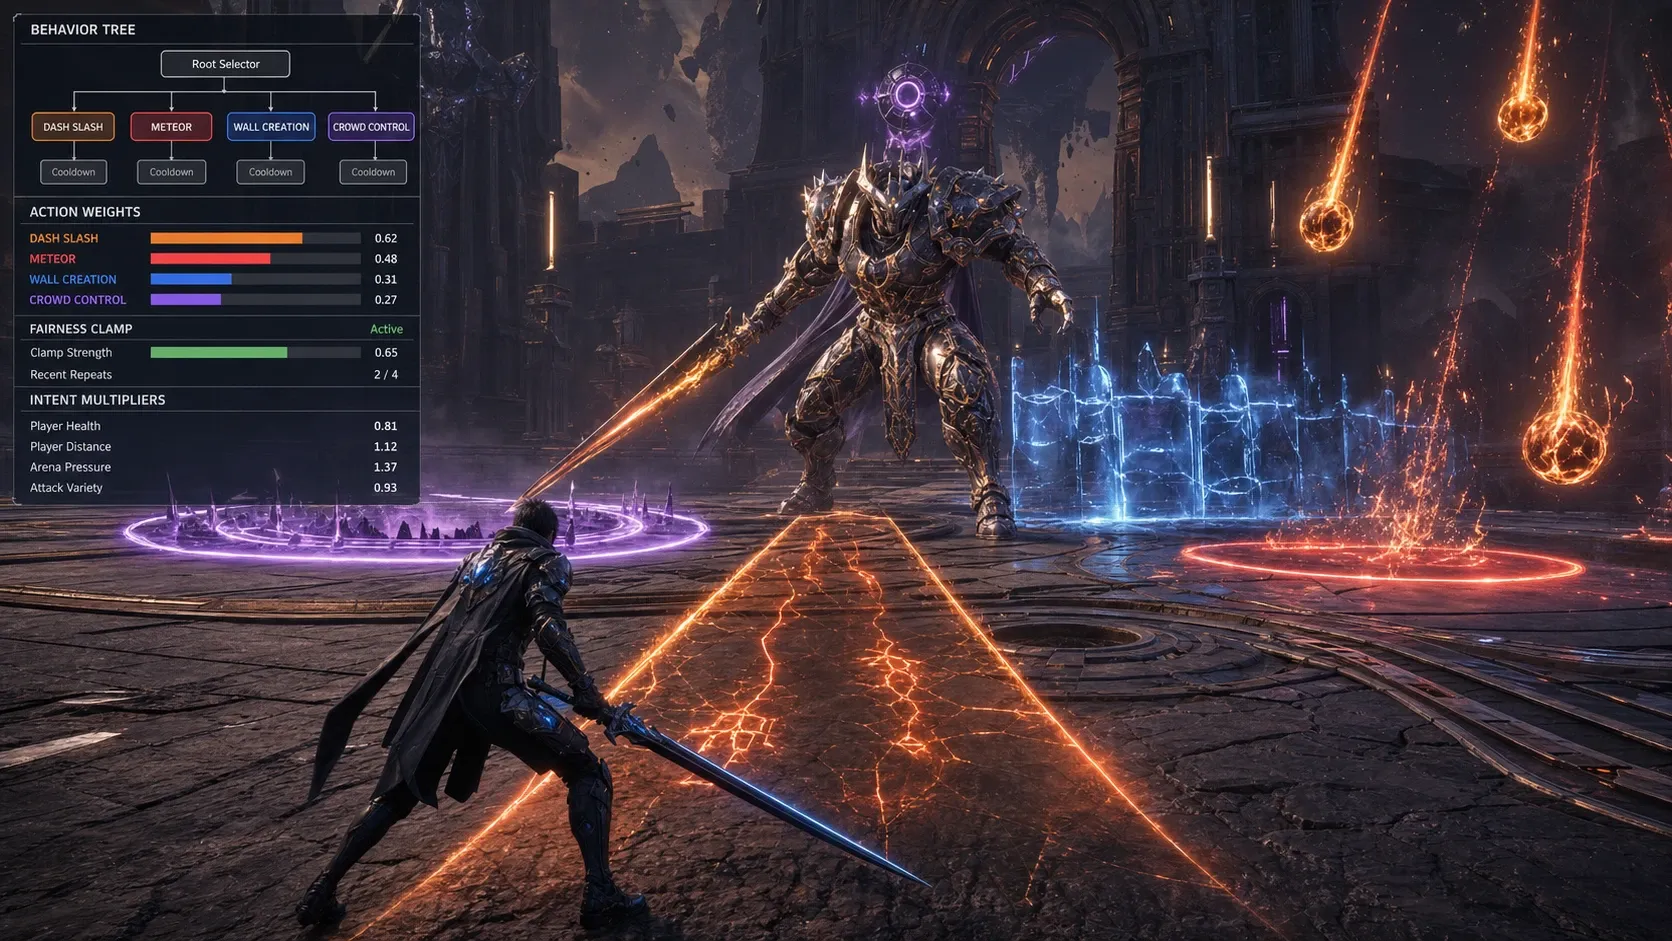
기본 선택 가중치를 baseWeight로 두고 LLM 의도와 현재 전투 조건으로 최종 가중치를 계산한다.
예를 들어 close_distance 의도일 때 dash_slash의 intentMultiplier는 1.4, meteor는 0.6으로 설정할 수 있다. 단, fairnessMultiplier는 압박도가 높을수록 강한 기술의 값을 0에 가깝게 낮춘다.
이 구조에서는 LLM이 기발한 전술을 제안해도 보스가 설계된 기술 목록 밖으로 나가지 않는다.
LLM 호출은 매 프레임 해야 할까?
아니다. 실시간 전투에서 매 프레임 호출하면 비용, 지연, 재현성 문제가 모두 커진다. 다음 이벤트 중 하나에서만 호출하는 방식이 충분하다.
- 페이즈 진입 직후
- 보스가 행동 3~5회를 마친 뒤
- 플레이어가 회복·다운·부위 파괴 같은 큰 상태 변화를 만든 뒤
호출 결과는 10~20초 동안 유지하고 BT는 그 사이에도 일반적인 가중치 랜덤으로 계속 행동한다. 응답이 300~500ms를 넘거나 스키마 검증에 실패하면 이전 전술 또는 기본 가중치를 사용한다.
밸런싱에서 반드시 측정할 지표는 무엇인가?
LLM 연동 보스는 평균 난이도뿐 아니라 전투 경험의 분산을 측정해야 한다. 같은 장비 수준에서 특정 전술이 지나치게 높은 승률 또는 낮은 승률을 만들면 변주가 아니라 불안정성이다.
| 지표 | 확인할 문제 | 권장 해석 |
|---|---|---|
| 페이즈별 사망률 | 특정 전술의 과도한 압박 | 전술별로 분리해 비교 |
| 평균 회피 가능 시간 | 텔레그래프 부족 | 기술별 하한 설정 |
| 동일 행동 연속 횟수 | 랜덤 반복 | 상한 또는 감쇠 적용 |
| 전술별 승률 분산 | 난이도 편차 | 평균보다 분산을 우선 확인 |
| LLM 폴백 비율 | 운영 안정성 | 높으면 프롬프트·타임아웃 점검 |
테스트에는 고정 시드와 기록 재생이 필요하다. LLM 응답 자체를 전투 로그에 저장하면 같은 전투 상태와 같은 제안을 다시 재생할 수 있어 버그와 밸런스 문제를 추적하기 쉬워진다.
자주 묻는 질문 (FAQ)
LLM이 없으면 이 설계를 구현할 수 없나?
가능하다. 규칙 기반 전술 선택기나 가중치 테이블만으로도 같은 구조를 만들 수 있다. LLM은 플레이 스타일을 넓게 해석하거나 대사와 전술 톤을 함께 바꾸고 싶을 때만 추가한다.
LLM이 금지된 공격을 선택하면 어떻게 하나?
선택을 실행하지 않는다. 스키마 검증 후에도 BT의 쿨다운, 페이즈, 공정성 가드를 모두 통과한 행동만 후보에 남겨야 한다.
PvP 보스나 경쟁 콘텐츠에도 적합한가?
보통은 제한적으로만 적합하다. 결과의 재현성과 공정성 기대치가 높은 콘텐츠에서는 LLM을 대사, 연출, 비핵심 전술 추천에 한정하는 편이 안전하다.
정리
예측 불가능한 보스 페이즈의 목표는 플레이어를 무작정 놀라게 하는 것이 아니라 읽을 수 있는 규칙 안에서 새로운 대응을 요구하는 것이다. BT는 전투의 안전장치로 남기고 LLM은 행동 범위를 넓히지 않는 전술 편집기로 사용하자. 그러면 보스는 매번 다른 압박을 만들면서도 패배 이유를 납득할 수 있는 상대가 된다.