AI 유저 페르소나 10종 예시로 신규 미션 클리어 타임 예측하기
행동 유형별 페르소나와 플레이 텔레메트리를 이용해 신규 미션의 예상 클리어 타임을 추정하는 제안 방법을 수식, 데이터 구조, Python 예제로 설명합니다.
핵심 요약
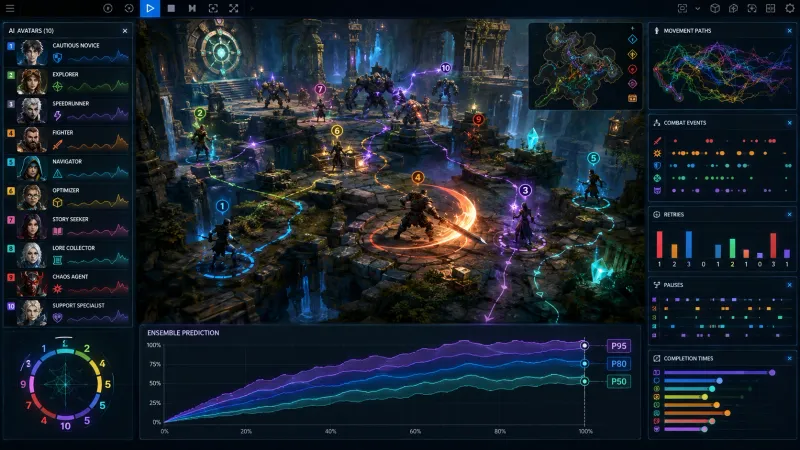
이 글에서 ‘AI 유저 페르소나’는 자율 에이전트가 아니라 과거 플레이 텔레메트리에서 구분한 행동 유형별 통계 모델을 뜻합니다. 행동 유형별 추정값과 불확실성을 함께 검토하면 단일 평균값만으로 판단할 때 놓칠 수 있는 클리어 타임 편차를 살펴볼 수 있습니다. 다만 아래 방법은 실제 프로젝트 데이터로 검증해야 하는 제안이며, 자동 예측의 정확도를 보장하지 않습니다.
AI 유저 페르소나로 클리어 타임을 예측해야 하는 이유는 무엇인가?
신규 미션의 예상 플레이 시간은 디자이너의 플레이 테스트나 과거 미션 데이터를 기준선으로 삼아 추정할 수 있습니다. 평균값 하나만 사용하면 플레이어 유형별 차이를 따로 살피기 어렵습니다.
같은 미션의 플레이 시간에 영향을 줄 수 있는 행동 차이의 예시는 다음과 같습니다.
- 전투를 빠르게 끝내는 플레이어와 안전하게 반복하는 플레이어
- 메인 목표만 수행하는 플레이어와 모든 수집 요소를 확인하는 플레이어
- 실패 후 즉시 재시도하는 플레이어와 공략을 검색한 뒤 돌아오는 플레이어
- 이동 최적화에 익숙한 플레이어와 길을 잃기 쉬운 플레이어
따라서 목표값을 평균 클리어 타임 하나로 두기보다 페르소나별 P50, P80, P95 예측값을 함께 살펴볼 수 있습니다. P50은 예측 분포의 중앙값이고 P80은 모델 분포에서 80%가 그 값 이하에 놓이는 분위수입니다. 보정되지 않은 모델의 P80이 모든 느린 플레이어의 상한을 보장하는 것은 아니므로 실제 데이터에서 포함률을 검증해야 합니다.
어떤 AI 유저 페르소나 10종을 정의할까?
이 글의 페르소나는 연령이나 성별 같은 인구통계 대신 게임 내 행동 로그에서 관측할 수 있는 플레이 패턴으로 정의하는 분석 단위입니다. 실제 유저를 대체하는 고정된 유형이 아니라, 밸런싱을 위해 시험해 볼 가상의 행동 모델입니다.
| 번호 | 페르소나 | 주요 행동 특성 | 클리어 타임에 영향을 주는 신호 |
|---|---|---|---|
| 1 | 스토리 중심 초보자 | 대사와 튜토리얼을 읽고 전투를 신중하게 수행 | 대사 체류 시간, 피격 횟수, 이동 중 정지 |
| 2 | 시스템 학습자 | 장비와 스킬 설명을 확인한 뒤 효율적인 조합을 시도 | 메뉴 체류 시간, 스킬 변경 횟수, 실험 횟수 |
| 3 | 액션 숙련자 | 회피와 콤보를 적극 활용하고 전투를 빠르게 종료 | 전투당 소요 시간, 명중률, 피격률 |
| 4 | 탐험 수집가 | 숨겨진 길과 상자를 확인하며 목표 외 콘텐츠도 수행 | 선택 경로 수, 탐색 거리, 수집 오브젝트 상호작용 |
| 5 | 스피드러너 | 컷신을 건너뛰고 최단 경로와 고효율 기술을 사용 | 이동 거리, 컷신 스킵률, 전투 생략률 |
| 6 | 반복 도전자 | 실패해도 즉시 재시도하고 패턴을 빠르게 학습 | 재시도 간격, 사망 횟수, 재도전 성공률 |
| 7 | 안전 플레이어 | 회복과 방어를 우선하며 위험한 구간에서 진행을 멈춤 | 회복 사용률, 전투 거리, 정지 시간 |
| 8 | 길찾기 취약 플레이어 | 목표 위치를 자주 확인하고 우회 경로를 선택 | 지도 열람 횟수, 방향 전환 수, 목표 이탈 시간 |
| 9 | 경제 최적화 플레이어 | 상점과 보상을 비교해 준비 시간이 길어짐 | 상점 체류 시간, 구매 비교 횟수, 장비 교체 |
| 10 | 단속적 플레이어 | 짧은 세션으로 플레이하고 중단 후 재접속 | 세션 길이, 중단 횟수, 재접속 후 재개 위치 |
아래 10종과 신호는 분류 설계 예시이며 실제 유저 집단에서 이 유형이 존재하거나 각 신호가 클리어 타임에 영향을 준다는 검증 결과는 아닙니다.
이 목록은 고정된 정답이 아닙니다. 프로젝트의 장르와 핵심 루프에 맞춰 페르소나를 재정의해야 합니다. 액션 RPG라면 전투 숙련도와 회피 성공률의 비중을 높이고 퍼즐 게임이라면 힌트 사용률과 상태 되돌리기 횟수를 핵심 변수로 삼을 수 있습니다.
예측 시스템에는 어떤 데이터를 넣어야 할까?
예측 모델의 입력은 미션 설계 데이터와 실제 플레이 텔레메트리로 나눕니다.
미션 설계 데이터는 출시 전에도 확보할 수 있습니다.
| 그룹 | 예시 피처 | 데이터 형식 |
|---|---|---|
| 구조 | 목표 수, 필수 단계 수, 선택 목표 수 | 정수 |
| 이동 | 예상 이동 거리, 수직 이동량, 분기 수 | 실수 |
| 전투 | 적 그룹 수, 적 레벨 차이, 보스 여부 | 정수 또는 불리언 |
| 상호작용 | 대화 노드 수, 조사 오브젝트 수, 퍼즐 단계 수 | 정수 |
| 보상 | 보상 선택 화면 수, 상점 방문 필요 여부 | 정수 또는 불리언 |
| UX | 지도 제공 여부, 목표 마커 제공 여부, 체크포인트 수 | 불리언 또는 정수 |
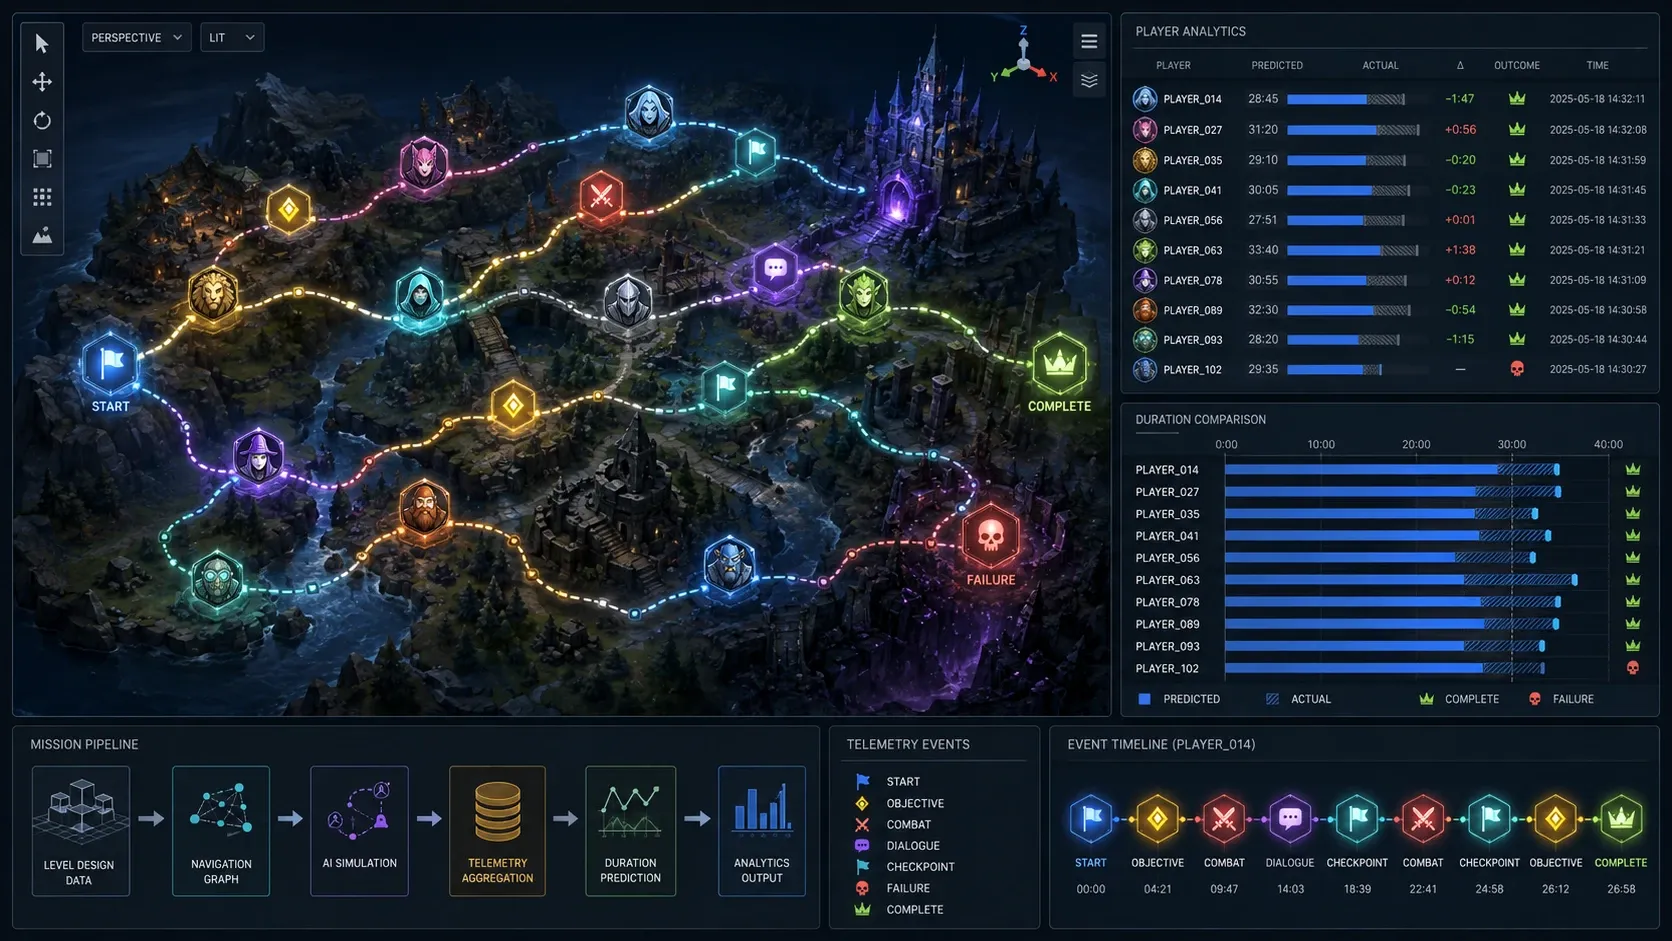
실제 플레이 데이터에서는 다음 이벤트를 기록합니다.
mission_start,mission_complete,mission_failloading_start,loading_end,pause_start,pause_end(로딩·일시정지 시간을 제외할 때)objective_enter,objective_completecombat_start,combat_enddialogue_start,dialogue_skipmap_open,checkpoint_loaditem_interact,shop_open
필요한 이벤트에는 mission_id, session_id, player_id_hash, timestamp, position, objective_id 등을 목적에 맞춰 기록합니다. 해시된 키도 다른 정보와 결합해 개인을 알아볼 수 있다면 개인정보에 해당할 수 있으므로 익명정보라고 단정하지 않습니다. 학습 데이터를 준비할 때는 직접 식별자를 최소화하고, 목적과 보유 기간을 정한 뒤 필요한 위험성 검토·가명처리·안전조치를 적용해야 합니다.
신규 미션 클리어 타임 예측은 어떻게 구현할까?
1단계: 기존 미션에서 정답 데이터를 만든다
완료 이벤트의 타임스탬프에서 시작 이벤트의 타임스탬프를 빼서 실제 클리어 타임을 계산합니다. 중단 세션을 포함할지 여부는 별도 정책으로 정해야 합니다.
예를 들어 게임 플레이 시간만 측정하려면 일시정지나 로딩 구간의 시작·종료 이벤트를 기록해 해당 시간을 제외합니다. 현재 예시 이벤트 목록에 이 구간 이벤트가 포함되어야 합니다. 반대로 실제 사용자가 느끼는 전체 소요 시간을 알고 싶다면 재접속까지의 시간을 포함할 수 있습니다.
모델의 정답값은 다음처럼 정의할 수 있습니다.
완료하지 못한 플레이어도 버리지 않는 것이 중요합니다. 중도 이탈 데이터는 생존 분석이나 검열 데이터 처리에 사용할 수 있지만 초기 구현에서는 미완료, 실패 후 재시도, 정상 완료를 별도 상태로 분리하는 편이 관리하기 쉽습니다.
2단계: 플레이어를 10종 페르소나에 매핑한다
최근 10~20개 미션의 행동 지표를 집계한 뒤 규칙 기반 분류 또는 클러스터링으로 페르소나를 부여할 수 있습니다. 아래 기간과 임계값은 작동 예시일 뿐, 적합성은 데이터와 검증 결과로 정해야 합니다.
예를 들어 다음 기준을 사용할 수 있습니다.
- 스킵률이 80% 이상이고 평균 이동 효율이 상위 10%면 스피드러너
- 선택 오브젝트 상호작용 비율이 60% 이상이면 탐험 수집가
- 미션 실패 후 3분 이내 재시작 비율이 높으면 반복 도전자
- 지도 열람 횟수가 평균의 2배 이상이면 길찾기 취약 플레이어
한 플레이어가 하나의 페르소나에만 속하지 않아도 됩니다. 실제로는 페르소나별 소속 확률을 저장하는 소프트 매핑이 더 자연스럽습니다.
예시는 다음과 같습니다.
| 페르소나 | 소속 확률 |
|---|---|
| 스토리 중심 초보자 | 0.20 |
| 탐험 수집가 | 0.35 |
| 안전 플레이어 | 0.25 |
| 길찾기 취약 플레이어 | 0.20 |
3단계: 페르소나별 예측 모델을 학습한다
가장 단순한 구조는 페르소나마다 하나의 회귀 모델을 학습하는 것입니다. 입력은 미션 피처와 플레이어의 최근 행동 피처이고 출력은 초 단위의 클리어 타임입니다.
모델 선택은 데이터 양과 해석 가능성에 맞춰야 합니다.
| 모델 | 장점 | 적합한 상황 |
|---|---|---|
| 선형 회귀 | 계수를 확인할 수 있는 단순한 기준 모델 | 초기 기준선과 피처 영향 분석 |
| Random Forest Regressor | 여러 결정 트리의 예측을 결합하는 앙상블 | 검증 데이터에서 기준 모델과 비교 |
| Gradient Boosting Regressor | 단계적으로 오차를 줄이는 트리 앙상블 | 검증 데이터에서 기준 모델과 비교 |
| Quantile Regression | 지정한 조건부 분위수를 직접 추정 | 분위수별 모델을 학습해 꼬리 위험도 확인 |
예측값은 페르소나별 모델의 가중 평균으로 합칩니다.
여기서 는 미션과 플레이어 행동 피처이고 는 i번째 페르소나입니다. 는 목표 플레이어 구성이나 최근 실제 유저 분포에 따라 정합니다. 이 식은 페르소나별 점예측의 가중 평균을 나타내며, 분위수 회귀 결과를 합치는 식은 아닙니다. 분위수 회귀를 쓸 때는 목표 분위수별 모델을 따로 학습하고 검증합니다.
실제 프로젝트에서는 평균값만 제공하지 말고 분위수도 함께 저장합니다. 아래 식에서 는 예측 클리어 타임 의 누적분포함수입니다.
Risk_long가 높으면 해당 미션이 특정 플레이어층에게 지나치게 길게 느껴질 가능성이 있다는 뜻입니다.
4단계: 자동 예측 결과를 밸런스 리뷰에 연결한다
다음 Python 3.12 예시는 페르소나별 회귀 모델 결과를 결합해 중앙값과 분위수 요약을 계산하는 최소 구현입니다. 이 코드만으로 실제 시간 분포나 보정된 상한을 학습하지는 않습니다. 모델 학습은 오프라인 파이프라인에서 수행하고 게임 클라이언트에는 예측 결과만 전달하는 구성을 고려할 수 있습니다.
from dataclasses import dataclass
import numpy as np

@dataclass(frozen=True)
class Persona:
    id: str
    weight: float

def predict_clear_time(models, feature_row, personas):
    if not personas:
        raise ValueError('personas must not be empty')

    weights = np.asarray([persona.weight for persona in personas], dtype=float)
    if not np.all(np.isfinite(weights)) or np.any(weights < 0) or weights.sum() <= 0:
        raise ValueError('persona weights must be finite, non-negative, and have a positive sum')
    weights /= weights.sum()

    predictions = []

    for persona in personas:
        model = models[persona.id]
        raw_prediction = float(model.predict([feature_row])[0])
        if not np.isfinite(raw_prediction):
            raise ValueError(f'model returned a non-finite prediction for persona {persona.id}')
        prediction = max(0.0, raw_prediction)
        predictions.append(prediction)

    def weighted_percentile(percentile):
        order = np.argsort(predictions)
        sorted_predictions = np.asarray(predictions)[order]
        cumulative_weights = np.cumsum(weights[order])
        index = min(np.searchsorted(cumulative_weights, percentile / 100, side='left'), len(predictions) - 1)
        return float(sorted_predictions[index])

    return {
        'p50_seconds': round(weighted_percentile(50), 1),
        'p80_seconds': round(weighted_percentile(80), 1),
        'p95_seconds': round(weighted_percentile(95), 1),
        'spread_seconds': round(weighted_percentile(95) - weighted_percentile(50), 1),
    }
이 예제의 분위수는 페르소나별 단일 예측값에 소속 가중치를 적용한 혼합 분포 요약입니다. 실제 플레이어 전체의 보정된 P50·P80·P95를 예측하려면 페르소나 내부의 시간 분산을 모델링하거나 분위수 회귀를 적용하고, 별도 검증 데이터에서 분위수 포함률을 확인해야 합니다.
예측 결과는 기획 도구에서 다음처럼 해석할 수 있습니다.
| 결과 | 해석 | 권장 조치 |
|---|---|---|
| 검증된 P50과 P80이 목표 범위 | 검증 표본의 중앙값과 80분위가 목표 범위 | 출시 후보로 검토 |
| P50은 짧고 P80만 김 | 행동 유형별 결과를 분해해 지연 원인을 확인 | 목표 마커, 체크포인트, 선택 목표 검토 |
| P50부터 김 | 핵심 루프 자체가 오래 걸림 | 전투 수, 이동 거리, 목표 단계 축소 |
| P50과 P95 차이가 큼 | 플레이어 경험 편차가 큼 | 분기 구간과 실패 비용 분석 |
| 모든 페르소나가 짧음 | 미션의 체감 콘텐츠가 부족할 수 있음 | 선택 목표나 전투 변주 추가 |
예측 모델의 정확도는 어떻게 검증할까?
출시 전 예측은 실제 정답을 아직 알 수 없으므로 과거 미션을 신규 미션처럼 숨겨서 검증할 수 있습니다. 시간 순서를 지키는 분할은 미래 기록으로 학습한 뒤 과거를 검증하는 누수를 피하는 데 도움이 됩니다. 다만 같은 미션의 여러 세션이 학습·검증 양쪽에 나뉘지 않도록 미션 단위 분리도 확인해야 합니다.
검증 절차는 다음과 같습니다.
- 과거 미션의 앞부분을 학습 데이터로 분리한다.
- 이후에 출시된 미션을 검증 데이터로 사용한다.
- 페르소나별 예측값과 실제 클리어 타임을 비교한다.
- 예측 오차가 큰 미션의 이벤트 로그를 역추적한다.
- 새로 확인된 행동 변수를 피처와 분류 규칙에 반영한다.
주요 지표는 평균 절대 오차와 중앙 절대 오차입니다. 실제 시간이 0에 가까운 짧은 미션에서는 작은 절대 오차도 MAPE를 크게 만들 수 있으므로 단일 지표로 판단하지 않는 편이 좋습니다.
P80 예측을 사용한다면 실제 클리어 타임의 약 80%가 해당 분위수 이하인지 확인해야 합니다. 이 비율이 목표인 80%보다 낮거나 높으면 해당 검증 표본에서 P80 예측이 각각 과소 또는 과대 포함되었음을 뜻합니다. 원인과 허용 오차를 정하고 추가 표본에서도 보정 상태를 확인해야 합니다.
자동 예측이 실패하는 주요 원인은 무엇인가?
미션 피처의 정의가 플레이 경험과 맞지 않는 경우
적 그룹 수가 같아도 적 배치, 지형, 카메라 시야, 체크포인트 위치에 따라 체감 시간이 달라집니다. 단순한 개수뿐 아니라 전투 진입부터 종료까지의 평균 거리와 실패 시 복구 시간을 함께 기록해야 합니다.
페르소나를 고정된 성격으로 취급하는 경우
플레이어는 미션 목적에 따라 행동을 바꿉니다. 스토리 미션에서는 탐험가가 되지만 보상 반복 콘텐츠에서는 스피드러너처럼 행동할 수 있습니다. 따라서 매핑 결과에 만료 시간이나 최근 행동 가중치를 적용해야 합니다.
평균값 하나로 밸런스를 판단하는 경우
평균이 목표 시간에 들어와도 길찾기 취약 플레이어와 안전 플레이어의 P95가 지나치게 높을 수 있습니다. 리뷰 화면에는 최소한 P50, P80, P95와 페르소나별 기여도를 함께 표시해야 합니다.
모델 예측을 설계 판단보다 우선하는 경우
모델은 과거에 존재한 패턴을 재현할 뿐입니다. 새로운 기믹이나 처음 도입하는 조작 체계처럼 학습 데이터에 없는 요소는 예측 신뢰도가 낮습니다. 이런 미션에는 모델 결과와 함께 신뢰도 경고를 표시하고 소규모 플레이 테스트를 병행해야 합니다.
자주 묻는 질문 FAQ
AI 페르소나는 실제 플레이어를 완전히 대체할 수 있나요?
대체할 수 없습니다. AI 페르소나는 반복적인 예상과 위험 구간 탐지에 유용하지만 새로운 규칙의 재미, 감정적 긴장감, 혼란의 의도성은 실제 플레이 테스트로 확인해야 합니다.
페르소나 10종을 반드시 사용해야 하나요?
아닙니다. 10종은 다양한 행동 편차를 살피기 위한 예시일 뿐 보편적인 기준은 아닙니다. 데이터가 적다면 예를 들어 3~5종으로 시작한 뒤, 검증 결과에서 반복적으로 오차가 큰 행동군이 확인될 때 세분화를 시험할 수 있습니다.
출시 전 데이터가 없으면 어떻게 예측하나요?
미션 설계 데이터와 디자이너가 정의한 행동 규칙으로 초기 휴리스틱 모델을 만들 수 있습니다. 출시 후 텔레메트리가 쌓이면 실제 클리어 타임으로 회귀 모델을 재학습해 휴리스틱을 대체합니다.
정리
신규 미션 클리어 타임 예측의 핵심은 플레이어 행동을 측정 가능한 유형으로 구조화하고 실제 데이터에서 모델을 검증하는 데 있습니다. 미션 피처 → 행동 유형별 예측 → 분위수 집계 → 밸런스 검토의 흐름은 긴 미션이나 경험 편차를 일관된 기준으로 살펴보는 데 활용할 수 있습니다.
초기에는 해석 가능한 규칙과 기준 모델을 만들고 실제 텔레메트리가 축적된 뒤 검증 결과에 따라 분위수 회귀나 페르소나별 앙상블을 시험할 수 있습니다.