Unity Whisper API 기반 STT 음성 인식으로 인게임 스킬 발동 구현하기
Unity에서 마이크 입력을 WAV로 캡처하고 Whisper STT API로 전사한 뒤 정규화·명령 매칭·쿨다운 검증을 거쳐 안전하게 스킬을 발동하는 클라이언트 구현 방법을 정리합니다.
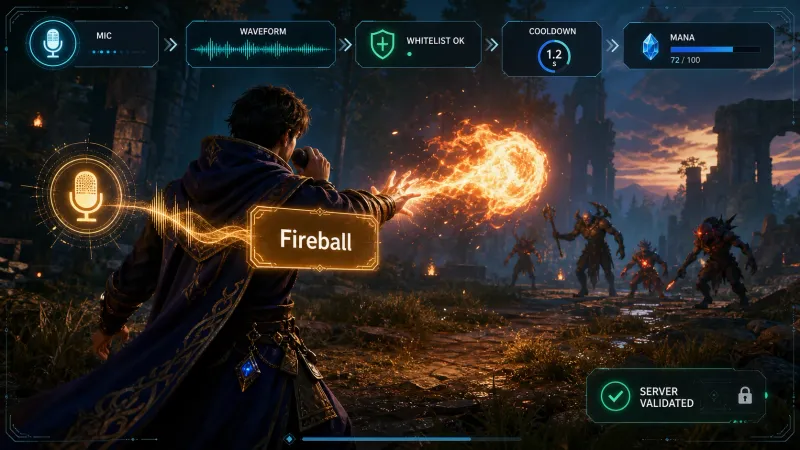
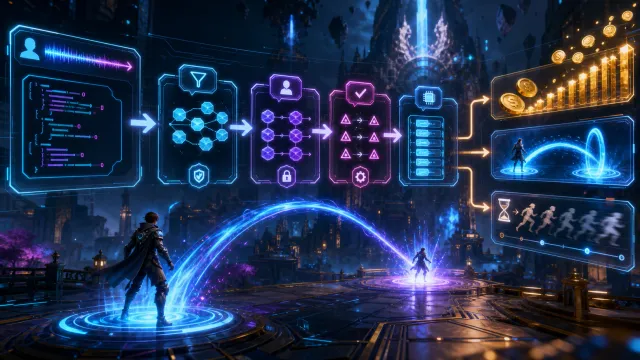
게임 내 음성 스킬 발동은 마이크 녹음 → STT 전사 → 텍스트 정규화 → 허용 명령 매칭 → 게임플레이 검증 순서로 구현한다. Whisper API의 전사 결과를 곧바로 스킬 ID로 사용하지 말고 클라이언트는 입력 UX를 담당하며 실제 스킬 발동은 쿨다운·자원·상태를 검증하는 기존 게임플레이 로직으로만 연결해야 한다.
Unity 음성 인식 스킬 발동 구조
Whisper API의 /v1/audio/transcriptions 엔드포인트는 음성 파일을 텍스트로 전사한다. Unity 클라이언트가 마이크를 짧게 녹음해 백엔드에 전달하고 백엔드가 API 키를 보관한 채 OpenAI API를 호출하는 구성이 안전하다. API 키를 Unity 빌드에 넣으면 추출될 수 있으므로 직접 호출은 피한다.
flowchart LR
    A[Push-to-Talk 입력] --> B[Unity Microphone 녹음]
    B --> C[WAV 인코딩]
    C --> D[게임 백엔드]
    D --> E[Whisper 전사 API]
    E --> F[전사 텍스트]
    F --> G[정규화·명령 매칭]
    G --> H[스킬 사용 가능 여부 검증]
H --> I[스킬 발동]| 단계 | 책임 | 핵심 처리 |
|---|---|---|
| 녹음 | Unity 클라이언트 | Push-to-Talk, 최대 녹음 시간, 마이크 권한 |
| 전사 | 게임 백엔드 | multipart/form-data, file, model, language 전달 |
| 명령 해석 | 클라이언트 또는 서버 | 공백·대소문자 정규화, 허용 문구 비교 |
| 발동 | 게임플레이 시스템 | 쿨다운, 마나, 침묵, 사망, 네트워크 권한 검증 |
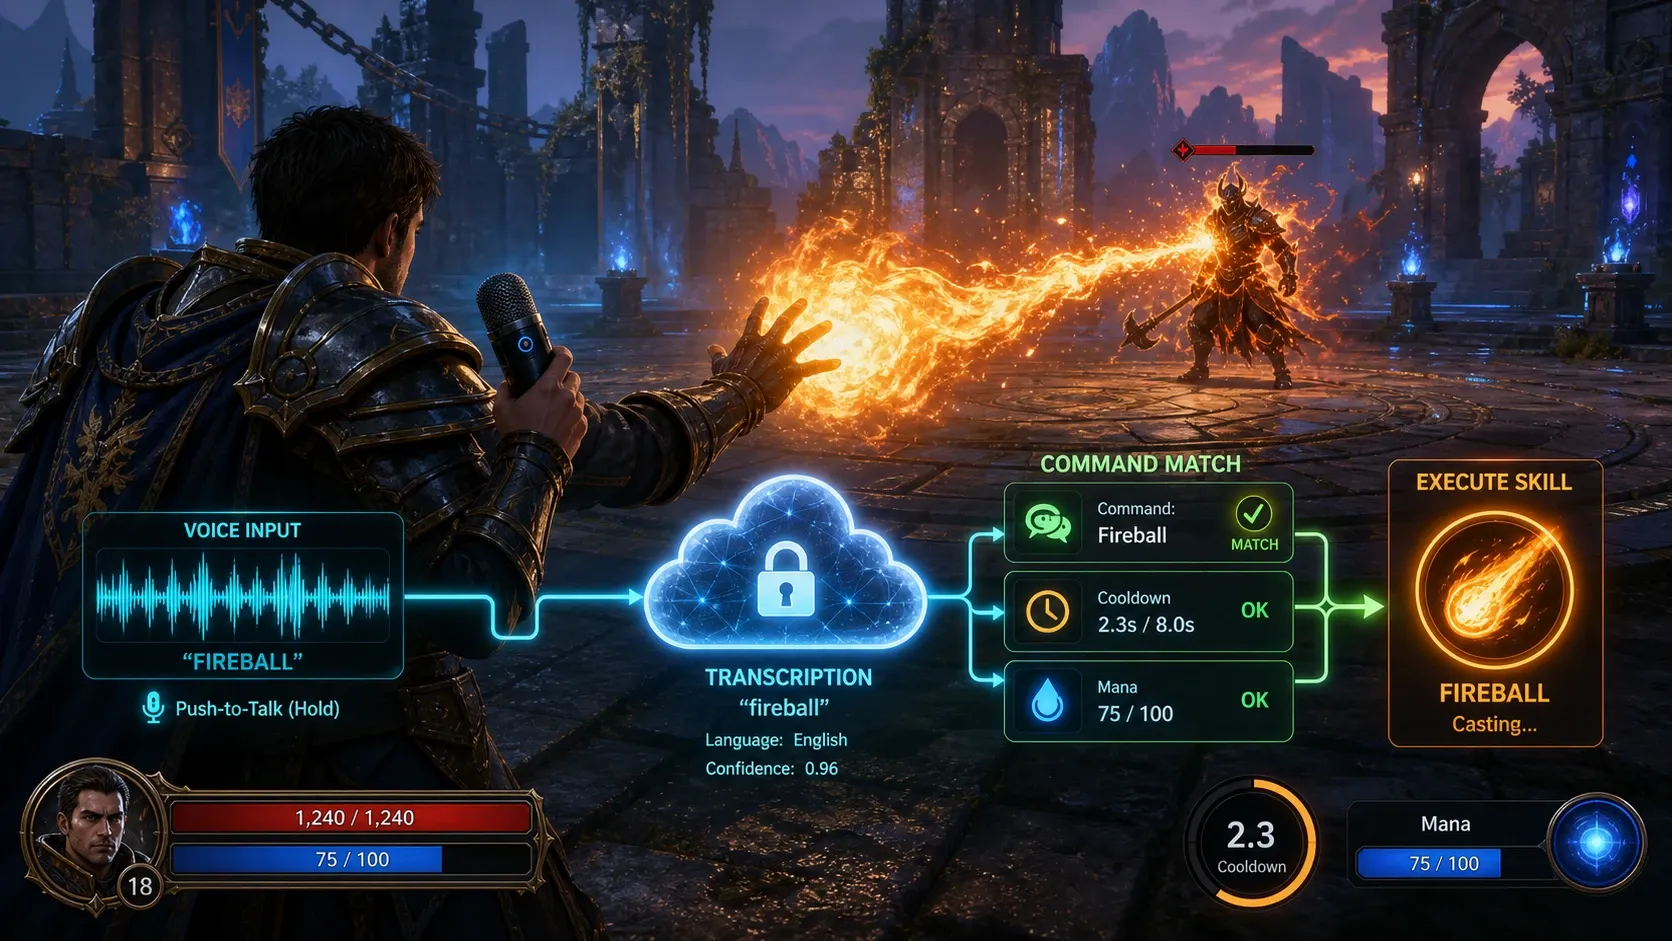
Whisper STT API를 인게임 명령에 어떻게 연결할까?
1. 음성 입력은 Push-to-Talk으로 제한한다
항상 녹음하는 방식은 비용, 개인정보, 오인식 문제를 키운다. 먼저 버튼을 누르는 동안만 녹음하고 1~3초 같은 상한을 둔다. 짧고 명확한 명령은 전사 지연과 업로드 크기도 줄인다.
using UnityEngine;

public sealed class VoiceRecorder : MonoBehaviour
{
    [SerializeField] int maxSeconds = 3;
    [SerializeField] int sampleRate = 16000;

    AudioClip clip;
    string device;

    public void Begin()
    {
        if (Microphone.devices.Length == 0) return;
        device = Microphone.devices[0];
        clip = Microphone.Start(device, false, maxSeconds, sampleRate);
    }

    public AudioClip End()
    {
        if (clip == null || !Microphone.IsRecording(device)) return null;
        var position = Microphone.GetPosition(device);
        Microphone.End(device);
        return position > 0 ? clip : null;
    }
}
녹음 종료 시에는 AudioClip 전체 길이가 아니라 실제 Microphone.GetPosition()까지 잘라 WAV로 인코딩한다. 무음으로 채워진 끝부분까지 전송하면 전사 시간이 늘고 명령 인식률도 떨어질 수 있다.
2. Unity는 게임 백엔드에 WAV 파일만 전송한다
백엔드는 받은 WAV를 OpenAI audio/transcriptions에 file로 첨부하고 model=whisper-1, language=ko를 전달한다. language에 ISO-639-1 코드 ko를 지정하면 한국어 명령에 불필요한 언어 감지를 줄일 수 있다. 지원 파일 형식에는 WAV, MP3, M4A, WebM 등이 포함된다.
using System.Collections;
using UnityEngine;
using UnityEngine.Networking;

public sealed class VoiceSkillApi : MonoBehaviour
{
    [SerializeField] string endpoint = "https://game.example.com/api/voice/transcribe";

    public IEnumerator Transcribe(byte[] wav, System.Action<string> onDone)
    {
        var form = new WWWForm();
        form.AddBinaryData("audio", wav, "command.wav", "audio/wav");

        using var request = UnityWebRequest.Post(endpoint, form);
        yield return request.SendWebRequest();

        if (request.result != UnityWebRequest.Result.Success)
        {
            onDone?.Invoke(string.Empty);
            yield break;
        }

        onDone?.Invoke(JsonUtility.FromJson<Transcription>(request.downloadHandler.text).text);
    }

    [System.Serializable]
    sealed class Transcription { public string text; }
}
서버 응답은 클라이언트가 필요한 최소 형태인 {"text":"화염구"}로 통일하면 된다. 서버는 요청 크기, 사용자 인증, 요청 빈도, 허용 오디오 길이를 제한해야 한다.
3. 전사 문장 대신 화이트리스트 명령을 매칭한다
STT 결과에는 공백, 문장 부호, 조사 같은 변형이 섞인다. 이를 정규화한 뒤 미리 정의한 명령만 매칭한다. LLM으로 자유 텍스트를 해석해 스킬을 실행하는 방식은 명령 범위가 넓어지고 검증도 어려워지므로 전투 중 단일 스킬 명령에는 정확 일치 기반이 단순하고 안전하다.
using System;
using System.Collections.Generic;
using System.Text.RegularExpressions;

public sealed class VoiceSkillMatcher
{
    static readonly Dictionary<string, string> Commands = new()
    {
        ["화염구"] = "Fireball",
        ["파이어볼"] = "Fireball",
        ["치유"] = "Heal",
        ["힐"] = "Heal",
        ["방패"] = "Barrier"
    };

    public bool TryGetSkill(string transcript, out string skillId)
    {
        var command = Regex.Replace(transcript ?? "", @"[\s\p{P}\p{S}]", "").ToLowerInvariant();
        return Commands.TryGetValue(command, out skillId);
    }
}
명령 표는 ScriptableObject로 옮기면 기획자가 별칭을 관리하기 좋다. 다만 명령 수가 적은 초기 버전이라면 위처럼 한 곳의 딕셔너리로 시작해도 충분하다.
음성 전사 결과만으로 스킬을 발동하면 왜 위험한가?
음성 인식은 입력 장치일 뿐, 게임 규칙을 우회하는 권한이 아니다. 전사된 Fireball이 나와도 다음 검증을 모두 통과할 때만 TryCast를 호출해야 한다.
| 검증 항목 | 예시 |
|---|---|
| 플레이어 상태 | 사망, 기절, 침묵, 컷신 중인지 확인 |
| 자원 | 마나, 탄약, 체력 소모 조건 확인 |
| 시간 | 글로벌 쿨다운과 스킬별 쿨다운 확인 |
| 타깃 | 사거리, 시야, 적대 관계 확인 |
| 권한 | 멀티플레이에서는 서버 권한으로 최종 판정 |
public void OnVoiceTranscribed(string text)
{
    if (!matcher.TryGetSkill(text, out var skillId))
    {
        skillUi.ShowVoiceFeedback("인식하지 못한 명령입니다");
        return;
    }

    if (!skillCaster.TryCast(skillId))
        skillUi.ShowVoiceFeedback("지금은 해당 스킬을 사용할 수 없습니다");
}
멀티플레이 게임에서는 TryCast 요청을 서버로 보내고 서버가 위 조건을 다시 검증해야 한다. 클라이언트의 STT 결과나 명령 매칭 결과는 신뢰할 수 있는 입력이 아니다.
STT 음성 스킬의 지연 시간과 오인식은 어떻게 줄일까?
총 반응 시간은 녹음 시간, 업로드, 전사 처리, 응답 다운로드, 게임 실행 시간의 합이다.
실시간 액션 게임에서 긴 녹음 완료 후 API 응답을 기다리면 조작감이 떨어질 수 있다. 따라서 음성 스킬은 전술 명령, 협동 플레이, 접근성 기능처럼 약간의 지연을 허용할 수 있는 상황에 우선 적용하는 편이 좋다.
| 문제 | 최소 대응 |
|---|---|
| 말끝이 잘림 | 버튼을 뗀 뒤 150~300ms의 짧은 후행 구간을 추가 |
| 배경 소음 | Push-to-Talk, 입력 장치 선택, 음성 감지 임계값 적용 |
| 유사 발음 | 스킬별 별칭을 추가하고 정확 일치 우선 적용 |
| 연속 요청 | 전사 요청이 진행 중이면 다음 입력을 막거나 취소 |
| 네트워크 지연 | 녹음 중 UI, 전사 중 UI, 실패 피드백을 구분 |
whisper-1은 스트리밍 전사를 지원하지 않으므로 이 구조는 발화가 끝난 뒤 결과를 받는 방식이다. 즉각적인 음성 상호작용이 핵심이라면 스트리밍을 지원하는 전사 모델 또는 Realtime 기반 설계를 별도로 검토해야 한다.
자주 묻는 질문 (FAQ)
Unity 클라이언트에서 Whisper API를 직접 호출해도 되나?
권장하지 않는다. 배포된 앱에서 API 키가 노출될 수 있으므로 Unity는 인증된 게임 백엔드에 오디오를 보내고 백엔드가 OpenAI API를 호출해야 한다.
한국어 스킬 이름의 인식률은 어떻게 높이나?
language=ko를 지정하고 스킬 이름을 짧고 서로 발음이 다른 단어로 설계한다. 화염구, 치유, 방패처럼 별칭을 화이트리스트에 추가하는 방식이 가장 예측 가능하다.
음성 명령을 PvP 핵심 조작으로 써도 되나?
네트워크 왕복과 전사 지연이 있어 반응 속도가 중요한 조작에는 불리하다. 보조 입력으로 제공하고 키보드·패드 입력과 동등한 대체 수단을 유지하는 편이 안전하다.
정리
Unity 음성 스킬은 STT 정확도보다 입력 파이프라인의 경계 설계가 중요하다. 짧은 Push-to-Talk 녹음, 백엔드 프록시, 화이트리스트 명령 매칭, 기존 TryCast 검증을 연결하면 Whisper 기반 기능을 게임 규칙을 해치지 않는 보조 입력으로 추가할 수 있다.
처음에는 3~5개 명령과 정확 일치 매칭으로 시작하고 실제 전사 로그에서 반복되는 오인식이 확인될 때만 별칭이나 음성 감지 로직을 추가하자.