튜토리얼 힌트 재노출 간격을 숙련도에 따라 줄이는 Hint Decay 시스템 설계
튜토리얼 힌트를 무작정 반복하지 않고 플레이어의 숙련도, 실패 누적, 무시 행동을 측정해 재노출 간격을 동적으로 줄이고 늘리는 Hint Decay 시스템 설계법을 수식, 상태 모델, Unity 6 C# 예제로 정리합니다.
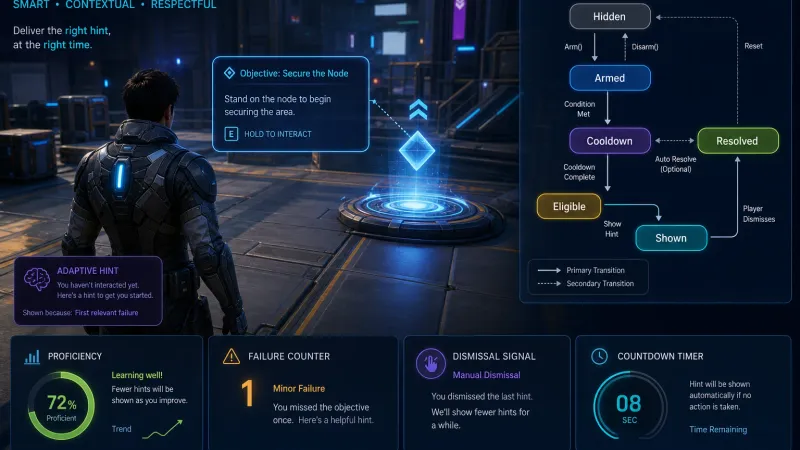
핵심 요약
Hint Decay 시스템은 플레이어의 성공률, 실패 누적, 힌트 없이 해결한 비율을 바탕으로 숙련도 P를 추정하고 튜토리얼 힌트의 재노출 간격 T를 동적으로 조정하는 방식이다. 숙련도가 낮거나 실패 압력이 높으면 간격을 짧게 만들고 숙련도가 높거나 힌트를 반복해서 닫으면 간격을 길게 만들어 도움과 방해 사이의 균형을 맞춘다.
아래 예시는 Unity 6와 C# 9 이상을 기준으로 하며 HintDecayController, ProficiencySnapshot, 이벤트 기반 텔레메트리를 사용한다.
Hint Decay 시스템이란?
튜토리얼 힌트는 한 번 보여주는 것으로 끝나지 않는다. 플레이어가 힌트를 무시하거나 필요한 순간에 놓치면 같은 목표에서 다시 보여줘야 한다. 그러나 모든 플레이어에게 같은 주기로 힌트를 재노출하면 문제가 생긴다.
초보자는 너무 오래 기다리기 전에 도움을 받아야 하고 고숙련자는 같은 힌트를 반복해서 보지 않아야 한다. Hint Decay는 이 차이를 재노출 간격으로 표현하는 시스템이다.
이 글에서는 숙련도에 따라 줄인다는 표현을 다음과 같이 정의한다.
- 숙련도가 낮고 최근 실패가 누적될수록 재노출 간격을 줄인다.
- 숙련도가 높고 힌트를 자주 닫을수록 재노출 간격을 늘린다.
- 간격만 바꾸지 않고 힌트의 단계와 강도도 함께 조절한다.
튜토리얼 힌트 재노출 간격은 왜 플레이어마다 달라야 하는가?
플레이어가 힌트를 다시 필요로 하는 시점은 동일하지 않다. 같은 30초 동안 어떤 플레이어는 목표를 파악하고 해결하지만 다른 플레이어는 같은 행동을 여러 번 반복할 수 있다.
고정 간격 방식은 구현이 단순하지만 다음과 같은 부작용을 만든다.
| 문제 | 원인 | 플레이어 경험 |
|---|---|---|
| 초보자가 막힌 채 오래 기다림 | 모든 플레이어에게 긴 쿨다운 적용 | 목표를 포기하거나 공략을 검색함 |
| 숙련자가 힌트에 방해받음 | 해결 가능한 상태에서도 동일한 힌트 노출 | 튜토리얼이 잔소리처럼 느껴짐 |
| 반복 실패가 반영되지 않음 | 실패와 성공을 별도로 기록하지 않음 | 도움의 타이밍이 늦음 |
| 힌트 닫기가 무시됨 | hint_dismissed 이벤트를 사용하지 않음 | 플레이어의 명시적 거부를 존중하지 못함 |
따라서 핵심은 힌트를 얼마나 자주 보여줄지가 아니라 지금 이 플레이어에게 힌트가 필요한지를 추정하는 것이다.
숙련도 점수는 어떻게 계산할까?
숙련도는 영구적인 플레이어 등급이 아니라 현재 목표와 최근 행동에 대한 추정값으로 다루는 편이 안전하다. 새로운 시스템을 만났거나 조작법이 바뀌면 숙련도는 다시 낮아질 수 있기 때문이다.
다음 지표를 모두 0에서 1 사이로 정규화한다.
| 기호 | 지표 | 의미 |
|---|---|---|
S | 성공률 | 최근 시도 중 목표를 성공한 비율 |
H | 힌트 없이 해결한 비율 | 힌트 노출 없이 목표를 해결한 비율 |
A | 적은 시도 해결률 | 목표를 기준 시도 횟수 이하로 해결한 비율 |
R | 회상 성공률 | 힌트를 본 뒤 같은 행동을 재현한 비율 |
F | 실패 압력 | 반복 실패, 잘못된 입력, 재시도 누적을 합산한 값 |
가중치는 목표의 성격에 맞게 조정한다. 예를 들어 전투 튜토리얼은 성공률과 실패 압력의 비중을 높이고 퍼즐 튜토리얼은 힌트 없이 해결한 비율과 회상 성공률의 비중을 높일 수 있다.
P가 0에 가까우면 지원 필요도가 높고 P가 1에 가까우면 독립적으로 목표를 수행할 가능성이 높다. 초기 세션에서는 충분한 데이터가 없으므로 P = 0.5 같은 중립값에서 시작하고 최근 이벤트에 더 큰 가중치를 주는 것이 좋다.
숙련도 추정값은 어떻게 안정화할까?
한 번의 실수로 힌트 주기가 급격히 짧아지면 시스템이 불안정해진다. 이벤트마다 새 점수를 즉시 대입하지 말고 지수 이동 평균으로 완화한다.
lambda는 0.15에서 0.30 사이로 시작할 수 있다. 값이 클수록 최근 행동에 민감하게 반응하고 값이 작을수록 장기적인 숙련도를 반영한다.
재노출 간격은 어떤 수식으로 줄이고 늘릴까?
지원 필요도는 Need = 1 - P로 정의한다. 숙련도가 낮을수록 Need가 커지고 재노출 간격이 짧아진다.
| 파라미터 | 의미 | 권장 시작값 |
|---|---|---|
T_base | 중립 숙련도의 기본 재노출 간격 | 60초 |
T_min | 최단 재노출 간격 | 10초 |
T_max | 최장 재노출 간격 | 90초 |
alpha | 숙련도에 따른 감소 폭 | 0.80 |
gamma | 낮은 숙련도 구간의 민감도 | 1.30 |
D | 힌트 즉시 닫기 비율 | 0~1 |
beta | 명시적 거부에 대한 간격 증가 폭 | 0.50 |
예를 들어 T_base = 60, alpha = 0.8, gamma = 1.3, T_min = 10이면 숙련도가 매우 낮은 플레이어의 간격은 약 12초까지 줄어든다. 숙련도가 높으면 기본 간격인 60초에 가까워지고 힌트를 반복해서 닫으면 T_max 방향으로 늘어난다.
D는 숙련도 점수에 직접 넣지 않는 편이 좋다. 힌트를 닫는 행동은 숙련도의 증거일 수도 있지만 단순히 현재 UI가 불편하다는 신호일 수도 있기 때문이다. 간격 보정값으로만 사용하면 플레이어의 거부 의사를 반영하면서 숙련도 추정이 과도하게 흔들리는 것을 막을 수 있다.
Hint Decay 상태 모델은 어떻게 구성할까?
힌트는 단순한 타이머가 아니라 목표 상태와 입력 상황을 함께 확인해야 한다. 컷신, 전투, 대화 선택, 입력 잠금 상태에서 힌트를 노출하면 내용이 맞더라도 UX가 나빠진다.
flowchart TD
  A[목표 시작] --> B[플레이 이벤트 수집]
  B --> C[숙련도 P 계산]
  C --> D[재노출 간격 T 계산]
  D --> E{간격 경과 및 노출 조건 충족}
  E -- 아니오 --> F[대기]
  F --> B
  E -- 예 --> G[단계별 힌트 노출]
  G --> B
권장 상태는 다음과 같다.
| 상태 | 진입 조건 | 처리 |
|---|---|---|
Hidden | 목표가 시작되지 않음 | 힌트 타이머를 정지함 |
Armed | 목표가 시작됨 | 숙련도와 기본 간격을 계산함 |
Cooldown | 힌트를 방금 노출함 | T만큼 대기함 |
Eligible | 간격과 컨텍스트 조건 충족 | 노출 여부를 최종 판정함 |
Shown | 힌트를 표시함 | 노출 횟수와 단계를 기록함 |
Resolved | 목표를 완료함 | 타이머와 관련 이벤트를 종료함 |
Unity 6 C#으로 Hint Decay를 어떻게 구현할까?
먼저 숙련도 계산에 사용할 현재 상태를 정의한다. 실제 프로젝트에서는 이 값을 저장 파일이나 세션 분석 시스템과 연결할 수 있다.
public sealed class ProficiencySnapshot
{
    public float SuccessRate;
    public float HintFreeSolveRate;
    public float LowAttemptSolveRate;
    public float RecallRate;
    public float FailurePressure;
    public float DismissalRate;
}
다음은 재노출 간격을 계산하고 컨텍스트 조건을 검사하는 핵심 컨트롤러다.
using UnityEngine;

public sealed class HintDecayController
{
    public float BaseInterval = 60f;
    public float MinInterval = 10f;
    public float MaxInterval = 90f;
    public float Alpha = 0.80f;
    public float Gamma = 1.30f;
    public float DismissalWeight = 0.50f;

    public float CalculateProficiency(ProficiencySnapshot snapshot)
    {
        return Mathf.Clamp01(
            0.30f * snapshot.SuccessRate +
            0.25f * snapshot.HintFreeSolveRate +
            0.20f * snapshot.LowAttemptSolveRate +
            0.15f * snapshot.RecallRate +
            0.10f * (1f - snapshot.FailurePressure));
    }

    public float CalculateInterval(ProficiencySnapshot snapshot)
    {
        float proficiency = CalculateProficiency(snapshot);
        float need = 1f - proficiency;
        float dismissalModifier = 1f + DismissalWeight * snapshot.DismissalRate;
        float interval = BaseInterval *
                         (1f - Alpha * Mathf.Pow(need, Gamma)) *
                         dismissalModifier;

        return Mathf.Clamp(interval, MinInterval, MaxInterval);
    }

    public bool ShouldReexpose(
        float now,
        float lastShownAt,
        ProficiencySnapshot snapshot,
        bool objectiveActive,
        bool inputLocked,
        int exposureCount,
        int exposureLimit)
    {
        if (!objectiveActive || inputLocked)
            return false;

        if (exposureCount >= exposureLimit)
            return false;

        return now - lastShownAt >= CalculateInterval(snapshot);
    }
}
핵심은 CalculateInterval과 실제 노출을 분리하는 것이다. 수식은 현재 필요한 시간을 계산하고 ShouldReexpose는 목표 활성화 여부, 입력 잠금, 최대 노출 횟수 같은 안전 조건을 검사한다.
구현 절차 1: 이벤트를 먼저 정의한다
힌트 시스템은 화면 코드에서 임의로 상태를 추측하지 말고 명시적인 이벤트를 수집해야 한다.
hint_shown: 힌트가 실제로 화면에 표시됨hint_dismissed: 플레이어가 닫기 또는 건너뛰기를 선택함objective_attempt_failed: 목표 수행에 실패함objective_completed: 목표를 완료함hint_free_completed: 힌트 없이 목표를 완료함input_recalled: 힌트를 본 뒤 관련 행동을 성공적으로 재현함
이벤트에는 objective_id, hint_id, timestamp, attempt_index, hint_level을 함께 기록한다. 그래야 특정 힌트가 유용했는지 또는 너무 자주 등장했는지 비교할 수 있다.
구현 절차 2: 숙련도와 좌절을 분리한다
숙련도와 좌절은 서로 반대처럼 보이지만 같은 변수로 처리하면 문제가 생긴다. 플레이어는 숙련되어도 외부 요인으로 잠시 실패할 수 있고 초보자라도 우연히 한 번 성공할 수 있다.
따라서 다음처럼 분리한다.
P: 목표를 이해하고 독립적으로 수행할 가능성F: 최근 실패와 반복 입력으로 추정한 좌절 압력D: 힌트를 닫거나 숨기는 명시적 거부 신호
P는 장기 추세에 사용하고 F는 짧은 시간 동안 T를 일시적으로 줄이는 보정값으로 사용할 수 있다. 예를 들어 10초 안에 같은 실패가 세 번 발생하면 다음 힌트만 0.7T로 줄이고 이후에는 원래 숙련도 기반 간격으로 복귀한다.
구현 절차 3: 힌트 단계를 함께 조절한다
재노출 간격만 줄이면 같은 문장을 빠르게 반복하는 문제가 생긴다. 힌트는 최소 세 단계로 나누는 것이 좋다.
| 단계 | 내용 | 노출 조건 |
|---|---|---|
| 1 | 목표와 관련된 일반적인 방향 | 첫 재노출 |
| 2 | 상호작용 대상 또는 입력 방식 제시 | 반복 실패 또는 긴 체류 |
| 3 | 다음 행동을 직접 지시 | 실패 압력이 높고 단계 2 이후에도 미해결 |
단계 상승은 영구적이지 않아야 한다. 플레이어가 단계 2 힌트를 본 뒤 성공하면 다음 목표에서는 단계 1부터 다시 시작한다. 같은 퀘스트 체인 안에서 이미 학습한 조작법만 예외적으로 낮은 단계에서 시작할 수 있다.
구현 절차 4: 재노출을 막는 보호 장치를 둔다
Hint Decay는 힌트를 더 자주 보여주는 시스템이므로 과잉 노출 방지가 필수다.
- 하나의 목표에서 최대 2~3회만 자동 재노출한다.
- 컷신, 전투 피격 직후, 대화 선택 중, 입력 잠금 상태에서는 노출하지 않는다.
- 플레이어가 같은 힌트를 두 번 연속 닫으면
D를 높이고 최소 30초의 추가 억제 시간을 적용한다. - 목표가 완료되면 예약된 힌트를 즉시 취소한다.
- 자동 힌트와 플레이어가 직접 요청한 힌트를 별도 카운트한다.
- 모바일과 접근성 설정에서는 자동 힌트 빈도를 독립적으로 조정할 수 있게 한다.
어떤 밸런싱 기준으로 파라미터를 조정할까?
초기값은 수학적으로 완벽한 값이 아니라 테스트 가능한 기준점이어야 한다. 플레이테스트에서는 다음 세 구간을 먼저 확인한다.
숙련도 P | 기본 의도 | 재노출 간격 예시 |
|---|---|---|
| 0.00~0.35 | 빠른 지원 필요 | 10~20초 |
| 0.35~0.70 | 상황에 따른 지원 | 25~50초 |
| 0.70~1.00 | 방해 최소화 | 60~90초 |
테스트 결과를 해석할 때는 평균만 보지 않는다. 다음 지표를 함께 확인해야 한다.
- 힌트 노출 후 15초 이내 목표 해결률
- 힌트 노출 후 즉시 닫기 비율
- 동일 목표의 평균 재노출 횟수
- 힌트 노출 전후의 실패율 변화
- 목표 포기율과 이전 구간 이탈률
- 숙련도 구간별 힌트 만족도
힌트 노출 후 해결률이 높아도 즉시 닫기 비율이 높다면 힌트 내용이 아니라 타이밍이 문제일 수 있다. 반대로 재노출 횟수는 낮지만 목표 포기율이 높다면 T_min이 너무 길거나 힌트 단계가 지나치게 약한 것이다.
자주 묻는 질문 FAQ
숙련도 점수를 저장해야 하나?
목표 단위 숙련도는 저장하는 것이 좋다. 다만 전체 게임의 영구 능력치처럼 저장하면 새로운 규칙을 학습할 때 잘못된 값이 이어질 수 있으므로 퀘스트 체인, 조작법, 시스템 카테고리별로 분리한다.
힌트를 계속 닫는 플레이어에게는 어떻게 해야 하나?
즉시 숙련자로 판정하지 말고 명시적 거부 신호로 처리한다. DismissalRate를 이용해 재노출 간격을 늘리고 자동 힌트 설정을 끌 수 있는 선택지를 제공한다.
실패가 한 번 발생했다고 바로 힌트를 보여줘도 되는가?
보통은 권장하지 않는다. 실패 직후에는 플레이어가 원인을 분석할 시간이 필요하다. 연속 실패 횟수, 동일 입력 반복, 목표 체류 시간 같은 신호를 함께 사용하고 최소 간격과 컨텍스트 차단 조건을 유지해야 한다.
정리
Hint Decay의 핵심은 힌트를 더 자주 보여주는 것이 아니라 플레이어의 현재 이해도와 지원 필요도를 추정하는 것이다. P로 숙련도를 계산하고 T로 재노출 간격을 조절하되 실패 압력과 힌트 거부는 별도 신호로 관리하면 시스템이 더 안정적으로 동작한다.
실무에서는 다음 순서로 시작하면 된다.
- 목표별 이벤트와 힌트 단계를 정의한다.
- 성공률, 힌트 없이 해결한 비율, 실패 압력을 0~1로 정규화한다.
T_min,T_base,T_max를 정하고 플레이테스트로 조정한다.- 최대 노출 횟수와 컨텍스트 차단 조건을 추가한다.
- 노출 후 해결률과 즉시 닫기 비율을 비교해 간격과 문구를 함께 개선한다.