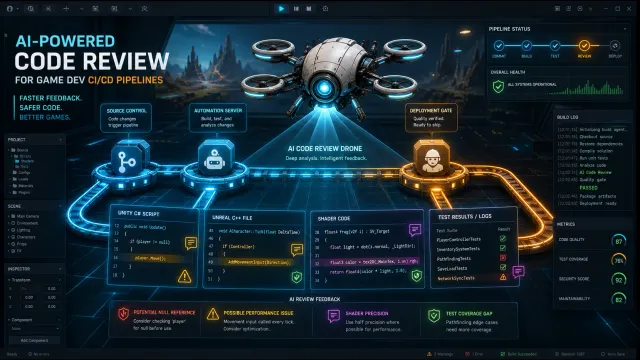
GitHub Actions에서 AI로 PR 성능 영향도 자동 분석하는 CI 워크플로우
GitHub Actions에서 PR 코드 변경과 기준선·헤드 벤치마크를 AI로 결합해 프레임 타임, 메모리, 드로 콜의 성능 회귀 위험을 자동 판정하고 PR 코멘트와 아티팩트로 공유하는 CI 워크플로우를 구현합니다. 포크 PR 보안 경계와 임계값 설계까지 함께 다룹니다.
TL;DR
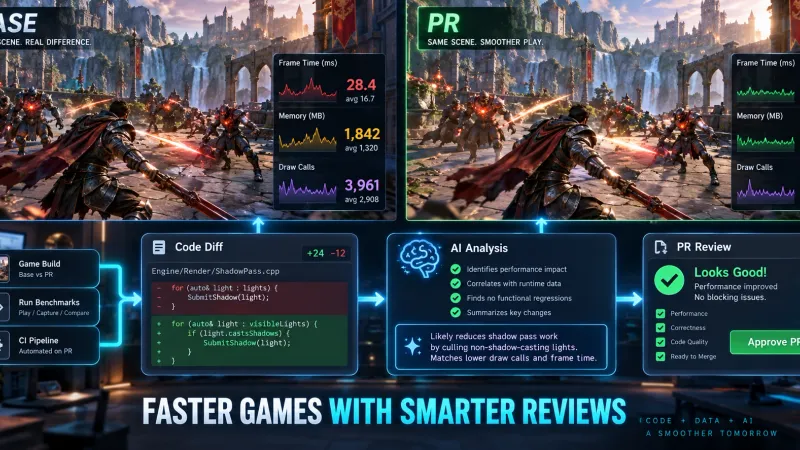
PR의 성능 영향도는 코드 diff만으로 확정할 수 없습니다. 먼저 동일한 벤치마크를 기준 브랜치와 PR 브랜치에서 실행해 프레임 타임, 메모리, 드로 콜 같은 수치형 지표를 만들고 그 결과와 diff를 AI에 함께 전달해야 합니다. AI는 측정값을 근거로 회귀 위험과 추가 검증 항목을 작성하고 GitHub Actions가 이를 PR 코멘트와 아티팩트로 공유합니다.
GitHub Actions에서 PR 성능 분석을 자동화해야 하는 이유
게임 성능 문제는 기능 테스트가 통과한 뒤에도 나타날 수 있습니다. 한 프레임 안에서 발생하는 메모리 할당, 렌더링 호출 증가, 에셋 로딩 지연은 일반적인 단위 테스트만으로 발견하기 어렵습니다.
특히 다음과 같은 변경은 작은 diff라도 실제 성능에 큰 영향을 줄 수 있습니다.
Update,Tick,Process계열 루프에 추가된 연산- 매 프레임 발생하는 객체 생성과 가비지 컬렉션 유발 코드
- 셰이더, 머티리얼, 텍스처, 애니메이션 리소스 변경
- 물리 충돌 레이어와 탐색 알고리즘 변경
- 네트워크 직렬화 또는 저장 데이터 변환 로직 변경
따라서 자동화의 핵심은 AI에게 성능을 추측하게 만드는 것이 아니라 측정 시스템과 코드 해석을 연결하는 것입니다.
AI는 PR 성능 영향도를 어떻게 판단하는가?
워크플로우는 다음 네 가지 입력을 결합합니다.
| 입력 | 내용 | 용도 |
|---|---|---|
| PR diff | 기준 커밋과 PR 커밋 사이의 변경 내용 | 성능에 영향을 줄 수 있는 코드 위치 파악 |
| Base benchmark | 기준 브랜치에서 측정한 결과 | 비교 기준선 생성 |
| Head benchmark | PR 브랜치에서 측정한 결과 | 현재 변경의 관측값 확보 |
| Delta | 두 결과의 상대 변화율 | 회귀 여부와 심각도 판단 |
성능 지표의 상대 변화율은 다음처럼 계산합니다.
프레임 타임, 로딩 시간, 메모리 사용량, 드로 콜은 값이 증가할수록 일반적으로 불리합니다. 반대로 FPS는 값이 감소할수록 불리하므로 지표별 판정 방향을 별도로 정의해야 합니다.
flowchart LR
  A[PR opened or synchronized] --> B[PR diff and metadata]
  A --> C[Base benchmark]
  A --> D[Head benchmark]
  C --> E[Delta calculation]
  D --> E
  B --> F[AI structured analysis]
  E --> F
  F --> G[PR comment and artifact]
AI의 역할은 +8%의 프레임 타임 증가가 특정 루프의 할당 증가와 관련 있는가?처럼 수치와 코드 근거를 연결하는 것입니다. 실제 측정값이 없으면 결과의 신뢰도를 낮추고 추가 프로파일링을 요청해야 합니다.
어떤 벤치마크 지표를 수집해야 하는가?
프로젝트의 엔진과 장르에 맞게 최소 지표를 정합니다. Unity, Unreal Engine, Godot 등 어떤 엔진을 사용하더라도 결과를 JSON으로 통일하면 동일한 분석 단계를 적용할 수 있습니다.
예를 들어 게임플레이 스모크 테스트의 결과를 다음처럼 저장할 수 있습니다.
{
  "suite": "gameplay-smoke",
  "commit": "abc1234",
  "metrics": {
    "frame_time_ms_p95": 8.4,
    "draw_calls_p95": 124,
    "alloc_mb_per_frame": 0.08,
    "load_time_ms_p95": 1240,
    "fps_p05": 112
  }
}p95는 측정값의 상위 95번째 백분위수이고 p05는 하위 5번째 백분위수입니다. 평균값만 사용하면 순간적인 스파이크가 가려질 수 있으므로 프레임 타임과 로딩 시간에는 백분위수를 사용하는 편이 안전합니다.
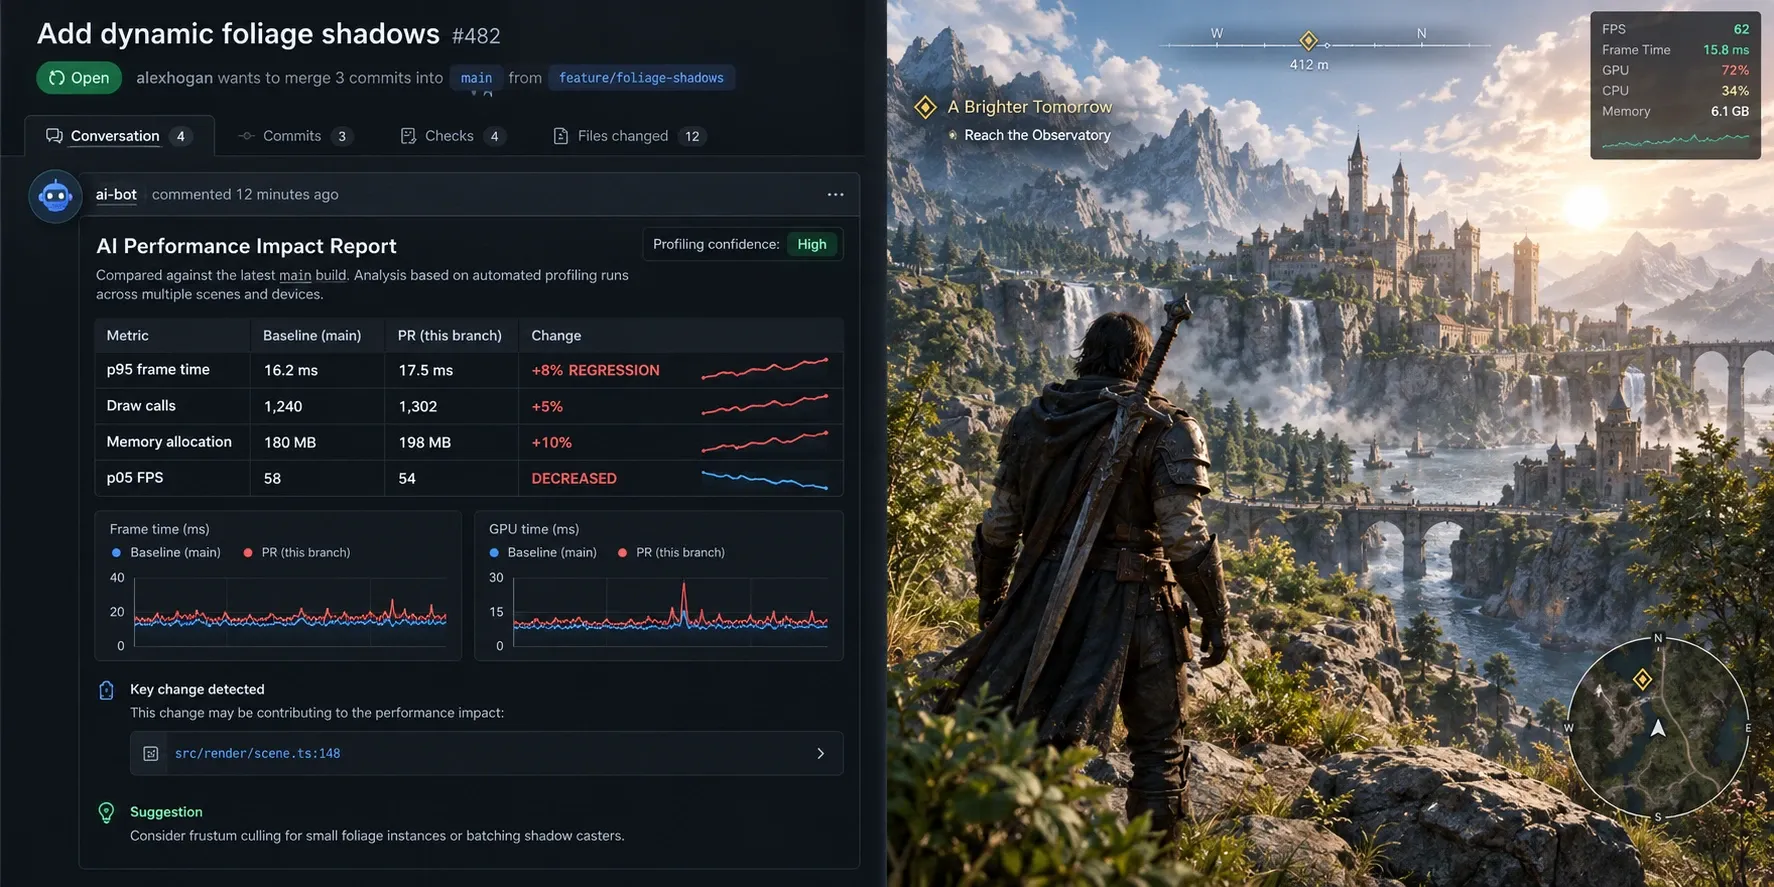
예시 임계값 정책
임계값은 프로젝트의 목표 플랫폼과 품질 기준에 따라 저장소의 설정 파일로 관리하는 것이 좋습니다. 다음은 설명을 위한 예시입니다.
| 지표 | 회귀 경고 | 차단 기준 | 판정 방향 |
|---|---|---|---|
frame_time_ms_p95 | 3% | 8% | 증가가 나쁨 |
draw_calls_p95 | 5% | 15% | 증가가 나쁨 |
alloc_mb_per_frame | 10% | 25% | 증가가 나쁨 |
load_time_ms_p95 | 5% | 15% | 증가가 나쁨 |
fps_p05 | -3% | -8% | 감소가 나쁨 |
측정 노이즈가 큰 환경에서는 한 번의 실행만으로 실패시키지 말고 동일 조건을 여러 번 실행해 중앙값이나 백분위수를 사용합니다.
GitHub Actions 워크플로우는 어떻게 구현할까?
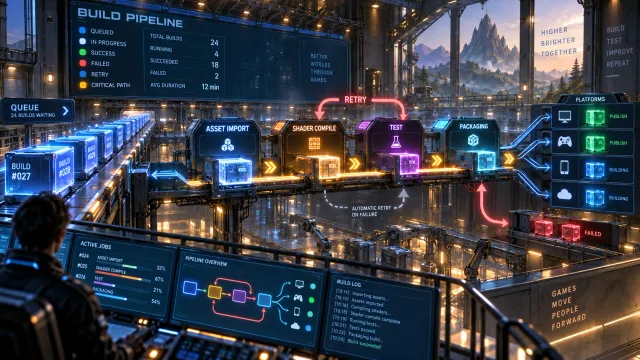
1단계: 기준 브랜치와 PR 브랜치의 성능을 측정한다
아래 예시는 프로젝트에 고정된 scripts/ci/perf-benchmark.sh가 JSON 결과를 생성한다고 가정합니다. 실제 명령은 Unity batchmode, Unreal Automation Test, Godot headless 실행 등 프로젝트에 맞게 교체합니다.
name: PR performance impact

on:
  pull_request:
    types: [opened, synchronize, reopened]

permissions:
  contents: read
  pull-requests: write

jobs:
  benchmark:
    if: github.event.pull_request.head.repo.full_name == github.repository
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
        with:
          fetch-depth: 0
          ref: ${{ github.event.pull_request.head.sha }}

      - name: Run head benchmark
        run: ./scripts/ci/perf-benchmark.sh --output perf/head.json

      - name: Run base benchmark
        run: |
          mkdir -p perf
          git worktree add "$RUNNER_TEMP/base" "${{ github.event.pull_request.base.sha }}"
          cd "$RUNNER_TEMP/base"
          ./scripts/ci/perf-benchmark.sh --output "$GITHUB_WORKSPACE/perf/base.json"

      - name: Calculate performance deltas
        run: python scripts/ci/compare_perf.py perf/base.json perf/head.json > perf/delta.json

      - uses: actions/upload-artifact@v4
        with:
          name: pr-performance-${{ github.event.pull_request.number }}
          path: perf/
retention-days: 14compare_perf.py는 각 metric에 대해 기준값, PR 값, 변화율, 임계값 초과 여부를 기록해야 합니다. 원본 결과와 비교 결과를 아티팩트로 보관하면 AI의 판단을 나중에 재검토할 수 있습니다. GitHub Actions의 아티팩트는 테스트 결과와 성능 측정 파일을 작업 간에 공유하고 보관하는 용도로 사용할 수 있습니다. 자세한 내용은 GitHub Actions 워크플로우 아티팩트 문서를 참고하세요.
2단계: diff와 성능 결과를 AI에 전달한다
다음 작업은 앞선 벤치마크 결과와 PR diff를 OpenAI Responses API에 전달하는 예시입니다. 모델 이름은 저장소 변수 AI_MODEL로 관리하고 프로젝트에서 사용할 수 있는 모델로 설정합니다.
  ai-review:
    needs: benchmark
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
        with:
          fetch-depth: 0
          ref: ${{ github.event.pull_request.head.sha }}

      - uses: actions/download-artifact@v4
        with:
          name: pr-performance-${{ github.event.pull_request.number }}
          path: perf

      - name: Create bounded diff
        run: |
          git diff --unified=80 \
            "${{ github.event.pull_request.base.sha }}" \
            "${{ github.event.pull_request.head.sha }}" \
            -- . ':(exclude)*.lock' > pr.diff
          head -c 120000 pr.diff > pr.diff.trimmed

      - name: Ask AI to analyze performance impact
        env:
          OPENAI_API_KEY: ${{ secrets.OPENAI_API_KEY }}
          PR_TITLE: ${{ github.event.pull_request.title }}
        run: |
          jq -n \
            --arg model "${{ vars.AI_MODEL || 'gpt-5' }}" \
            --arg pr_number "${{ github.event.pull_request.number }}" \
            --arg title "$PR_TITLE" \
            --rawfile diff pr.diff.trimmed \
            --rawfile base perf/base.json \
            --rawfile head perf/head.json \
            --rawfile delta perf/delta.json \
            '{
              model: $model,
              store: false,
              input: [
                {
                  role: "system",
                  content: [{
                    type: "input_text",
                    text: "게임 성능 회귀 분석가로 답한다. 제공된 diff와 측정값만 사용한다. 수치를 만들지 않는다. 결과에는 risk, confidence, evidence, findings, recommendation, missing_data를 포함하고 Markdown으로 작성한다."
                  }]
                },
                {
                  role: "user",
                  content: [{
                    type: "input_text",
                    text: ("PR #" + $pr_number + " " + $title + "\\n\\nDIFF\\n" + $diff + "\\n\\nBASE\\n" + $base + "\\n\\nHEAD\\n" + $head + "\\n\\nDELTA\\n" + $delta)
                  }]
                }
              ]
            }' > ai-request.json

          curl --fail --silent --show-error https://api.openai.com/v1/responses \
            -H "Authorization: Bearer $OPENAI_API_KEY" \
            -H "Content-Type: application/json" \
            --data @ai-request.json > ai-response.json

          jq -r '[.output[]?.content[]? | select(.type == "output_text") | .text] | join("\\n")' \
            ai-response.json > ai-report.md
          test -s ai-report.md
Responses API의 기본 요청 형식은 OpenAI API 빠른 시작 문서에서 확인할 수 있습니다. diff는 무제한으로 전송하지 말고 파일 크기와 민감 정보 종류를 제한해야 합니다. 게임 밸런스 데이터, 상용 SDK 키, 플레이어 개인정보가 포함된 파일은 분석 대상에서 제외합니다.
3단계: AI 결과를 PR 코멘트로 갱신한다
매번 새 댓글을 만들면 PR이 빠르게 지저분해집니다. 고정 마커를 사용해 기존 봇 댓글을 찾아 갱신합니다.
      - name: Update PR comment
        uses: actions/github-script@v7
        with:
          github-token: ${{ secrets.GITHUB_TOKEN }}
          script: |
            const fs = require('fs');
            const marker = '<!-- ai-performance-impact -->';
            const report = fs.readFileSync('ai-report.md', 'utf8');
            const body = marker + '\\n## AI PR 성능 영향도\\n' + report;
            const issue_number = context.payload.pull_request.number;
            const { data: comments } = await github.rest.issues.listComments({
              owner: context.repo.owner,
              repo: context.repo.repo,
              issue_number
            });
            const existing = comments.find(comment => comment.body?.includes(marker));
            if (existing) {
              await github.rest.issues.updateComment({
                owner: context.repo.owner,
                repo: context.repo.repo,
                comment_id: existing.id,
                body
              });
            } else {
              await github.rest.issues.createComment({
                owner: context.repo.owner,
                repo: context.repo.repo,
                issue_number,
                body
              });
            }

      - uses: actions/upload-artifact@v4
        with:
          name: pr-ai-performance-report-${{ github.event.pull_request.number }}
          path: |
            ai-request.json
            ai-response.json
            ai-report.md
          retention-days: 14
AI 분석 결과를 CI 실패 조건으로 사용할 때 주의할 점
AI의 자연어 판단만으로 CI를 실패시키면 재현성과 신뢰성이 낮아집니다. CI의 차단 여부는 delta.json의 수치 임계값으로 결정하고 AI는 원인 후보와 검증 순서를 설명하는 역할을 맡기는 편이 좋습니다.
권장 정책은 다음과 같습니다.
- 수치 임계값을 초과하면
performance-gate를 실패시킨다. - 임계값을 넘지 않아도 AI가 높은 위험을 보고하면 경고 코멘트를 남긴다.
- 벤치마크가 실행되지 않았거나 신뢰구간이 넓으면
missing_data로 표시한다. - 최종 병합 승인은 담당 개발자가 프로파일러와 실제 디바이스 측정으로 확인한다.
AI 출력에는 최소한 다음 필드를 요구하면 결과를 자동 처리하기 쉽습니다.
| 필드 | 의미 |
|---|---|
risk | low, medium, high 중 하나 |
confidence | 측정값과 diff 근거에 대한 신뢰도 |
evidence | 관련 파일, 함수, 측정 지표 |
findings | 성능 영향이 예상되는 변경 |
recommendation | 다음 프로파일링 또는 수정 단계 |
missing_data | 판단에 부족한 측정값 |
pull_request_target을 사용하면 안 되는 이유는 무엇인가?
포크 PR까지 분석하기 위해 pull_request_target을 사용하고 시크릿을 주입하는 패턴은 특히 주의해야 합니다. PR 코드가 실행되는 위치에 OPENAI_API_KEY와 쓰기 권한이 함께 노출되면 악성 변경이 시크릿을 탈취하거나 저장소에 댓글을 남길 수 있습니다.
이 예시는 다음 두 가지 방어선을 사용합니다.
- 이벤트는
pull_request로 제한한다. - 벤치마크와 AI 호출은 동일 저장소 브랜치에서 온 PR에만 실행한다.
포크 PR도 분석해야 한다면 PR 코드를 실행하는 작업과 시크릿을 사용하는 작업을 분리합니다. 예를 들어 신뢰된 별도 서비스나 GitHub App이 diff만 받아 분석하도록 설계하고 pull_request_target에서 검증되지 않은 PR 코드를 checkout하거나 실행하지 않습니다.
자주 묻는 질문(FAQ)
코드 diff만 AI에 보내도 성능 영향을 알 수 있나요?
가능하지만 정성적 위험 추정에 불과합니다. 실제 회귀 판정에는 기준 브랜치와 PR 브랜치에서 동일 조건으로 수집한 벤치마크 결과가 필요합니다.
벤치마크 결과가 실행마다 달라지면 어떻게 하나요?
동일 러너와 고정된 테스트 시드를 사용하고 여러 번 실행한 중앙값 또는 백분위수를 사용합니다. 절대 차단 기준은 노이즈보다 충분히 큰 값으로 정하고 작은 변화는 경고로 처리합니다.
AI가 잘못된 원인을 말하면 어떻게 방지하나요?
프롬프트에 제공된 diff와 측정값만 사용하고 수치를 만들지 말라고 명시합니다. 또한 evidence, confidence, missing_data를 필수 필드로 두고 AI의 설명을 최종 승인 근거가 아닌 조사 우선순위로 사용합니다.
정리
GitHub Actions 기반 PR 성능 영향도 자동 분석은 측정 → 비교 → AI 해석 → PR 공유의 순서로 구성하는 것이 안정적입니다. 벤치마크와 임계값은 결정론적인 CI 로직으로 유지하고 AI는 코드 변경과 수치 사이의 관계를 요약하게 하면 성능 회귀를 더 일찍 발견하면서도 잘못된 자동 차단을 줄일 수 있습니다.
구현을 시작할 때는 먼저 대표 플레이 시나리오 하나와 frame_time_ms_p95, alloc_mb_per_frame, draw_calls_p95 세 지표를 고정하세요. 이후 플랫폼별 기준선과 차단 정책을 추가하면 프로젝트 규모에 맞는 PR 성능 게이트로 확장할 수 있습니다.