게임 개발 마일스톤별 팀 벨로시티 분석으로 일정 지연 위험 AI 조기 경보 구축하기
프로덕션부터 출시 안정화까지 마일스톤별 벨로시티와 스코프 변화를 분석해 일정 지연 확률을 예측하고 실무에서 활용할 AI 조기 경보 체계를 설계하는 방법을 설명합니다.
핵심 요약
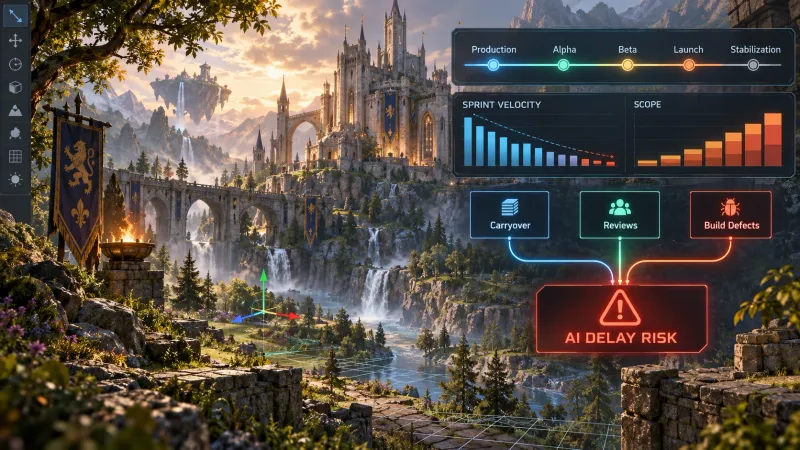
게임 개발 일정 지연은 팀의 작업 속도보다 마일스톤별 완료 기준과 스코프 변화가 어떻게 움직이는지를 함께 봐야 조기에 감지할 수 있습니다. 팀 벨로시티, 이월 작업률, 스코프 증가율, 블로커 체류 시간, 코드 리뷰 지연 시간을 입력값으로 사용하면 다음 마일스톤의 지연 확률을 계산할 수 있습니다.
AI 조기 경보는 팀을 평가하는 점수표가 아니라 일정 위험이 커졌을 때 PM이 스코프를 줄이거나 우선순위를 조정하고 협업 장애를 제거하도록 돕는 의사결정 시스템이어야 합니다.
게임 개발 일정 지연은 왜 늦게 발견되는가?
많은 팀이 전체 잔여 작업량과 남은 기간만 비교하다가 일정 지연을 늦게 발견합니다. 하지만 게임 개발에서는 마일스톤마다 작업의 성격이 달라집니다.
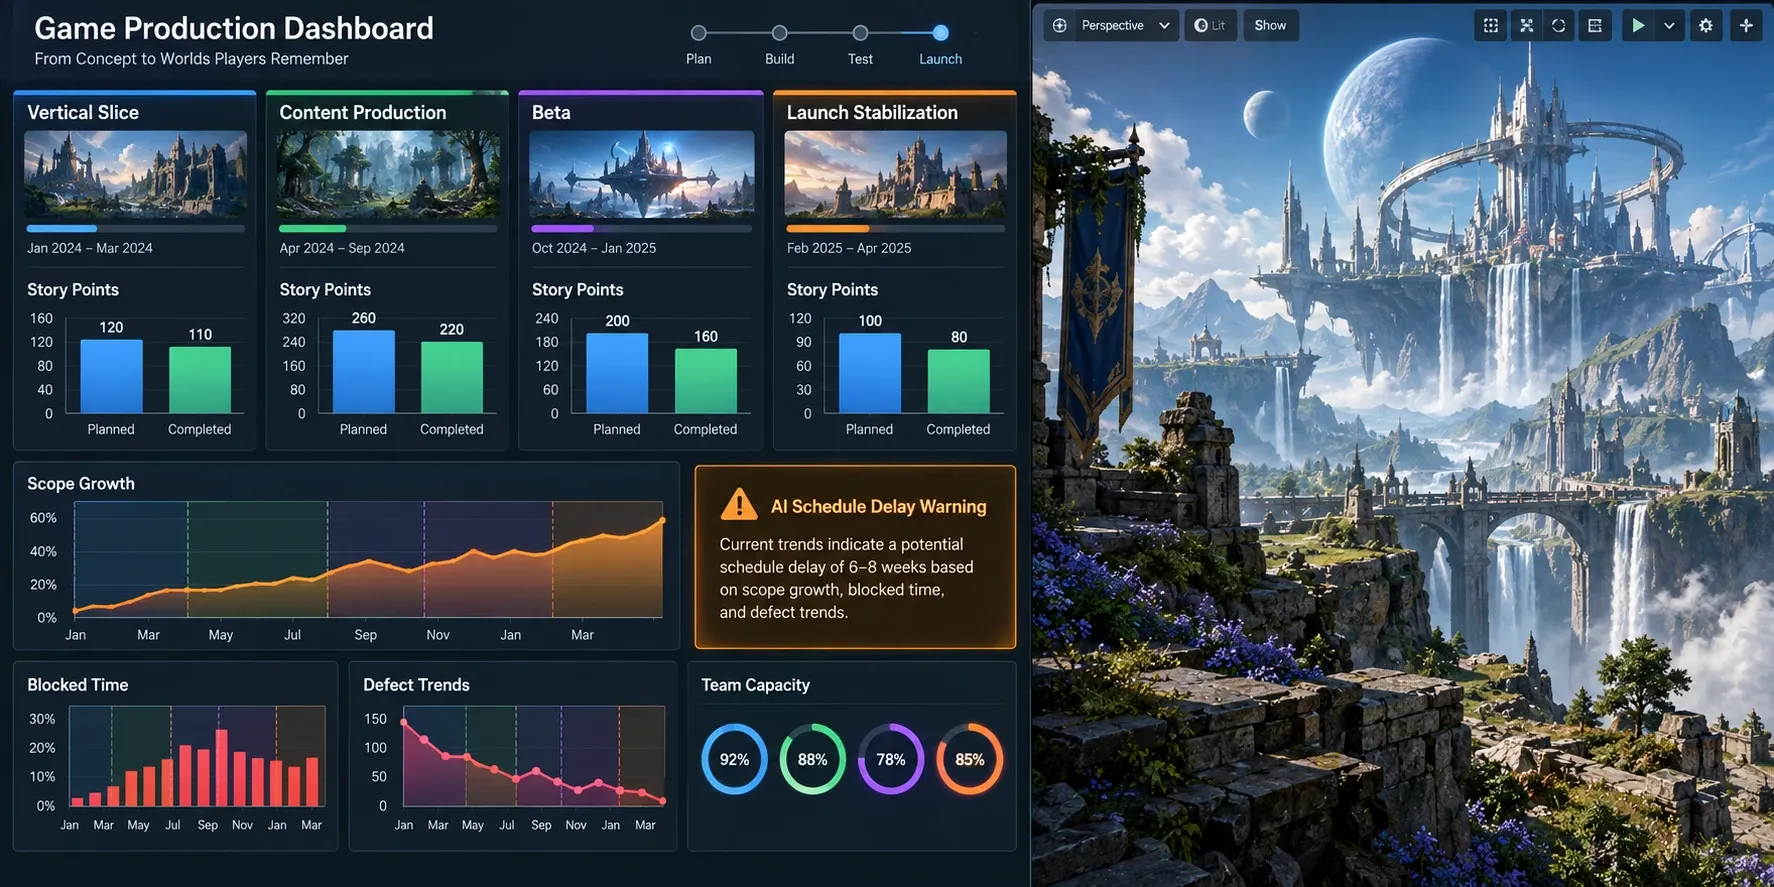
프리프로덕션에서는 불확실성이 높고 프로토타입 폐기율이 큽니다. 버티컬 슬라이스에서는 핵심 플레이 루프와 기술 위험을 검증해야 합니다. 콘텐츠 제작 단계에서는 반복 생산성이 중요하고 출시 안정화 단계에서는 작업량보다 결함 해결 속도와 빌드 품질이 중요합니다.
따라서 같은 20 Story Point라도 마일스톤에 따라 의미가 다릅니다. 일정 지연 위험을 계산할 때는 팀 전체의 평균 벨로시티 하나만 사용하는 대신 마일스톤별 기준선을 만들어야 합니다.
마일스톤별로 어떤 벨로시티 지표를 봐야 하는가?
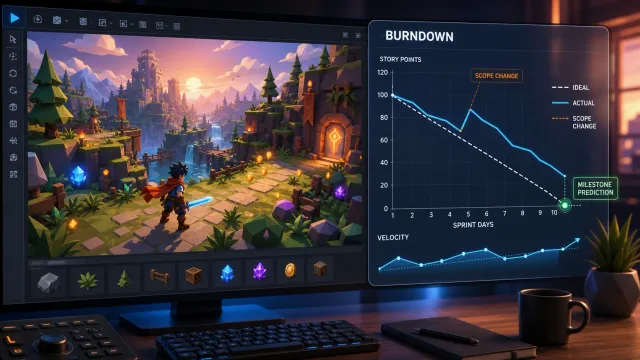
벨로시티는 스프린트에서 완료된 작업량을 나타내는 지표입니다. 단, 작업을 Done으로 옮긴 양이 아니라 기획·구현·아트·QA의 완료 조건을 충족한 작업만 집계해야 합니다.
권장 기본 수식은 다음과 같습니다.
여기서 v_m은 특정 마일스톤 m의 일일 유효 벨로시티이고 A_m은 승인된 작업량입니다. D_m은 휴일, 교육, 긴급 대응을 제외한 유효 작업일입니다.
| 마일스톤 | 핵심 완료 기준 | 우선 관찰할 지표 | 대표 위험 신호 |
|---|---|---|---|
| 프리프로덕션 | 핵심 재미와 기술 방향 검증 | 가설 검증 속도, 프로토타입 폐기율 | 반복되는 방향 전환, 미확정 의사결정 |
| 버티컬 슬라이스 | 핵심 루프가 완성도 높은 형태로 작동 | 기능 완료율, 통합 성공률, 기술 부채 | 임시 구현 증가, 통합 테스트 실패 |
| 콘텐츠 제작 | 정해진 품질 기준으로 콘텐츠 반복 생산 | 승인 콘텐츠 수, 제작 리드타임, 재작업률 | 승인 대기 증가, 재작업률 상승 |
| 베타·피처 컴플리트 | 출시 범위의 기능과 콘텐츠 완료 | 잔여 스코프, 이월률, 결함 추세 | 새 기능 유입, 우선순위 충돌 |
| 출시 안정화 | 치명 결함과 플랫폼 이슈 해결 | 결함 해결 속도, 빌드 성공률, 회귀 결함 | 고위험 결함 누적, 빌드 불안정 |
마일스톤별 기준선은 최소 3~5개 스프린트의 데이터를 사용해 계산하는 것이 좋습니다. 데이터가 부족한 초기 단계에서는 과거 프로젝트의 값을 그대로 복사하지 말고 현재 팀의 인원·직군 구성·근무일·완료 정의를 반영한 임시 기준선을 사용해야 합니다.
일정 지연 위험을 예측하려면 어떤 데이터를 수집해야 하는가?
AI 모델보다 먼저 데이터 정의를 고정해야 합니다. 다음 필드를 스프린트 또는 주간 단위로 저장하면 최소한의 예측 시스템을 만들 수 있습니다.
| 데이터 그룹 | 필드 예시 | 활용 목적 |
|---|---|---|
| 작업량 | 계획 Story Point, 완료 Story Point, 잔여 작업량 | 벨로시티와 완료율 계산 |
| 스코프 | 기준 스코프, 신규 유입, 제거된 작업 | 스코프 증가율 계산 |
| 흐름 | 이월 작업 수, Cycle Time, Blocked Time | 작업 흐름의 병목 확인 |
| 품질 | 신규 결함, 해결 결함, 재오픈 결함, 회귀 결함 | 안정화 속도 측정 |
| 협업 | 리뷰 대기 시간, 승인 대기 시간, 외부 의존성 | 의사결정 지연 확인 |
| 팀 상태 | 실제 투입 인원, 휴가, 직군별 가용 시간 | 벨로시티 변동 보정 |
| 일정 | 목표 마일스톤 날짜, 예상 완료일 | 지연 여부 라벨 생성 |
Story Point를 그대로 비교해도 되는가?
Story Point는 절대적인 생산량이 아니라 팀 내부의 상대적 복잡도입니다. 팀이 바뀌거나 완료 정의가 달라지면 동일한 5점 작업도 다른 의미를 가질 수 있습니다.
따라서 다음 원칙을 적용해야 합니다.
- 팀별 Story Point를 섞지 않습니다.
- 마일스톤이 바뀌면 기준선을 다시 계산합니다.
- 완료된 작업만 벨로시티에 포함합니다.
- 긴급 작업과 운영 장애 대응 시간을 별도 필드로 기록합니다.
- Story Point와 함께 실제 Cycle Time을 저장합니다.
콘텐츠 제작팀처럼 작업 크기를 비교하기 어려운 조직은 승인된 콘텐츠 수, 제작 시간, 재작업률을 함께 사용하는 편이 더 정확할 수 있습니다.
팀 벨로시티로 지연 위험 점수를 어떻게 계산하는가?
가장 먼저 통계 기반 경보를 구현하고 그다음 머신러닝 모델을 추가하는 방식이 안전합니다. 초기 버전부터 복잡한 딥러닝 모델을 사용하면 데이터 부족과 설명 가능성 문제로 운영이 어려워질 수 있습니다.
1단계: 기준선과 변동성을 계산한다
최근 k개 스프린트의 중앙값을 기준 벨로시티로 둡니다.
현재 벨로시티가 기준선에서 얼마나 벗어났는지는 다음과 같이 계산할 수 있습니다.
MAD는 Median Absolute Deviation이며 이상치에 강한 변동성 지표입니다. epsilon은 0으로 나누는 문제를 막기 위한 작은 값입니다.
2단계: 스코프 변화와 흐름 지표를 결합한다
스코프 증가율은 기준 시점의 작업량과 현재 작업량을 비교합니다.
예를 들어 벨로시티가 10% 감소했지만 스코프가 25% 증가했다면 실제 일정 위험은 단순한 속도 저하보다 큽니다. 함께 사용할 수 있는 주요 특징값은 다음과 같습니다.
velocity_drop: 기준 벨로시티 대비 현재 벨로시티 하락률scope_growth: 기준 스코프 대비 신규 작업 증가율carryover_rate: 이전 스프린트에서 넘어온 작업 비율blocker_age_p90: 블로커 체류 시간의 90번째 백분위수review_latency_p90: 코드 리뷰 또는 승인 대기 시간의 90번째 백분위수reopen_rate: 완료 후 재오픈된 작업 비율capacity_change: 계획 대비 실제 투입 가능 시간 변화율
3단계: 지연 확률을 계산한다
초기에는 설명 가능한 로지스틱 회귀 모델을 사용할 수 있습니다. 예시 수식은 다음과 같습니다.
여기서 p_delay는 목표 마일스톤 날짜를 넘길 확률입니다. 계수 β는 과거 스프린트의 실제 지연 여부를 라벨로 사용해 학습합니다.
Python 3.12와 pandas를 사용하는 단순한 특징값 계산 예시는 다음과 같습니다.
import pandas as pd

sprints = pd.DataFrame({
    "milestone": ["vertical_slice"] * 4,
    "accepted_points": [18, 20, 14, 12],
    "effective_days": [10, 10, 9, 10],
    "scope_growth": [0.02, 0.05, 0.14, 0.18],
    "carryover_rate": [0.05, 0.10, 0.22, 0.31],
})

sprints["velocity"] = (
    sprints["accepted_points"] / sprints["effective_days"]
)

baseline = sprints["velocity"].iloc[:2].median()
sprints["velocity_drop"] = (
    (baseline - sprints["velocity"]) / baseline
).clip(lower=0)

sprints["risk_signal"] = (
    0.45 * sprints["velocity_drop"]
    + 0.30 * sprints["scope_growth"]
    + 0.25 * sprints["carryover_rate"]
)

print(sprints[["velocity", "velocity_drop", "risk_signal"]])
이 예시의 risk_signal은 학습된 확률이 아니라 운영 초기의 규칙 기반 점수입니다. 실제 확률로 표현하려면 과거 프로젝트 데이터를 사용해 LogisticRegression 또는 GradientBoostingClassifier를 학습하고 예측 확률의 보정 상태를 확인해야 합니다.
AI 조기 경보 기준은 어떻게 설정해야 하는가?
경보는 세 단계로 나누는 것이 실무에 적합합니다. 임계값은 고정된 정답이 아니며 팀의 과거 오탐률과 미탐률을 확인해 조정해야 합니다.
| 단계 | 조건 예시 | PM 대응 |
|---|---|---|
| 관찰 | p_delay >= 0.35 또는 2회 연속 벨로시티 하락 | 원인 확인, 데이터 품질 점검 |
| 주의 | p_delay >= 0.55 또는 스코프 증가율 15% 초과 | 우선순위 재정렬, 의존성 담당자 지정 |
| 위험 | p_delay >= 0.75 또는 마일스톤 완료 예상일 초과 | 스코프 컷, 일정 재협상, 경영진 보고 |
경보 메시지에는 점수만 표시하지 말고 원인과 권장 행동을 함께 넣어야 합니다.
[주의] Vertical Slice 마일스톤 일정 지연 확률 62%
근거: 최근 3회 벨로시티 27% 하락, 이월률 31%, 스코프 증가율 18%
권장: 신규 기능 2건을 다음 마일스톤으로 이동하고 렌더링 버그 담당자를 지정하세요.
다음 흐름처럼 데이터 수집부터 PM 의사결정까지 연결합니다.
flowchart TD
    A[이슈 트래커와 Git 저장소 데이터 수집] --> B[마일스톤별 지표 정규화]
    B --> C[벨로시티와 스코프 변화 계산]
    C --> D[통계 경보 또는 ML 지연 확률 산출]
    D --> E{임계값 초과 여부}
    E -->|아니오| F[대시보드에 추세 기록]
    E -->|예| G[원인과 권장 행동이 포함된 알림 전송]
    G --> H[PM이 스코프와 우선순위 조정]
    H --> I[조치 결과를 다음 학습 데이터에 반영]
지연 위험 AI를 어떻게 구현하는가? 5단계 운영 절차
1. 마일스톤과 완료 정의를 고정한다
먼저 Vertical Slice Done이나 Beta Feature Complete처럼 마일스톤별 완료 조건을 문서화합니다. 기능이 구현되었지만 QA 검증이 끝나지 않았다면 완료로 볼 것인지도 명시해야 합니다.
완료 정의에는 다음 항목을 포함합니다.
- 구현과 코드 리뷰 완료
- 필요한 아트 리소스 적용
- QA 테스트 통과
- 알려진 치명 결함 없음
- 담당자의 승인 또는 PO 승인 완료
2. 데이터 수집 주기를 통일한다
Jira, Linear, GitHub Projects 등 이슈 트래커에서 스프린트 데이터를 매일 수집할 수 있습니다. GitHub 이벤트에서는 Pull Request 생성부터 병합까지의 시간과 리뷰 횟수를 가져옵니다.
단, 커밋 수나 코드 라인 수를 개인 생산성 지표로 사용하면 안 됩니다. 게임 개발의 실제 완료는 코드 외에도 기획 검토, 아트 제작, 애니메이션, 사운드, QA와 연결되기 때문입니다.
3. 마일스톤별 기준선을 만든다
각 마일스톤에 대해 최근 완료 스프린트의 중앙 벨로시티와 변동성을 저장합니다. 팀 구성원이 바뀌거나 핵심 시스템이 변경되면 기존 기준선에 새 데이터를 무조건 합치지 말고 기준선 버전을 갱신합니다.
예시 기준선 레코드는 다음과 같습니다.
{
  "milestone": "content_production",
  "baseline_version": "2026-Q3-v2",
  "median_velocity": 23.5,
  "mad_velocity": 3.2,
  "median_cycle_time_days": 4.1,
  "alert_thresholds": {
    "observe": 0.35,
    "warning": 0.55,
    "critical": 0.75
  }
}
4. 경보 전에 사람이 검증한다
자동 알림을 바로 전사 채널에 보내기보다 PM 또는 프로듀서가 확인하는 검토 단계를 두는 것이 좋습니다. 휴가, 플랫폼 인증 이슈, 외부 SDK 장애처럼 데이터만으로 설명하기 어려운 사건이 있기 때문입니다.
경보 검토 체크리스트는 다음과 같습니다.
- 실제 스코프가 증가했는가?
- 완료 정의가 최근에 바뀌지 않았는가?
- 팀의 실투입 시간이 감소했는가?
- 특정 의존성이나 승인 대기가 병목인가?
- 위험을 줄일 수 있는 스코프 컷이 있는가?
5. 조치 결과를 다시 기록한다
경보가 발생한 뒤 스코프를 줄였는지 담당자를 바꿨는지 일정을 조정했는지 기록해야 합니다. 실제 지연 여부뿐 아니라 어떤 조치로 위험이 해소되었는지도 데이터로 남겨야 다음 예측의 품질이 좋아집니다.
어떤 AI 모델을 선택해야 하는가?
데이터 규모와 설명 가능성에 따라 선택합니다.
| 상황 | 권장 방식 | 이유 |
|---|---|---|
| 과거 지연 데이터가 거의 없음 | 규칙 기반 점수와 관리도 | 빠르게 시작하고 원인 설명이 쉬움 |
| 스프린트·마일스톤 데이터가 충분함 | 로지스틱 회귀 | 지연 확률과 변수 영향 설명 가능 |
| 비선형 관계가 많음 | Gradient Boosting | 스코프와 품질 지표의 복합 패턴 학습 |
| 팀별 데이터가 충분히 축적됨 | 계층적 모델 또는 팀별 모델 | 팀 간 기준선 차이 반영 |
모델 성능은 정확도 하나로 평가하지 않습니다. 일정 지연을 놓치는 비용이 크다면 Recall을 높이는 방향으로 임계값을 조정하고 경보 피로가 문제라면 Precision과 주간 경보 횟수를 함께 관리해야 합니다.
운영 대시보드에는 다음 지표를 표시하는 것이 좋습니다.
- 예측 확률과 실제 결과의 차이
- 경보 Precision, Recall
- 평균 조기 탐지 기간
- 마일스톤별 오탐률
- 경보 이후 실제로 실행된 조치 비율
- 팀별 기준선 변경 이력
AI 경보가 팀 운영을 해치지 않게 하려면?
가장 큰 위험은 AI 점수가 사람을 평가하는 인사 지표로 변질되는 것입니다. 벨로시티 하락은 개인의 능력 부족이 아니라 요구사항 변경, 승인 지연, 기술 부채, 외부 의존성 때문일 수 있습니다.
운영 원칙은 명확해야 합니다.
- 개인별 순위가 아니라 마일스톤 위험을 표시합니다.
- 원인 없는 경보를 보내지 않습니다.
- 점수보다 추세와 근거를 우선합니다.
- 모델이 틀릴 수 있음을 화면에 표시합니다.
- 팀 회고에서 경보의 유용성과 오탐 원인을 함께 검토합니다.
- 데이터 접근 권한과 보존 기간을 문서화합니다.
또한 동일한 경보라도 수신자에 따라 표현을 달리해야 합니다. 개발팀에는 블로커와 기술적 원인을 제공하고 경영진에는 일정 영향과 선택 가능한 스코프 조정안을 제공하는 방식입니다.
자주 묻는 질문(FAQ)
벨로시티가 한 번 떨어지면 바로 일정 지연으로 봐야 하나요?
아닙니다. 한 번의 하락은 휴가나 긴급 장애 때문일 수 있습니다. 최소 2~3회 연속 하락하거나 스코프 증가와 이월률 상승이 함께 나타나는지 확인해야 합니다.
Story Point가 없는 팀도 AI 조기 경보를 만들 수 있나요?
가능합니다. 승인 콘텐츠 수, 평균 Cycle Time, 결함 해결 시간, 재작업률, 실제 투입 시간처럼 팀의 완료 흐름을 나타내는 지표를 사용하면 됩니다. 중요한 것은 지표의 일관성과 완료 정의입니다.
일정 지연 확률의 적정 임계값은 얼마인가요?
모든 팀에 같은 값이 적용되지는 않습니다. 과거 데이터에서 오탐과 미탐 비용을 비교한 뒤 결정해야 합니다. 초기에는 관찰 35%, 주의 55%, 위험 75%처럼 세 단계로 시작하고 회고를 통해 조정할 수 있습니다.
정리
게임 개발의 일정 지연 위험은 벨로시티 하나로 예측하기 어렵습니다. 마일스톤별 완료 정의를 먼저 고정하고 팀 벨로시티, 스코프 증가율, 이월률, 블로커 체류 시간, 품질 지표를 함께 분석해야 합니다.
실무에서는 통계 기반 경보로 시작한 뒤 충분한 과거 데이터가 쌓이면 로지스틱 회귀나 Gradient Boosting 모델로 확장하는 접근이 안정적입니다. 가장 중요한 결과는 정확한 숫자가 아니라 PM이 위험을 일찍 발견하고 스코프와 우선순위를 조정할 수 있는 시간입니다.