C# Async/Await로 대규모 LLM API 병목과 GC를 줄이는 실전 패턴
C# Async/Await 기반 LLM API 대량 호출에서 스레드 고갈, 무제한 동시성, 문자열·JSON 할당으로 생기는 병목을 진단하고 SemaphoreSlim, 재시도, 스트리밍, 풀링으로 안정화하는 방법을 정리합니다.
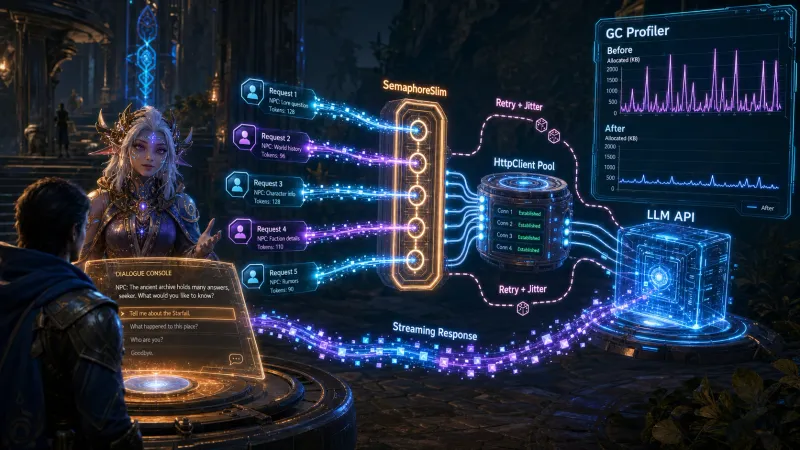
대규모 LLM API 요청의 병목은 async/await 자체가 아니라 무제한 동시 요청, 요청마다 새로 만드는 HttpClient, 큰 문자열·JSON 객체의 반복 할당에서 주로 발생한다. 요청 수를 SemaphoreSlim으로 제한하고 취소·재시도·응답 크기를 제어하며 핫 패스의 문자열 및 버퍼 할당을 줄이면 프레임 드롭과 GC 스파이크를 함께 낮출 수 있다.
대규모 LLM API 요청에서 병목은 왜 발생하는가?
게임 클라이언트에서 LLM API는 NPC 대화, 퀘스트 생성, 운영 도구, 플레이어 신고 분류처럼 한 번에 여러 요청이 몰릴 수 있는 기능에 쓰인다. 이때 Task.WhenAll에 모든 요청을 그대로 전달하면 네트워크 대기 중인 작업은 스레드를 계속 점유하지 않더라도 다음 비용이 누적된다.
| 원인 | 실제 문제 | 게임 클라이언트 증상 |
|---|---|---|
| 무제한 동시성 | 연결, 소켓, 서버 측 rate limit이 동시에 포화된다 | 지연 시간 급증, 429·5xx 증가 |
요청마다 HttpClient 생성 | 연결 재사용이 깨지고 소켓 자원이 불필요하게 늘어난다 | 간헐적 연결 실패, 처리량 저하 |
| 큰 JSON 문자열 생성 | string, UTF-8 바이트 배열, JSON DOM이 반복 할당된다 | GC 스파이크, 프레임 시간 상승 |
| 동기 대기 | .Result, .Wait()가 호출 스레드를 막는다 | Unity 메인 스레드 멈춤, 교착 위험 |
| 재시도 폭주 | 실패한 요청이 같은 순간에 다시 몰린다 | API 장애가 더 길어진다 |
처리량은 동시성만 올린다고 계속 증가하지 않는다. 평균 응답 시간이 L초이고 안정적으로 유지 가능한 동시 요청 수가 C라면 이론상 초당 완료 요청 수의 상한은 다음과 같이 볼 수 있다.
예를 들어 평균 응답 시간이 2초이고 API와 클라이언트가 안정적으로 감당할 수 있는 동시 요청 수가 8개라면 초당 약 4개가 상한이다. 동시성을 100개로 올리면 대기열과 실패율만 커질 가능성이 높다.
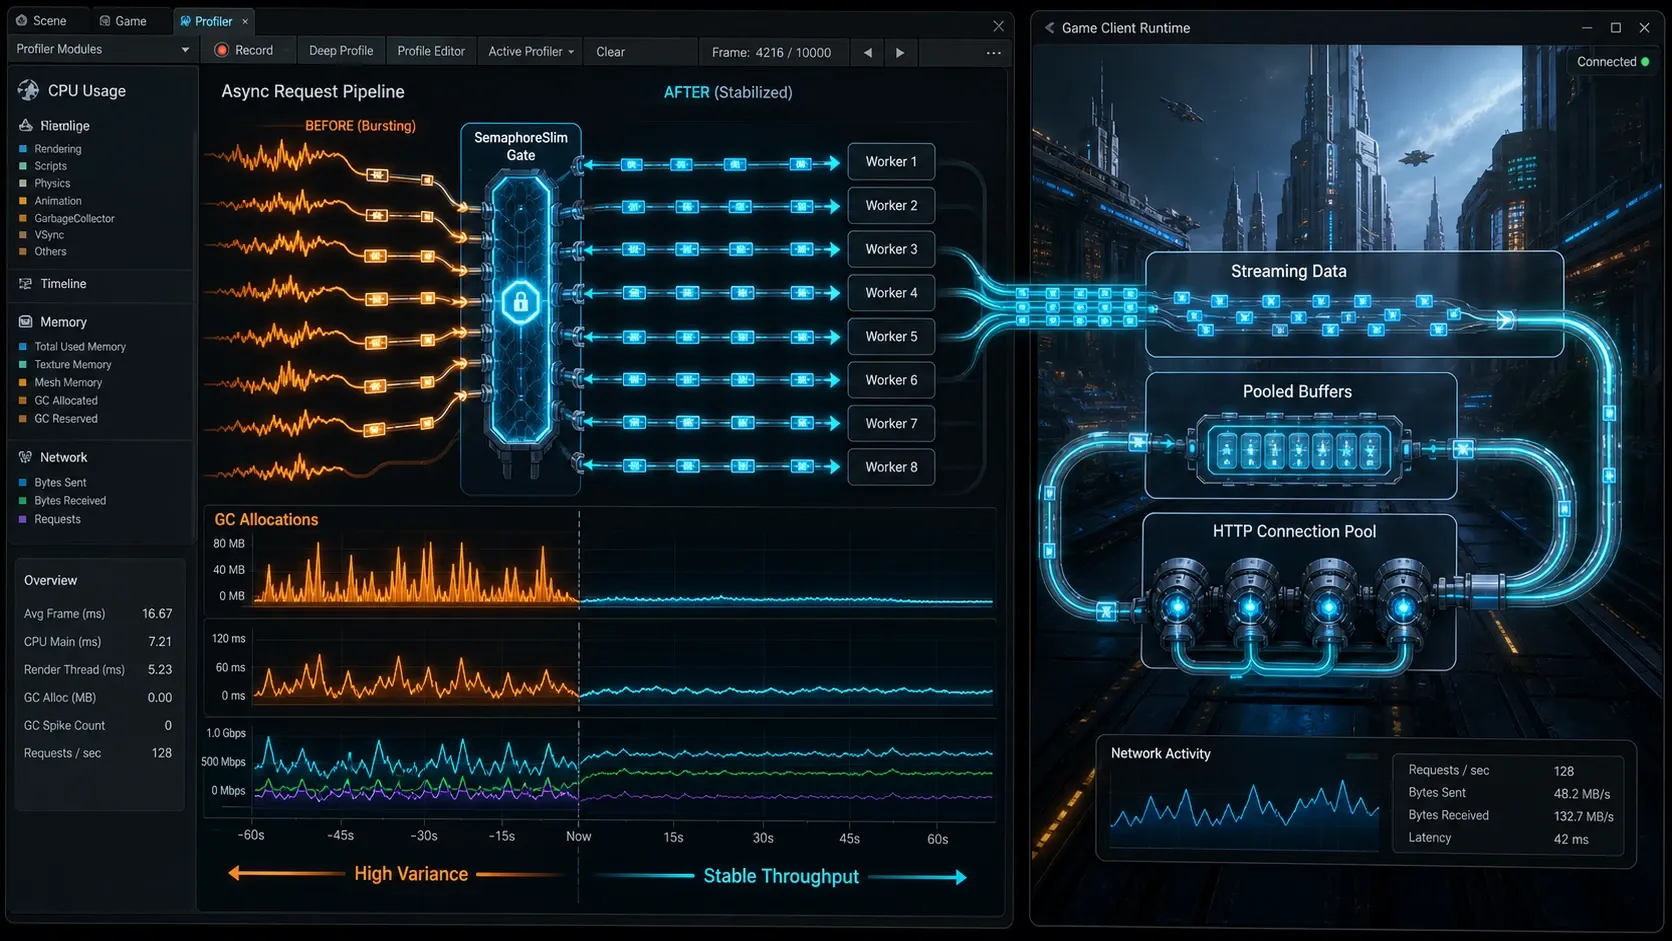
C# Async/Await 대량 요청은 어떻게 제한할까?
핵심은 모든 작업을 즉시 실행하지 않고 동시 실행 수만 제한하는 것이다. SemaphoreSlim 하나면 대부분의 클라이언트 요청 큐에 충분하다.
1. 재사용하는 HttpClient와 동시성 제한기를 둔다
HttpClient는 요청마다 만들지 말고 서비스 수명 동안 재사용한다. 아래 HttpClient와 재시도 예제는 .NET 6 이상을 기준으로 한다. Unity의 기본 .NET Standard 2.1 프로파일에서는 ReadAsStringAsync(ct)와 Random.Shared를 그대로 사용할 수 없으므로 지원되는 오버로드와 별도 Random 인스턴스로 바꾸고 취소 처리를 보완해야 한다. WebGL은 브라우저 네트워크 제약과 CORS 정책도 별도로 검토해야 한다.
using System;
using System.Net.Http;
using System.Text;
using System.Text.Json;
using System.Threading;
using System.Threading.Tasks;

public sealed class LlmClient
{
    private static readonly HttpClient Http = new()
    {
        Timeout = TimeSpan.FromSeconds(30)
    };

    private readonly SemaphoreSlim _gate = new(initialCount: 8, maxCount: 8);

    public async Task<string> CompleteAsync(string prompt, CancellationToken ct)
    {
        await _gate.WaitAsync(ct);

        try
        {
            var payload = JsonSerializer.Serialize(new { prompt });
            using var content = new StringContent(payload, Encoding.UTF8, "application/json");
            using var response = await Http.PostAsync("https://api.example.com/v1/complete", content, ct);

            response.EnsureSuccessStatusCode();
            return await response.Content.ReadAsStringAsync(ct);
        }
        finally
        {
            _gate.Release();
        }
    }
}finally에서 _gate.Release()를 호출해야 취소, 타임아웃, HTTP 오류가 발생해도 슬롯이 반환된다. 이 한 줄이 빠지면 실패가 누적될수록 요청 큐가 영구 정지한다.
2. 모든 작업을 만들기 전에 입력 자체를 제한한다
요청 대상이 수천 개라면 Task.WhenAll(items.Select(...))로 수천 개의 Task를 한꺼번에 만드는 것도 관리 비용이 된다. 입력을 작은 배치로 나누거나 producer-consumer 구조로 흘려보낸다. 단순한 배치 처리라면 추가 라이브러리 없이 다음 코드로 충분하다.
using System.Collections.Generic;

public static async Task ProcessInBatchesAsync<T>(
    IReadOnlyList<T> items,
    int batchSize,
    Func<T, Task> process)
{
    for (var offset = 0; offset < items.Count; offset += batchSize)
    {
        var count = Math.Min(batchSize, items.Count - offset);
        var batch = new Task[count];

        for (var i = 0; i < count; i++)
            batch[i] = process(items[offset + i]);

        await Task.WhenAll(batch);
    }
}
배치 크기는 동시성 제한보다 크게 잡을 이유가 거의 없다. 위 예시에서는 batchSize를 8~16 정도로 시작하고 API의 rate limit과 실제 p95 응답 시간을 보면서 조정한다.
3. 재시도는 429와 일시적 5xx에만 지수 백오프를 적용한다
인증 실패, 잘못된 요청, 안전 필터 차단처럼 복구되지 않는 오류를 재시도하면 비용만 증가한다. 재시도 대상은 429와 일시적인 서버 오류로 좁히고 모든 요청이 동시에 재시도하지 않도록 jitter를 섞는다.
private static async Task DelayBeforeRetryAsync(int attempt, CancellationToken ct)
{
    var exponentialMs = Math.Min(8_000, 500 * (1 << attempt));
    var jitterMs = Random.Shared.Next(0, 250);
    await Task.Delay(exponentialMs + jitterMs, ct);
}
서버가 Retry-After를 제공하면 임의의 백오프보다 해당 값을 우선한다.
LLM JSON과 문자열 할당이 GC를 키우는 이유
LLM 요청은 프롬프트와 응답이 길다. 일반적인 요청 하나에서도 JSON 직렬화 문자열, StringContent용 UTF-8 바이트, 응답 문자열, 역직렬화 객체가 차례로 생길 수 있다. 요청이 동시에 몰리면 살아 있는 객체 수와 큰 객체 힙 할당 가능성이 함께 증가한다.
특히 Unity 플레이 중 메인 스레드에서 대량 응답을 문자열로 조합하거나 전체 JSON을 DOM으로 파싱하면 GC가 프레임 경계에서 눈에 띄게 발생할 수 있다. 먼저 Unity Profiler의 GC Alloc, Timeline, 네트워크 대기 시간을 같은 구간에서 확인해 원인을 분리한다. 네트워크 지연 문제를 GC 최적화로 해결할 수는 없다.
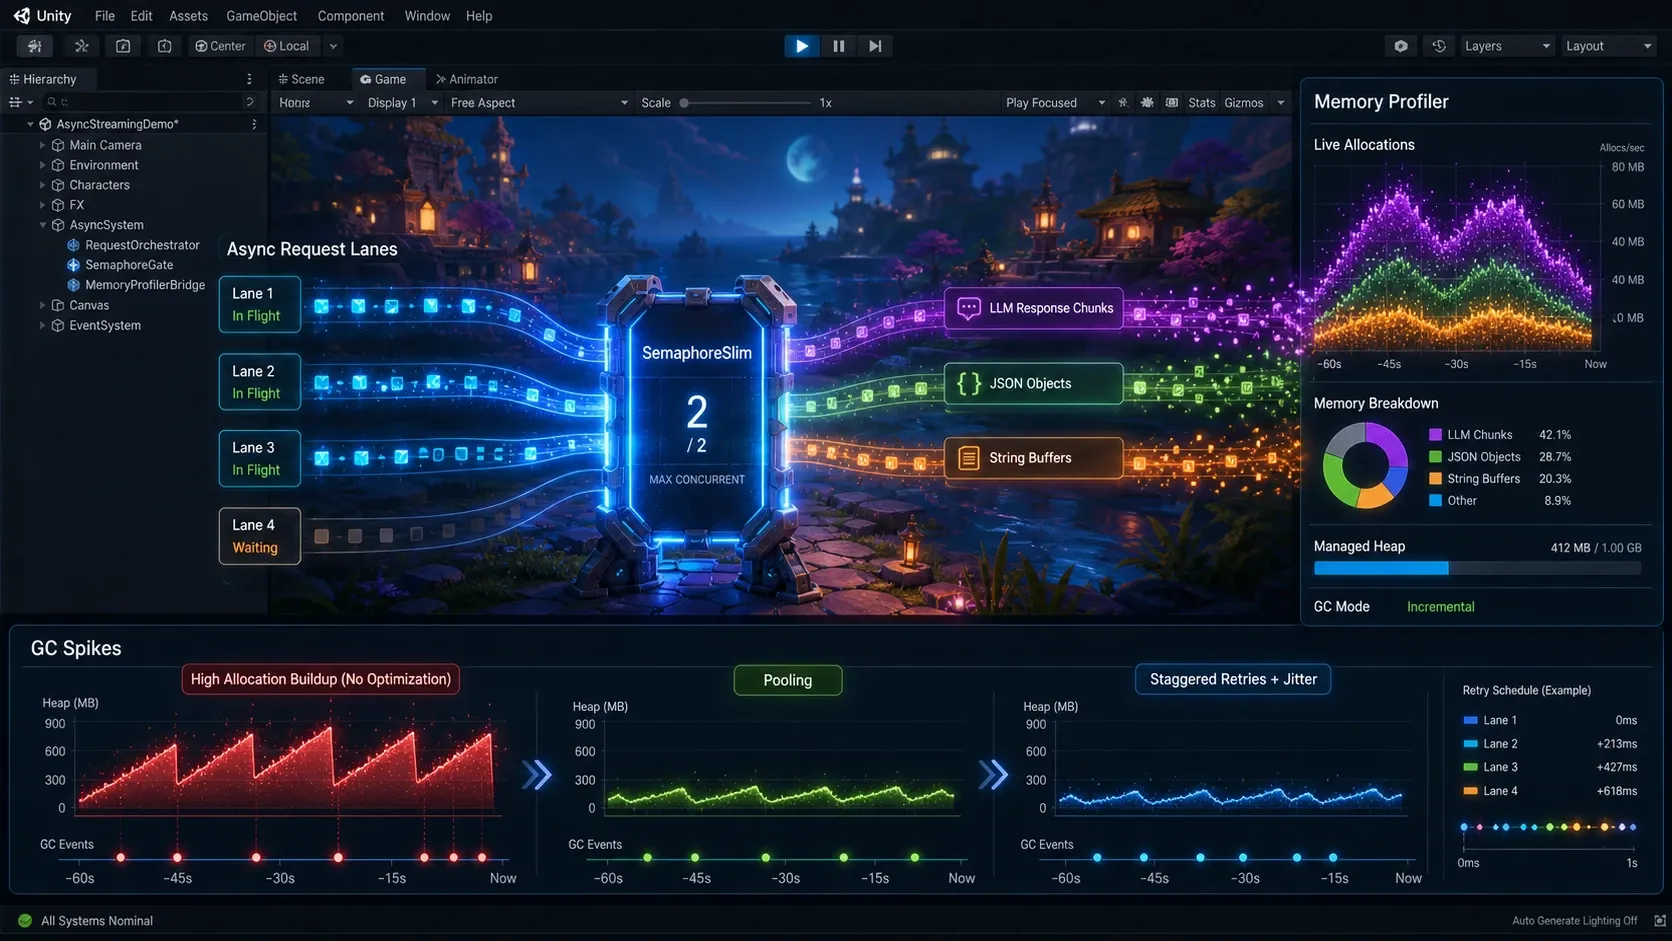
가비지 컬렉션을 줄이는 C# 구현 방법은?
전체 응답이 꼭 필요한지 먼저 결정한다
화면에 토큰이 도착하는 즉시 출력할 수 있다면 스트리밍 응답이 전체 응답 문자열을 한 번에 보관하는 방식보다 메모리 피크를 낮춘다. 반대로 결과를 JSON으로 저장하거나 안전성 검사 후 한 번에 보여줘야 한다면 스트리밍 파싱의 복잡도보다 전체 수신이 더 적절할 수 있다.
| 상황 | 권장 방식 | 이유 |
|---|---|---|
| 채팅 UI의 점진적 출력 | 스트리밍 수신 및 작은 단위 갱신 | 첫 토큰 지연과 메모리 피크를 낮춘다 |
| 짧은 분류·태그 응답 | 전체 수신 후 작은 DTO 역직렬화 | 구현이 단순하고 할당 영향이 작다 |
| 긴 문서 생성 | 스트림 처리 또는 파일 저장 | 큰 문자열의 중복 보관을 피한다 |
| 매 프레임 UI 갱신 | 누적 버퍼를 일정 주기로만 반영 | 레이아웃 재계산과 문자열 할당을 줄인다 |
JSON DOM 대신 필요한 필드만 DTO로 역직렬화한다
JsonDocument나 JObject를 매번 탐색하는 방식은 편하지만 필요한 필드가 정해져 있다면 DTO가 더 명확하다. 응답 스키마를 고정할 수 있을 때는 최소 필드만 선언한다.
public sealed class LlmResponse
{
    public string? Text { get; init; }
    public Usage? Usage { get; init; }
}

public sealed class Usage
{
    public int TotalTokens { get; init; }
}

var result = JsonSerializer.Deserialize<LlmResponse>(json);
var text = result?.Text ?? string.Empty;string.Concat, 보간 문자열, LINQ 체인이 반복되는 핫 패스도 확인한다. 다만 한 번의 네트워크 요청에서 생기는 작은 할당까지 억지로 제거할 필요는 없다. Unity Profiler 또는 .NET 프로파일러에서 GC Alloc이 실제 병목으로 확인된 구간부터 줄이는 편이 안전하다.
UI 반영 횟수를 제한한다
스트리밍 토큰마다 TMP_Text.text를 갱신하면 문자열 생성뿐 아니라 텍스트 메시 재생성과 레이아웃 비용이 더 큰 병목이 될 수 있다. 토큰은 버퍼에 누적하고 일정 시간 또는 일정 글자 수마다 화면에 반영한다.
using System.Text;

public sealed class StreamingTextBuffer
{
    private readonly StringBuilder _buffer = new();
    private int _pendingCharacters;

    public void Append(string chunk)
    {
        _buffer.Append(chunk);
        _pendingCharacters += chunk.Length;
    }

    public bool ShouldRender(float elapsedSeconds)
        => _pendingCharacters >= 32 || elapsedSeconds >= 0.05f;

    public string Flush()
    {
        _pendingCharacters = 0;
        return _buffer.ToString();
    }
}
이 코드는 매 토큰마다 UI를 바꾸는 비용을 줄인다. 다만 ToString()은 새 문자열을 만든다. 화면 갱신 주기를 제한하는 것이 목적이며 문자열 할당을 0으로 만드는 용도는 아니다.
Unity에서 메인 스레드를 안전하게 지키려면?
await 이후의 코드가 어디에서 실행되는지와 Unity API 호출 위치를 구분해야 한다. GameObject, Transform, TMP_Text 같은 Unity API는 메인 스레드에서만 다루는 것이 안전하다. 네트워크 응답 처리와 무거운 후처리는 프레임 예산을 넘기지 않게 나누고 UI 반영만 메인 스레드 경계에서 수행한다.
또한 다음 패턴은 피한다.
// 피해야 할 패턴: 메인 스레드를 막을 수 있다.
var text = client.CompleteAsync(prompt, cancellationToken).Result;
호출 경로를 끝까지 async로 유지하고 씬 전환이나 패널 닫기 시 CancellationTokenSource.Cancel()로 더 이상 필요 없는 요청을 취소한다. 취소는 이미 전송된 서버 작업을 반드시 중단시키는 약속이 아니라 클라이언트가 결과를 기다리거나 UI에 반영하는 일을 중단하는 장치라는 점도 구분해야 한다.
운영 가능한 LLM 요청 파이프라인 점검 순서
- 측정한다. 요청 수, 동시 요청 수, p50·p95 응답 시간, 429 비율, Unity GC Alloc과 프레임 시간을 같은 로그 구간에서 수집한다.
- 상한을 둔다.
SemaphoreSlim으로 동시성부터 제한하고 API의 문서화된 rate limit과 실제 p95를 기준으로 4~8부터 조정한다. - 실패를 제어한다. 취소 토큰, 타임아웃, 429·일시적 5xx 재시도,
Retry-After처리를 추가한다. - 할당이 큰 경로만 줄인다. 긴 응답은 스트리밍을 검토하고 JSON은 필요한 DTO만 역직렬화하며 UI 갱신 빈도를 낮춘다.
- 다시 측정한다. 평균 지연이 아니라 p95, 실패율, GC 스파이크, 프레임 시간을 비교해 변경 효과를 판단한다.
자주 묻는 질문 (FAQ)
Task.WhenAll은 대량 LLM 요청에 쓰면 안 되나?
아니다. 제한된 수의 작업을 기다리는 데는 적합하다. 문제는 수백·수천 개 요청을 한꺼번에 시작하는 방식이며 입력 배치와 동시성 제한을 함께 적용하면 된다.
Task.Run으로 HTTP 요청을 감싸면 더 빨라지나?
대부분 아니다. HttpClient의 비동기 I/O는 대기 중에 스레드를 붙잡지 않는다. Task.Run은 불필요한 스레드 풀 작업을 추가할 수 있으므로 CPU 연산을 분리해야 하는 경우에만 사용한다.
GC를 줄이려면 모든 문자열을 풀링해야 하나?
아니다. 우선 프로파일러에서 큰 응답, 반복 JSON 처리, 토큰별 UI 갱신처럼 실제 할당이 집중된 경로를 찾는다. 일반적인 짧은 요청까지 복잡한 풀링을 도입하면 유지보수 비용이 더 커질 수 있다.
정리
대규모 LLM API 호출의 안정성은 빠른 코드보다 제어된 동시성에서 시작한다. HttpClient 재사용, SemaphoreSlim 제한, 취소·재시도 정책, 응답 및 UI 갱신 할당 관리만 적용해도 대부분의 클라이언트 병목을 줄일 수 있다. 그 다음에만 프로파일링 결과를 근거로 스트리밍과 버퍼 최적화를 추가하자.