AI 기반 크래시 로그 분석으로 StackTrace 오류를 자동 분류하는 방법
Unity 게임의 크래시 로그와 StackTrace 정규화, 1차 군집화, AI 분류와 사람 검토를 연결하는 설계안을 설명합니다. fingerprint의 한계와 운영 지표의 계산 기준을 정리합니다.
이 설계안은 스택 정규화 → 오류 군집화 → AI 분류 → 사람이 승인하는 폐루프를 연결한다. 변동 값을 제거한 fingerprint는 1차 그룹화에 사용하고, 서로 다른 원인이 같은 그룹에 들어가거나 같은 원인이 여러 그룹으로 나뉘는지 표본을 검토한다. AI의 유형·담당 영역 제안 정확도와 처리 시간도 측정한다.
AI 기반 크래시 로그 분석은 왜 필요한가?
라이브 게임에서는 Crashlytics, Sentry, Unity Diagnostics 같은 도구로 크래시와 예외 이벤트를 수집할 수 있다. Unity Cloud Diagnostics는 사용 중단 대상으로 안내되고 있으며 Unity 6.2 이상에서는 기본 Diagnostics가 크래시·예외 보고와 디버깅 심볼 기능을 대신한다. Unity 이전 안내를 확인한다. 이벤트 수가 많다고 서로 다른 근본 원인 수도 같은 것은 아니다. NullReferenceException은 처리 방식에 따라 예외 이벤트일 수도 있으며 항상 프로세스 종료 크래시라는 뜻은 아니다.
운영팀이 필요한 것은 로그 원문 목록이 아니라 다음 질문에 대한 답이다.
- 지금 가장 많은 플레이어에게 영향을 준 크래시는 무엇인가?
- 같은 근본 원인으로 보이는 로그는 몇 건인가?
- 재현 가능성, 심각도, 담당 모듈은 무엇인가?
- 핫픽스가 필요한가, 다음 정기 패치로 처리해도 되는가?
AI는 이 판단을 최종 결정하는 도구가 아니라 사람이 읽어야 할 로그의 양을 줄이는 분류 보조 도구로 쓰는 편이 안전하다.
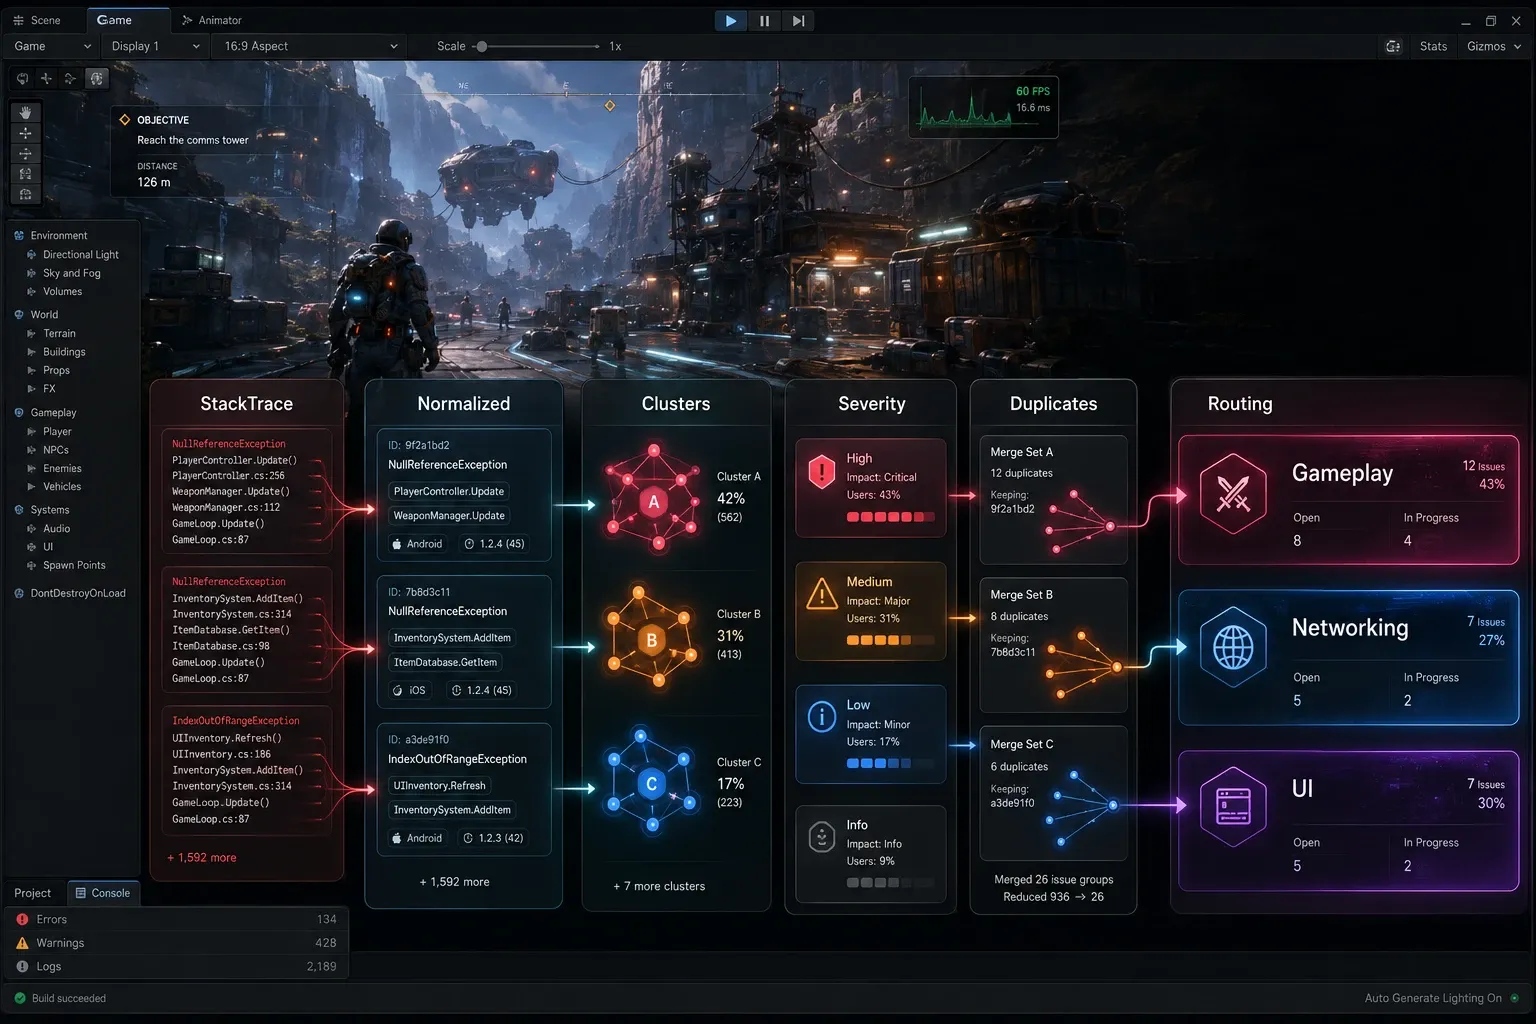
StackTrace 오류는 어떻게 정규화하고 군집화할까?
1. 수집 단계에서 최소 공통 필드를 맞춘다
수집 도구가 달라도 아래 필드는 공통 스키마로 변환할 수 있다.
| 필드 | 용도 | 예시 |
|---|---|---|
exception_type | 예외 종류 분류 | NullReferenceException |
message | 오류 메시지 비교 | Object reference not set |
stacktrace | 근본 원인 추적 | 호출 프레임 목록 |
build_version | 배포 영향 범위 확인 | 1.8.2 |
platform | 플랫폼 특이 오류 분리 | Android |
device_os | OS·기기 조건 확인 | Android 14 |
user_count | 영향 사용자 수 | 842 |
first_seen_at | 신규 회귀 판단 | ISO 8601 시간 |
이 운영안에서는 AI 입력에 이메일·채팅 내용·요청 본문·인증 토큰을 기본적으로 포함하지 않는다. 사용자별 집계가 꼭 필요하면 승인된 가명 식별자를 사용하고 원본과 연결하는 정보의 접근을 제한한다. ID를 단순 해시로 바꾼 것만으로 익명화가 완료됐다고 판단하지 않는다.
2. 변동 값이 아닌 호출 구조로 fingerprint를 만든다
주소와 라인 번호 같은 변동 값은 같은 오류를 불필요하게 분리할 수 있다. 아래 예제는 일반적인 .NET의 in 파일:line 번호와 Unity의 (at Assets/파일:번호) 위치 표기를 제거한다. 프로젝트 프레임이 없으면 전체 정규화 프레임으로 돌아가 예외 종류만으로 모든 로그를 묶지 않도록 한다. 모든 플랫폼의 스택 형식이나 메시지 속 세션 ID를 처리하는 완전한 파서는 아니므로 수집 형식별 테스트가 필요하다.
using System;
using System.Linq;
using System.Security.Cryptography;
using System.Text;
using System.Text.RegularExpressions;

public static class CrashFingerprint
{
    public static string CreateFingerprint(string exceptionType, string stackTrace)
    {
        var lines = (stackTrace ?? "").Split('\n')
            .Select(line => line.Trim()).Where(line => line.Length > 0).ToArray();
        var projectLines = lines.Where(line => line.Contains("Assets/") || line.Contains("Game.")).ToArray();
        var selected = projectLines.Length > 0 ? projectLines : lines;
        var frames = selected.Take(8).Select(NormalizeFrame);

        var source = exceptionType + "\n" + string.Join("\n", frames);
        using var sha = SHA256.Create();
        var hash = sha.ComputeHash(Encoding.UTF8.GetBytes(source));
        return BitConverter.ToString(hash).Replace("-", "").Substring(0, 16);
    }

    private static string NormalizeFrame(string line)
    {
        line = Regex.Replace(line, @"\s+\(at\s+.*:\d+\)\s*$", "");
        line = Regex.Replace(line, @"\s+in\s+.+:line\s+\d+\s*$", "");
        return Regex.Replace(line, @"0x[0-9a-fA-F]+", "").Trim();
    }
}
이 fingerprint는 SHA-256을 16자리 16진수, 즉 64비트로 잘라 사용하는 1차 그룹화 키이며 충돌 가능성이 0인 동일성 판정은 아니다. 스택이 비어 있거나 서로 다른 원인의 상위 프레임이 같으면 같은 그룹이 될 수 있으므로 메시지·빌드·원본 증거로 분리 검토한다. 심볼이 없는 네이티브 및 IL2CPP 스택에는 별도 심볼리케이션이 필요하다. Crashlytics Unity 심볼 안내를 참고한다.
3. AI에는 원문 전체보다 구조화된 요약을 전달한다
LLM 입력에는 같은 fingerprint 그룹의 대표 로그, 발생 빈도, 영향을 받은 사용자 수, 최근 배포 정보를 우선 포함한다. 아래 프롬프트는 JSON 응답을 요청하는 예시이며 그 자체로 유효한 형식을 보장하지 않는다. 응답은 파싱과 필드·열거값·범위 검증을 거친 뒤 사용하고 실패한 출력은 검토 큐로 보낸다.
{
  "fingerprint": "3B47C1A9E6D2F011",
  "exception_type": "NullReferenceException",
  "top_frames": [
    "Game.Inventory.InventoryPanel.Refresh()",
    "Game.Inventory.InventoryPresenter.OnOpen()"
  ],
  "platforms": ["Android", "iOS"],
  "affected_users": 842,
  "first_seen_build": "1.8.2"
}
다음 크래시 그룹을 분류하라.
반드시 JSON만 반환한다.
필드:
- category: null_reference | network | memory | native | data | unknown
- severity: critical | high | medium | low
- owner: client | server | qa | unknown
- confidence: 0.0~1.0
- rationale: 1문장
- next_action: 재현 또는 확인 절차 1개AI 오류 분류 결과는 어떻게 운영 의사결정에 연결할까?
분류 결과는 티켓을 자동 생성하는 근거가 아니라 트리아지 큐의 정렬 기준으로 사용한다. 예를 들어 영향도 점수는 다음처럼 단순하게 시작할 수 있다.
severityWeight는 critical=1.0, high=0.7, medium=0.4, low=0.1처럼 팀의 기준에 맞춰 둔다. 이 예제에서 affectedUsers는 기간 내 해당 그룹의 고유 영향 사용자 수, crashRate는 동일 기간 전체 세션 중 해당 그룹의 크래시가 발생한 세션의 비율이다. 영향 규모를 두 항목에 중복 반영하는 휴리스틱 점수이며 피해량이나 원인 확률의 추정치는 아니다. 집계 기간과 분모를 고정해 우선순위가 적절한지 검토한다.
flowchart LR
    A[크래시 수집] --> B[심볼리케이션·PII 제거]
    B --> C[StackTrace 정규화]
    C --> D[Fingerprint 그룹화]
    D --> E[AI 유형·심각도 분류]
    E --> F[담당자 트리아지]
    F --> G[버그 티켓·패치]
    G --> H[재발률 확인]
    H --> C
모델이 출력한 confidence는 별도 보정과 평가 없이는 정확성의 확률로 취급하지 않는다. 낮은 점수나 새 빌드의 critical 그룹을 사람 검토로 보내는 정책을 둘 수 있다. 기존 fingerprint가 일치하더라도 빌드·메시지·대표 프레임의 호환성을 확인한 뒤 기존 이슈에 연결한다.
자동 분류 정확도는 무엇으로 측정해야 할까?
정확도를 단순히 “AI가 맞혔는가”로만 측정하면 운영 품질을 설명하기 어렵다. 최소한 아래 지표를 함께 기록한다.
| 지표 | 계산 | 의미 |
|---|---|---|
| 분류 정확도 | 정답 라벨과 일치한 예측 수 / 라벨이 있는 검토 수 | 유형·담당 영역 예측 품질 |
| 그룹 순도 | 그룹별 최다 원인 라벨의 이벤트 수 합 / 전체 라벨 이벤트 수 | 원인 라벨이 있는 표본의 군집 품질 |
| 중복 티켓 감소율 | 비교 기간별 중복 티켓 비율을 구해 (이전 비율 - 이후 비율) / 이전 비율. 이전 비율이 0이면 정의하지 않음 | 운영 변화 기록. 자동화의 단독 인과 효과는 별도 검토 |
| MTTA | 이 운영 정의에서 최초 이벤트부터 담당자 확인까지 걸린 시간의 평균 | 감지·분배 속도 |
| 재발률 | 정한 관찰 기간에 같은 원인으로 재발한 수정 그룹 수 / 관찰한 수정 그룹 수. 분모 0이면 정의하지 않음 | 원본 증거로 동일 원인을 확인한 뒤 집계 |
특히 unknown 분류 비율은 숨기지 않는 편이 좋다. 새 SDK, 난독화 누락, 심볼 파일 미업로드, 로그 컨텍스트 부족 같은 운영 결함을 찾는 신호가 될 수 있다.
자주 묻는 질문 (FAQ)
AI가 크래시 원인을 확정해도 될까?
아니다. AI는 StackTrace와 메타데이터에서 가능한 원인을 요약할 뿐이다. 코드 변경과 핫픽스 결정은 재현, 최근 변경 사항, 심볼 정보 확인을 거쳐야 한다.
로그를 외부 AI 모델에 보내도 될까?
조직의 보안 정책과 계약 조건을 먼저 확인해야 한다. 기본 원칙은 PII·토큰·요청 본문 제거, 데이터 보존 기간 제한, 승인된 모델 또는 사내 배포 모델 사용이다.
작은 팀도 이 파이프라인이 필요한가?
반복 검토에 걸리는 시간과 유지 비용을 비교해 도입 여부를 정한다. 처음에는 fingerprint 생성과 기존 이슈 연결을 시험하고, 오류 분류를 추가할 필요가 있는지 측정한다.
정리
이 파이프라인의 목표는 반복 로그를 그룹화하고 영향도에 따라 검토 순서를 정하는 것이다. 정규화된 fingerprint, 출력 검증, 사람 검토, 패치 후 재발 확인을 연결한 뒤 오분류율과 트리아지 시간, 운영 비용을 비교해 적용 범위를 정한다.