AI 기반 크래시 로그 분석: StackTrace 오류 분류 자동화 파이프라인 구축법
Unity·Unreal 크래시 로그와 StackTrace를 정규화하고 해시 기반 그룹화와 AI 분류를 결합해 중복 이슈를 줄이는 자동화 파이프라인을 설계합니다. 신뢰도 기준, 재현 우선순위, 운영 지표까지 실무 절차로 정리했습니다.
크래시 로그 분석 자동화의 핵심은 원본 StackTrace를 그대로 AI에 던지는 것이 아닙니다. 먼저 빌드·플랫폼·심볼 정보를 보존한 채 정규화하고 결정론적 해시로 같은 장애를 묶은 뒤 AI가 원인 범주와 우선순위를 보조 분류하게 만들어야 합니다. 이 구조는 중복 티켓을 줄이고 QA와 개발팀이 재현·수정이 필요한 크래시에 집중하도록 돕습니다.
크래시 로그 분석 자동화에서 먼저 해결할 문제
라이브 서비스의 크래시 리포트는 보통 다음 문제를 동시에 가집니다.
- 같은 결함이 주소값, 라인 번호, 디바이스 차이 때문에 서로 다른 오류처럼 보인다.
- 심볼 업로드가 늦거나 누락되어 네이티브 호출 스택이 해석되지 않는다.
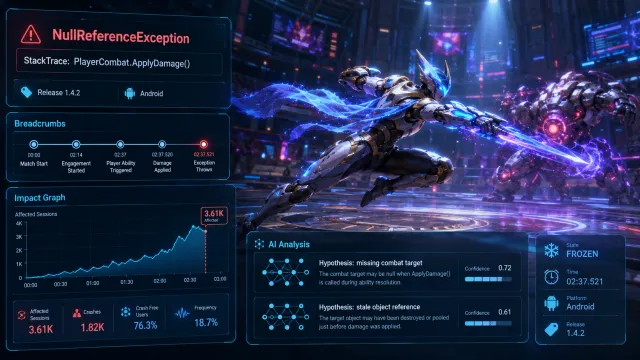
NullReferenceException처럼 흔한 예외가 서로 다른 게임 기능의 문제를 한 그룹에 섞는다.- AI 분류 결과를 그대로 신뢰하면 근거가 부족한 티켓과 잘못된 담당자 배정이 생긴다.
따라서 자동화 목표를 “AI가 버그를 고친다”가 아니라 아래처럼 좁히는 편이 안전합니다.
| 단계 | 결정 주체 | 결과물 |
|---|---|---|
| 수집 | 클라이언트·크래시 SDK | 원본 로그, 빌드 정보, 사용자 환경 |
| 정규화 | 규칙 기반 처리 | 비교 가능한 StackTrace |
| 그룹화 | 해시·유사도 알고리즘 | 크래시 시그니처와 발생 집계 |
| 분류 | AI + 규칙 | 오류 유형, 추정 소유 팀, 근거 |
| 검증·조치 | QA·개발자 | 티켓 생성, 재현, 수정, 회귀 테스트 |
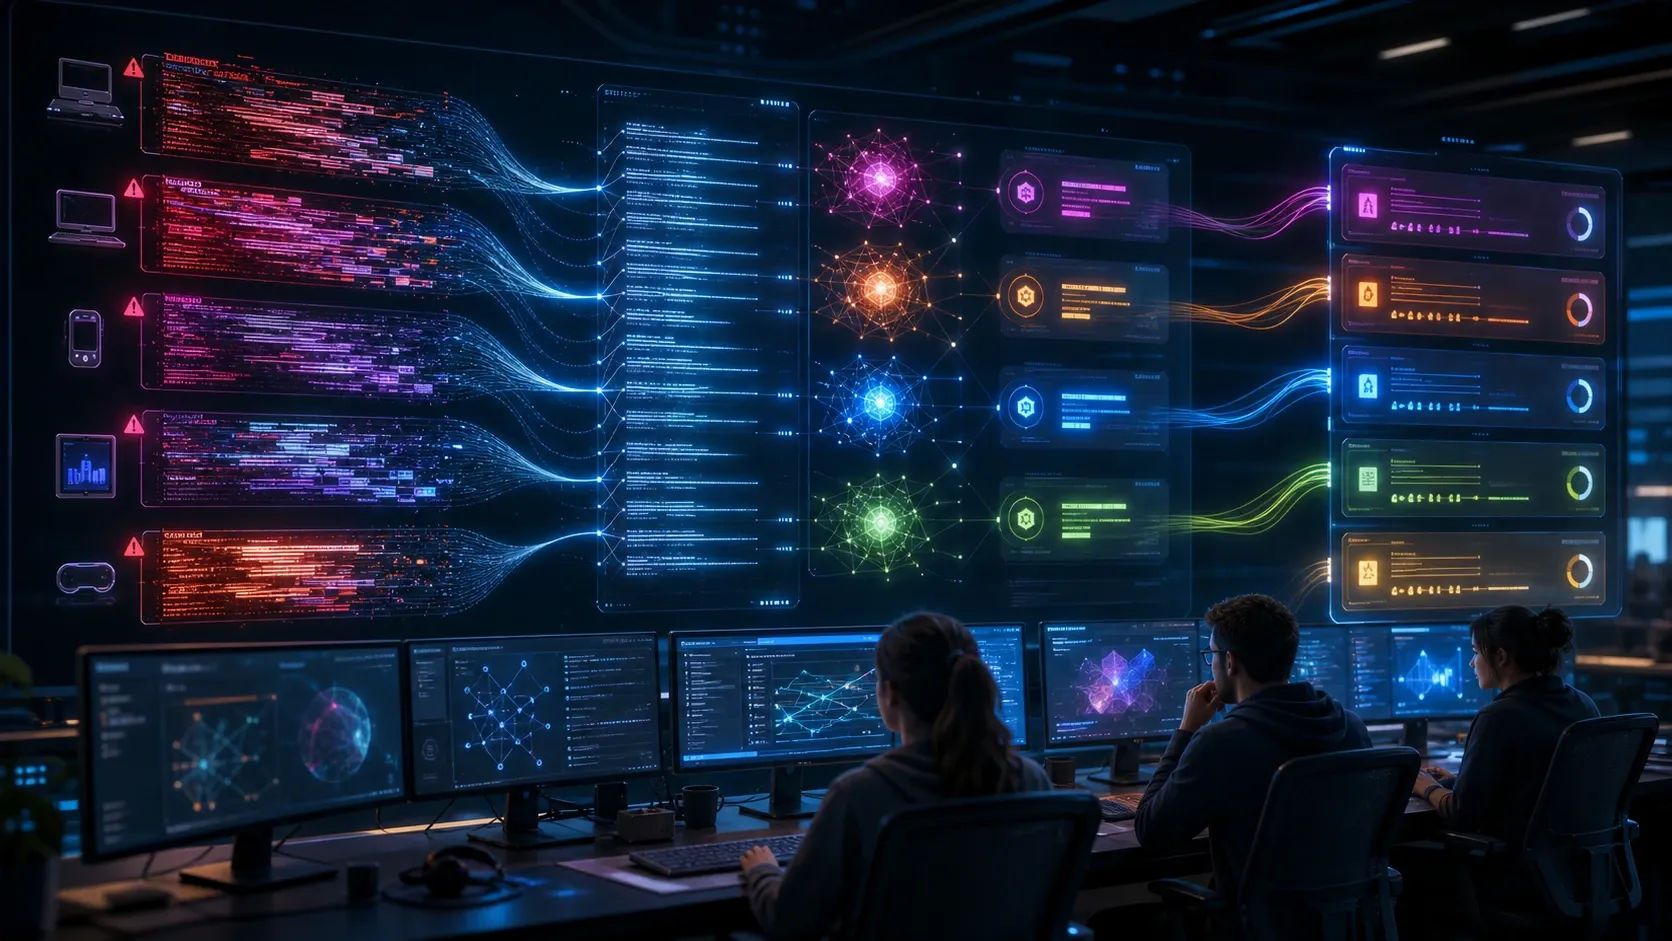
StackTrace 오류는 왜 같은 원인인데 여러 그룹으로 나뉘는가?
동일한 오류도 실행 환경에 따라 스택 표현이 달라집니다. 예를 들어 Unity IL2CPP 빌드에서는 네이티브 프레임과 주소가 앞에 붙을 수 있고 심볼 파일이 없으면 메서드명 대신 주소만 남습니다. Unreal Engine에서는 Ensure와 Fatal error의 보고 형식도 다릅니다.
특히 다음 값은 그룹 키에서 그대로 사용하면 안 됩니다.
- 메모리 주소:
0x00007FF... - 가변 라인 번호와 컬럼 번호
- 세션 ID, 사용자 ID, 요청 ID
- 타임스탬프와 프레임 번호
- 기기별 경로 또는 임시 파일 경로
반대로 예외 타입, 상위 호출 프레임, 모듈명, 빌드 버전은 보존해야 합니다. 다만 릴리스 간 코드 이동으로 라인 번호가 바뀌는 제품이라면 버전별 시그니처와 전체 기간 시그니처를 분리해 관리하는 것이 좋습니다.
스택 시그니처는 어떻게 만들까?
가장 단순하고 재현 가능한 방법은 정규화한 예외 타입과 상위 N개 프레임을 연결해 SHA-256 해시를 만드는 것입니다. N은 5~10부터 시작해 데이터로 조정합니다.
N이 너무 작으면 다른 오류가 한 그룹으로 합쳐지고 너무 크면 비본질적 프레임 차이로 그룹이 쪼개집니다. 게임의 공통 프레임워크 호출이 스택 상단을 차지한다면 해당 프레임을 제거하거나 첫 번째 프로젝트 소유 코드 프레임부터 N개를 선택합니다.
import { createHash } from "node:crypto";

type Crash = {
  exceptionType?: string;
  stackTrace: string;
};

const volatile = [
  /0x[0-9a-fA-F]+/g,
  /:\d+(?::\d+)?/g,
  /session=[^\s,]+/g,
];

function normalizeFrame(line: string) {
  return volatile
    .reduce((text, pattern) => text.replace(pattern, ""), line)
    .replace(/\s+/g, " ")
    .trim();
}

export function crashSignature(crash: Crash, frameLimit = 8) {
  const frames = crash.stackTrace
    .split("\n")
    .map(normalizeFrame)
    .filter((frame) => frame.includes("at ") || frame.includes("!"))
    .filter((frame) => !frame.includes("UnityPlayer"))
    .slice(0, frameLimit);

  const source = [crash.exceptionType ?? "Unknown", ...frames].join("\n");
  return createHash("sha256").update(source).digest("hex");
}
이 함수는 예시일 뿐입니다. 실제 운영 환경에서는 로그 포맷별 파서를 분리하고 원본 로그는 별도 보관해야 합니다. 정규화 결과만 남기면 새 규칙을 적용해 과거 데이터를 다시 그룹화할 수 없기 때문입니다.
AI 기반 StackTrace 오류 분류 자동화 파이프라인을 어떻게 구현할까?
아래 순서로 구축하면 AI의 장점은 살리면서 잘못된 자동 조치를 제한할 수 있습니다.
flowchart LR
  A[크래시 SDK 수집] --> B[원본 로그 저장]
  B --> C[심볼화·정규화]
  C --> D[시그니처 해시 그룹화]
  D --> E[규칙 기반 분류]
  E --> F[AI 보조 분류]
  F --> G{신뢰도 임계값 충족?}
  G -->|예| H[티켓 초안·담당팀 제안]
  G -->|아니오| I[QA 트리아지 대기열]
  H --> J[재현·수정·회귀 검증]
  I --> J
1. 로그 스키마를 고정한다
수집 시점에 최소한 다음 필드를 포함합니다. 개인정보나 인증 토큰은 수집 전에 마스킹합니다.
| 필드 | 용도 |
|---|---|
event_id | 개별 보고서 추적 |
occurred_at | 배포·장애 시점 상관 분석 |
app_version, git_sha | 문제 도입 빌드 확인 |
platform, os_version, device_model | 환경 편향 분석 |
exception_type, message | 1차 오류 분류 |
raw_stacktrace | 재심볼화와 감사 |
symbolicated_stacktrace | 그룹화와 분석 |
breadcrumbs | 크래시 직전 게임 상태 추론 |
session_length_sec | 신규 진입 오류와 장기 플레이 오류 구분 |
breadcrumbs에는 씬 전환, 매치메이킹 상태, 애셋 번들 로드 결과, 네트워크 오류 코드처럼 재현에 도움이 되는 이벤트를 넣습니다. 채팅 내용, 닉네임, 액세스 토큰처럼 필요하지 않은 데이터는 제외합니다.
2. 규칙 기반 분류를 AI보다 앞에 둔다
명확한 장애는 규칙으로 처리하는 편이 빠르고 일관됩니다. 예를 들어 OutOfMemoryException, Android의 SIGSEGV, iOS의 watchdog termination, Unity NullReferenceException은 정규식과 예외 타입으로 1차 라우팅할 수 있습니다.
{
  "rule_id": "unity-null-reference",
  "when": {
    "engine": "Unity 2022.3",
    "exception_type": "NullReferenceException"
  },
  "labels": ["managed-exception", "null-reference"],
  "severity_hint": "medium"
}
규칙 결과는 AI 입력에도 함께 전달합니다. 그러면 모델은 이미 확정된 사실을 다시 추측하지 않고 소유 모듈 추정이나 재현 단서 요약처럼 사람의 트리아지 시간을 줄이는 데 집중할 수 있습니다.
3. AI 출력은 반드시 구조화하고 검증한다
자유 형식 요약만 저장하면 집계와 품질 검증이 어렵습니다. 다음처럼 JSON 스키마로 제한합니다.
{
  "category": "asset-loading | memory | network | native-crash | managed-exception | unknown",
  "suspected_module": "InventoryService",
  "severity": "critical | high | medium | low",
  "confidence": 0.0,
  "evidence_frames": ["InventoryService.LoadItem"],
  "reproduction_hint": "상점 진입 후 아이템 상세를 반복해서 연다.",
  "needs_human_review": true
}
검증 규칙도 필요합니다.
evidence_frames는 실제 정규화 스택 안에 존재해야 합니다.confidence가 0.85 미만이면 자동 티켓 생성 대신 QA 검토 대기열로 보냅니다.critical은 AI 판단만으로 확정하지 않고 크래시율 또는 영향 사용자 수 기준을 함께 만족해야 합니다.- 모델이 모르는 정보는
unknown으로 답하도록 허용합니다.
크래시 우선순위는 어떤 지표로 정할까?
발생 횟수만 보면 특정 소수 사용자의 반복 크래시가 최상단에 올라갈 수 있습니다. 사용자 영향, 신규성, 재발성을 함께 고려한 점수로 정렬하는 편이 낫습니다.
각 변수는 0~1로 정규화합니다.
U: 영향을 받은 고유 사용자 비율R: 세션당 재발률 또는 사용자당 반복률N: 최근 배포 이후 신규 시그니처인지 여부S: 서비스 영향도. 결제·로그인·매치 진입 실패처럼 기능 중요도를 반영
예를 들어 전체 활성 사용자 중 2%가 로그인 직후 크래시를 겪는다면 총 이벤트 수가 적더라도 높은 우선순위를 부여해야 합니다. 반면 개발자 빌드에서만 발생하고 사용자가 1명인 오류는 별도 관찰 그룹으로 관리할 수 있습니다.
운영 품질을 확인하는 지표
자동화 파이프라인은 정확도뿐 아니라 트리아지 시간을 얼마나 줄였는지 측정해야 합니다.
| 지표 | 계산 방식 | 해석 |
|---|---|---|
| 그룹화 순도 | 표본 검수에서 동일 원인 그룹 비율 | 낮으면 정규화 또는 프레임 수 조정 필요 |
| 과분할률 | 동일 원인이 여러 시그니처로 나뉜 비율 | 높으면 주소·라인 번호 제거 규칙 점검 |
| AI 분류 정확도 | QA 확정 라벨과 일치한 비율 | 모델·프롬프트·규칙 개선 근거 |
| MTTA | 크래시 발생부터 담당자 확인까지 시간 | 트리아지 병목 측정 |
| MTTR | 확인부터 수정 배포까지 시간 | 수정·검증 프로세스 측정 |
| 크래시 없는 사용자 비율 | 크래시 미경험 사용자 / 활성 사용자 | 라이브 품질의 핵심 결과 지표 |
주기적으로 AI 결과와 QA 확정 결과를 비교해 오분류 사례를 모읍니다. 이 데이터는 프롬프트에 예시를 추가하기보다 규칙 보강, 소유 코드 맵 갱신, 라벨 정의 정리에 먼저 쓰는 편이 유지보수 비용이 낮습니다.
자주 묻는 질문 (FAQ)
AI가 StackTrace 분류를 하면 크래시 그룹화 해시는 필요 없나요?
필요합니다. 해시는 빠르고 재현 가능하며 비용이 낮은 1차 그룹화 수단입니다. AI는 해시로 묶기 어려운 의미 기반 분류와 재현 단서 요약에 사용하는 것이 적합합니다.
심볼 파일이 없는 네이티브 크래시도 분류할 수 있나요?
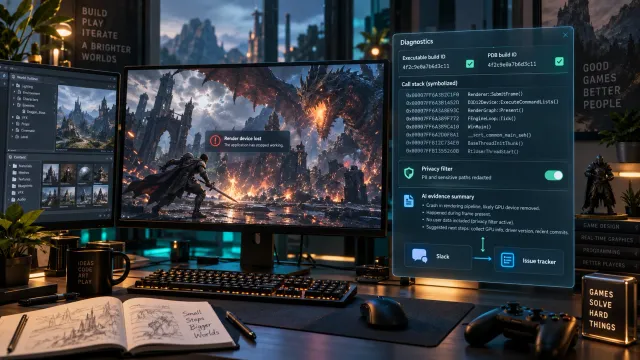
제한적으로 가능합니다. 신호 코드, 모듈명, 앱 버전, 기기 정보로 임시 그룹을 만들 수 있지만 원인 분석 품질은 낮습니다. iOS의 dSYM, Android NDK 심볼, Unity IL2CPP 심볼을 빌드 산출물과 함께 보존하고 업로드하는 절차가 우선입니다.
AI 분류 결과로 이슈를 자동 생성해도 될까요?
신뢰도와 규칙 검증을 통과한 경우에만 티켓 초안을 만들고 심각도 확정과 담당자 배정은 검토 가능하게 남기는 것이 안전합니다. 신규 시그니처와 고영향 크래시는 특히 사람의 확인이 필요합니다.
정리
AI 기반 크래시 분석은 수집, 심볼화, 정규화, 해시 그룹화, 규칙 분류, AI 보조 분류, QA 검증의 순서로 설계해야 안정적으로 운영할 수 있습니다. 원본 로그와 근거 프레임을 보존하고 자동 조치에 신뢰도 임계값을 두면 분석 속도를 높이면서도 라이브 장애 대응의 판단 책임은 팀이 유지할 수 있습니다.