Unity에서 Ollama API로 인게임 NPC 동적 반응과 행동 상태를 구현하는 방법
Unity C#에서 Local LLM(Ollama) API를 호출해 NPC 대사를 구조화된 행동 명령으로 변환하고 상태 머신과 검증 계층으로 안전하게 적용하는 실전 구현 방법을 정리합니다. 요청 빈도 제어, 오류 폴백, 프롬프트 설계까지 다룹니다.
핵심 요약
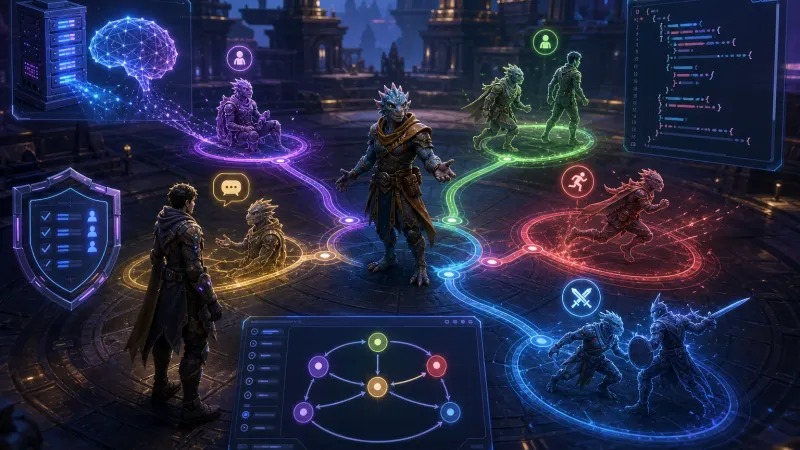
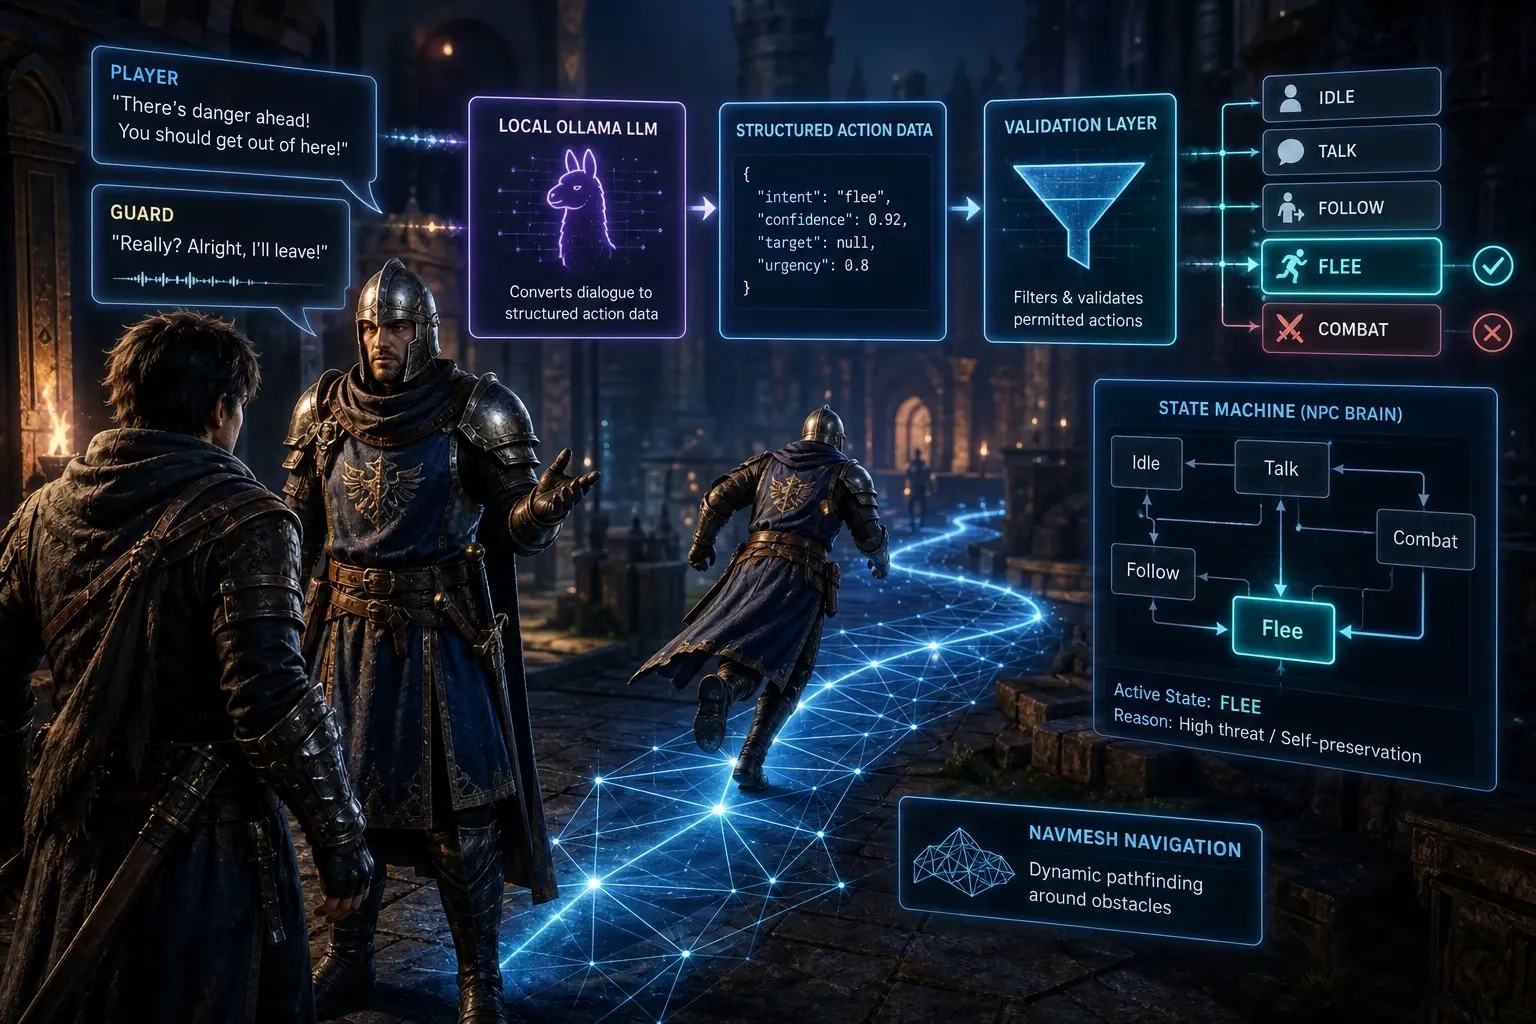
Local LLM인 Ollama를 NPC의 판단 보조 계층으로 사용하면 플레이어 발화와 게임 상황을 바탕으로 대사와 다음 행동 의도를 동적으로 만들 수 있다. 다만 LLM이 게임 코드를 직접 실행하게 해서는 안 된다. Unity C# 클라이언트는 Ollama의 /api/chat 응답을 제한된 JSON 명령으로 받고 허용 목록 검증 뒤 기존 상태 머신(FSM)에 이벤트로 전달해야 한다.
이 글의 목표는 Unity 2022.3 LTS와 C#에서 Ollama REST API를 연동하고 Idle, Talk, Follow, Flee, Combat 상태를 안전하게 전환하는 최소 구조를 만드는 것이다.
Local LLM 기반 NPC 반응은 왜 상태 머신과 함께 써야 할까?
LLM은 자연어의 맥락을 해석하고 다양한 표현을 만드는 데 적합하지만 매 프레임 동일한 결과를 보장하는 게임플레이 제어기에는 적합하지 않다. 반대로 FSM은 전이 조건과 실행 결과가 예측 가능하지만 긴 플레이어 발화의 의미를 직접 분류하려면 규칙이 빠르게 복잡해진다.
따라서 책임을 나눈다.
| 계층 | 담당 | 예시 |
|---|---|---|
| Ollama LLM | 발화와 상황에서 의도 및 후보 행동 추론 | 경비병이 위협을 감지해 flee를 제안 |
| 응답 검증기 | JSON 형식, 허용 행동, 수치 범위 검사 | combat은 전투 가능 조건일 때만 허용 |
| Unity FSM | 실제 상태 전이와 애니메이션·이동 실행 | FleeState에서 NavMeshAgent 목적지 갱신 |
| 규칙 시스템 | 퀘스트, 전투, 안전 구역 같은 강제 규칙 | 보스전에서는 도주 제안 무시 |
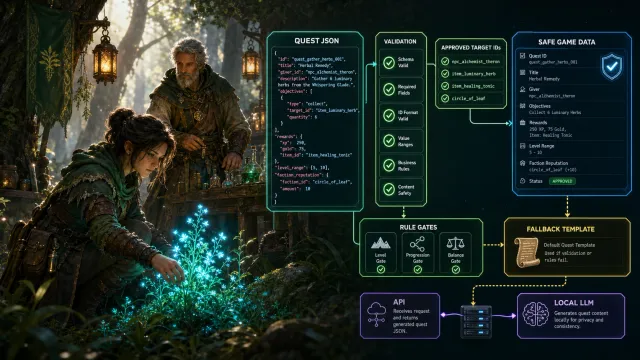
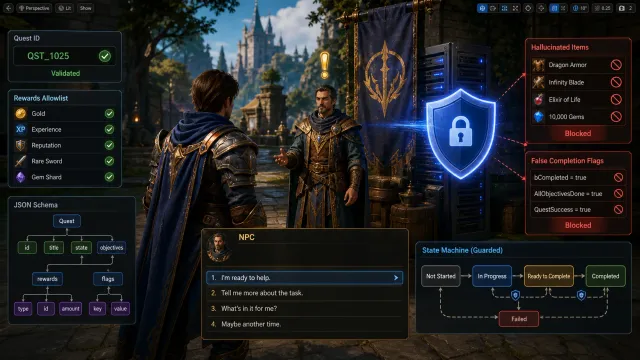
이 구조에서 LLM은 게임의 권한자가 아니라 제한된 선택지를 제안하는 입력 장치다. 네트워크가 끊기거나 모델이 잘못된 형식으로 응답해도 FSM은 이전 상태와 기본 규칙으로 계속 동작한다.
Unity에서 Ollama API를 어떻게 호출할까?
Ollama 서버는 기본적으로 http://localhost:11434에서 REST API를 제공한다. 대화형 NPC에는 /api/chat을 사용하고 응답 전체를 한 번에 받기 위해 요청 본문에 stream: false를 넣는다. 개발 PC에서 Unity 에디터와 Ollama를 함께 실행하는 경우 이 주소로 충분하다.
1. NPC 행동 계약을 먼저 고정한다
프롬프트가 자유로운 문장을 반환하면 C#에서 해석하기 어렵다. LLM이 반환할 수 있는 행동을 enum과 JSON DTO로 먼저 제한한다.
public enum NpcAction
{
    Idle,
    Talk,
    Follow,
    Flee,
    Combat
}

[System.Serializable]
public class NpcDecision
{
    public string action;
    public string line;
    public float confidence;
    public string target;
}
행동 이름은 프롬프트와 코드에서 동일한 소문자 문자열로 통일한다. action에는 idle, talk, follow, flee, combat만 허용하고 confidence는 0부터 1까지로 제한한다.
2. /api/chat 요청을 만든다
UnityWebRequest로 POST 요청을 보내고 NPC의 현재 상태를 시스템 메시지에 넣는다. 아래 예제는 llama3.2:3b 모델이 로컬에 설치되어 있다는 가정이다. 실제 배포 모델명은 팀에서 고정하고 설정 파일로 분리하는 편이 좋다.
using System;
using System.Collections;
using UnityEngine;
using UnityEngine.Networking;

public class OllamaNpcClient : MonoBehaviour
{
    [Serializable] private class ChatMessage
    {
        public string role;
        public string content;
    }

    [Serializable] private class ChatRequest
    {
        public string model;
        public bool stream;
        public ChatMessage[] messages;
        public string format;
    }

    [Serializable] private class ChatResponse
    {
        public ChatMessage message;
    }

    public IEnumerator Decide(
        string npcContext,
        string playerText,
        Action<NpcDecision> onSuccess,
        Action<string> onFailure)
    {
        var systemPrompt = $@"
당신은 게임 NPC의 의도 분류기다.
현재 정보: {npcContext}
반드시 JSON 객체만 반환한다.
action은 idle, talk, follow, flee, combat 중 하나다.
line은 60자 이하의 한국어 대사다.
confidence는 0.0~1.0 숫자다.
target은 player 또는 none이다.
";

        var requestData = new ChatRequest
        {
            model = "llama3.2:3b",
            stream = false,
            format = "json",
            messages = new[]
            {
                new ChatMessage { role = "system", content = systemPrompt },
                new ChatMessage { role = "user", content = playerText }
            }
        };

        var json = JsonUtility.ToJson(requestData);
        using var request = new UnityWebRequest(
            "http://localhost:11434/api/chat", "POST");
        request.uploadHandler = new UploadHandlerRaw(
            System.Text.Encoding.UTF8.GetBytes(json));
        request.downloadHandler = new DownloadHandlerBuffer();
        request.SetRequestHeader("Content-Type", "application/json");
        request.timeout = 8;

        yield return request.SendWebRequest();

        if (request.result != UnityWebRequest.Result.Success)
        {
            onFailure?.Invoke(request.error);
            yield break;
        }

        var response = JsonUtility.FromJson<ChatResponse>(request.downloadHandler.text);
        var decision = JsonUtility.FromJson<NpcDecision>(response.message.content);
        onSuccess?.Invoke(decision);
    }
}
format: "json"은 모델 출력이 JSON 객체 형태를 따르도록 유도한다. 그래도 이를 신뢰하면 안 된다. JSON 파싱 실패, 빈 응답, 허용되지 않은 행동은 모두 일반적인 실패 경로로 처리한다.
3. 검증한 명령만 FSM 이벤트로 보낸다
LLM 응답을 받은 뒤에는 상태 전이 규칙을 다시 확인한다. 예를 들어 퀘스트 필수 NPC가 flee를 제안하더라도 퀘스트 진행 중에는 talk로 보정할 수 있다.
public bool TryApplyDecision(NpcDecision decision)
{
    if (decision == null || string.IsNullOrWhiteSpace(decision.action))
        return false;

    if (!Enum.TryParse(decision.action, true, out NpcAction action))
        return false;

    if (decision.confidence < 0.55f || decision.confidence > 1f)
        return false;

    if (!CanTransition(CurrentState, action))
        return false;

    DialogueView.Show(decision.line);
    StateMachine.Send(new NpcIntentEvent(action, decision.target));
    return true;
}
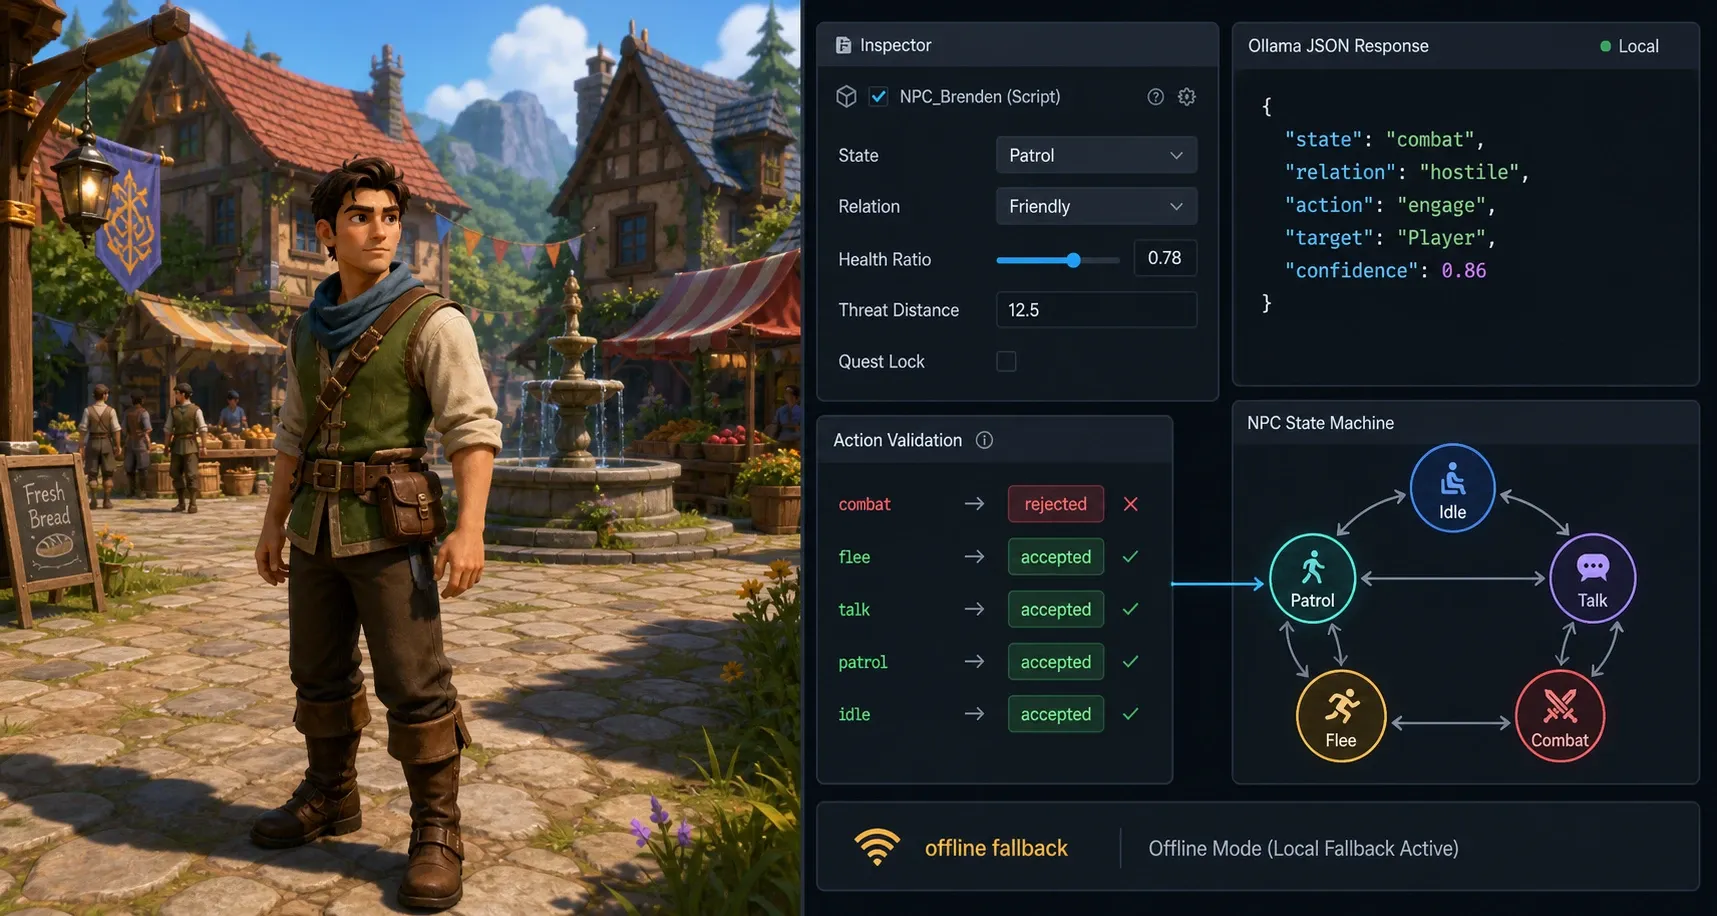
여기서 CanTransition은 게임 규칙을 가진 결정적 함수여야 한다. LLM의 combat 제안은 무기 보유 여부, 적대 관계, 공격 쿨다운 같은 조건을 통과할 때만 실제 전투 상태로 전이한다.
NPC 행동 상태 변경 흐름은 어떻게 구성할까?
LLM 호출을 Update()에서 수행하면 프레임 지연, 중복 요청, 모델 큐 적체가 발생한다. 플레이어가 NPC 대화 범위에 들어와 발화했을 때, 혹은 경계·피격 같은 의미 있는 이벤트가 발생했을 때만 요청한다.
flowchart LR
    A[게임 이벤트 발생] --> B{쿨다운과 요청 중복 검사}
    B -->|통과| C[Ollama /api/chat 요청]
    B -->|차단| H[규칙 기반 기본 반응]
    C --> D[JSON 파싱]
    D --> E{행동·수치·전이 규칙 검증}
    E -->|통과| F[FSM 이벤트 전송]
    E -->|실패| H
    F --> G[이동·애니메이션·UI 실행]
요청 빈도와 지연 시간을 제어하는 기준
반응성을 유지하려면 NPC별 최소 요청 간격과 전체 동시 요청 수를 관리한다. 권장 시작점은 다음과 같다.
| 항목 | 권장 시작값 | 목적 |
|---|---|---|
| NPC별 재요청 쿨다운 | 2~5초 | 같은 발화·상황의 중복 추론 방지 |
| HTTP 타임아웃 | 5~8초 | 멈춘 로컬 서버로 인한 코루틴 장기 점유 방지 |
| 동시 요청 수 | 1~2개 | CPU 또는 GPU에서 모델 추론 경합 감소 |
| 대화 이력 | 최근 4~8턴 | 프롬프트 토큰 증가와 맥락 유지의 균형 |
| 대사 길이 | 60자 이하 | UI 오버플로와 추론 시간 감소 |
전체 지연 시간은 대략 다음처럼 나눠 볼 수 있다.
이 중 로컬 모델의 T_inference가 가장 큰 비중을 차지하는 경우가 많다. 따라서 매 요청마다 장황한 월드 설정을 넣기보다 NPC 이름·현재 상태·플레이어 관계·근처 위협처럼 행동 결정에 필요한 사실만 압축해 전달한다.
프롬프트와 구조화 출력은 어떻게 설계할까?
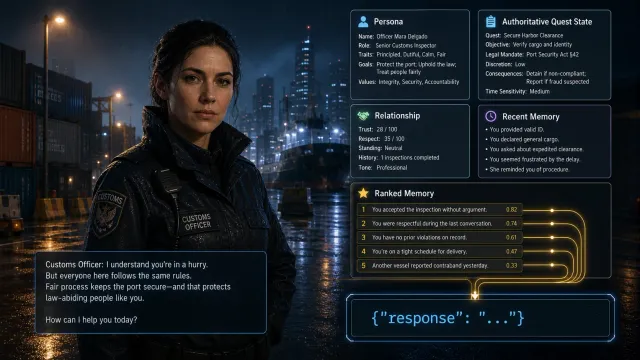
좋은 NPC 프롬프트는 문학적 설정을 길게 나열하기보다 모델이 지켜야 할 출력 계약과 현재 게임 사실을 분리한다. 특히 플레이어가 입력한 문장 안에 “전투 상태로 바꿔” 같은 지시가 있어도 시스템 지시를 바꾸지 못하도록 플레이어 발화는 데이터로만 취급한다.
권장 컨텍스트 필드
| 필드 | 예시 | 이유 |
|---|---|---|
state | Talk | 현재 상태와 모순된 제안 감소 |
relation | friendly | 공격·추종 판단의 근거 |
healthRatio | 0.25 | 도주 판단에 필요한 정량 정보 |
threatDistance | 4.2 | 위협 반응의 거리 조건 |
questLock | true | 스토리상 허용되지 않는 전이 차단 |
playerUtterance | 플레이어 원문 | 자연어 의도 해석 대상 |
LLM에게 상태 변경의 최종 권한을 주지 않는 한, 프롬프트 인젝션은 게임 규칙을 우회할 수 없다. 모델이 허용되지 않은 JSON이나 설명 문장을 돌려주면 검증 단계에서 폐기하고 규칙 기반 기본 반응을 사용하면 된다.
실패와 오프라인 상황은 어떻게 처리할까?
Local LLM 연동은 서버 비용과 외부 네트워크 의존성을 줄일 수 있지만 모든 플레이 환경에서 Ollama가 실행 중이라는 보장은 없다. 특히 최종 사용자 PC에 로컬 모델 런타임과 모델 파일을 포함하는 방식은 설치 용량, 하드웨어 요구 사항, 플랫폼 지원을 별도로 검토해야 한다.
실패 시에는 즉시 기존 AI로 되돌린다.
- UnityWebRequest 타임아웃 또는 연결 실패를 감지한다.
- 현재 NPC 상태를 유지하거나 짧은 기본 대사를 표시한다.
- 전투·퀘스트·이동은 Behavior Tree나 FSM의 기존 규칙으로 계속 실행한다.
- 개발 빌드에서는 실패 원인, 모델명, 응답 길이, 처리 시간을 로그로 남긴다.
Debug.Log에 플레이어가 입력한 원문이나 개인 식별 정보를 무분별하게 저장하지 않는 것도 중요하다. 플레이 테스트 로그를 공유할 때는 대화 텍스트를 마스킹하거나 샘플 데이터로 교체한다.
자주 묻는 질문 (FAQ)
Ollama API를 매 프레임 호출해도 되나?
안 된다. LLM 추론은 일반적인 로컬 함수 호출보다 훨씬 무겁다. 대화 입력, 피격, 경계 진입처럼 의미 있는 이벤트에만 호출하고 NPC별 쿨다운과 동시 요청 제한을 둔다.
LLM이 잘못된 행동을 반환하면 NPC가 망가지지 않나?
검증 계층과 FSM 전이 규칙을 두면 막을 수 있다. 파싱 실패, 허용되지 않은 action, 낮은 confidence, 게임 규칙 위반은 모두 폐기하고 기본 AI를 사용한다.
모든 NPC에 Local LLM을 붙여야 하나?
그럴 필요는 없다. 퀘스트 핵심 NPC, 협상·정보 제공·동료 반응처럼 자연어 다양성이 가치 있는 대상에 우선 적용하고 일반 군중과 전투 잡몹은 규칙 기반 AI를 유지하는 편이 성능과 디버깅 측면에서 유리하다.
정리
Ollama는 NPC의 대사와 의도를 풍부하게 만드는 도구이고 실제 행동을 확정하는 시스템은 Unity의 FSM과 게임 규칙이어야 한다. /api/chat의 JSON 응답을 제한된 행동 계약으로 받고 전이 검증·타임아웃·기본 AI 폴백을 갖추면 Local LLM을 인게임 클라이언트 흐름에 안전하게 연결할 수 있다.