Unity C# Job System과 NativeArray로 대규모 N-Body 충돌 최적화하기
Unity C# Job System, Burst, NativeArray를 활용해 대규모 N-Body 충돌의 병목을 분석하고 공간 해싱 기반 브로드페이즈와 병렬 계산으로 프레임 시간을 줄이는 구현 방법을 정리합니다.
핵심 요약
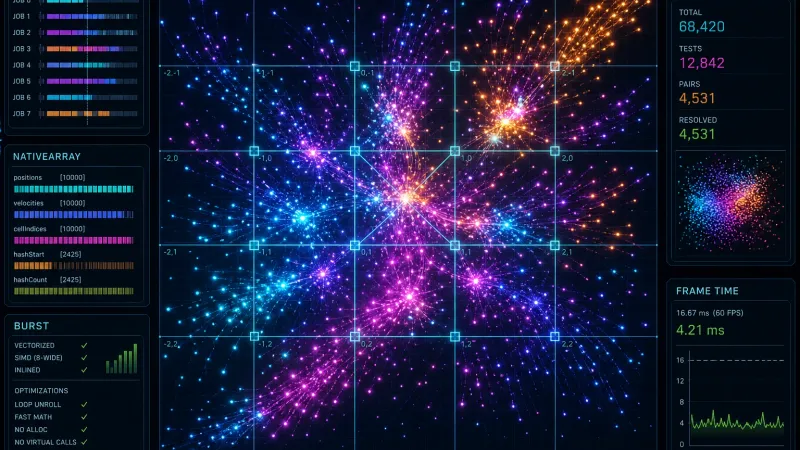
Unity에서 대규모 N-Body 충돌이 느려지는 핵심 원인은 모든 객체 쌍을 비교하는 비용과 메인 스레드에서 수행되는 반복 계산이다. IJobParallelFor, NativeArray<T>, Burst Compiler로 독립적인 계산을 병렬화하고 충돌 후보는 균일 격자 기반 공간 해싱으로 제한하면 실제 충돌 판정량을 크게 줄일 수 있다.
Unity N-Body 충돌은 왜 느려지는가?
N개의 원형 파티클이 서로 충돌할 수 있다고 가정하자. 단순 구현은 각 파티클이 나머지 모든 파티클과 거리를 비교한다.
파티클이 1,000개면 비교 쌍은 499,500개다. 10,000개에서는 약 5,000만 쌍이 된다. 각 쌍에서 거리 계산, 반지름 비교, 충돌 응답까지 수행하면 Update() 한 번만으로도 프레임 예산을 쉽게 넘긴다.
| 문제 | 단순 구현 | 최적화 방향 |
|---|---|---|
| 후보 탐색 | 모든 쌍 비교, | 공간 해싱으로 이웃 셀만 검사 |
| 연산 위치 | 메인 스레드 Update() | C# Job System으로 워커 스레드 병렬화 |
| 데이터 배치 | List<GameObject>, Transform 접근 | 연속 메모리의 NativeArray<T> |
| 수치 연산 | 일반 C# 실행 | Burst Compiler와 Unity.Mathematics |
| 충돌 반영 | 여러 Job이 같은 위치를 쓰기 쉬움 | 계산과 적용 단계를 분리 |
여기서 중요한 점은 Job System이 알고리즘을 자동으로 선형 시간으로 바꾸지 않는다는 것이다. 먼저 충돌 후보 수를 줄이고 남은 독립 계산을 병렬화해야 한다.
NativeArray와 Burst는 어떤 역할을 하는가?
NativeArray<T>는 Unity Job System이 안전하게 전달할 수 있는 네이티브 컨테이너다. 파티클의 위치와 속도를 Transform이나 클래스로 흩어 두는 대신, float2 배열처럼 연속된 데이터로 관리한다.
using Unity.Burst;
using Unity.Collections;
using Unity.Jobs;
using Unity.Mathematics;

[BurstCompile]
public struct IntegrateJob : IJobParallelFor
{
    public float DeltaTime;
    public float Damping;

    public NativeArray<float2> Positions;
    public NativeArray<float2> Velocities;

    public void Execute(int index)
    {
        float2 velocity = Velocities[index] * Damping;
        Positions[index] += velocity * DeltaTime;
        Velocities[index] = velocity;
    }
}
이 Job은 인덱스별로 다른 Positions[index], Velocities[index]만 갱신한다. 따라서 각 반복이 독립적이며 IJobParallelFor에 적합하다. [BurstCompile]은 Unity.Mathematics의 float2, math.lengthsq 같은 수치 연산을 네이티브 코드로 최적화할 수 있게 한다.
대규모 충돌을 어떻게 구현할까? 3단계 파이프라인
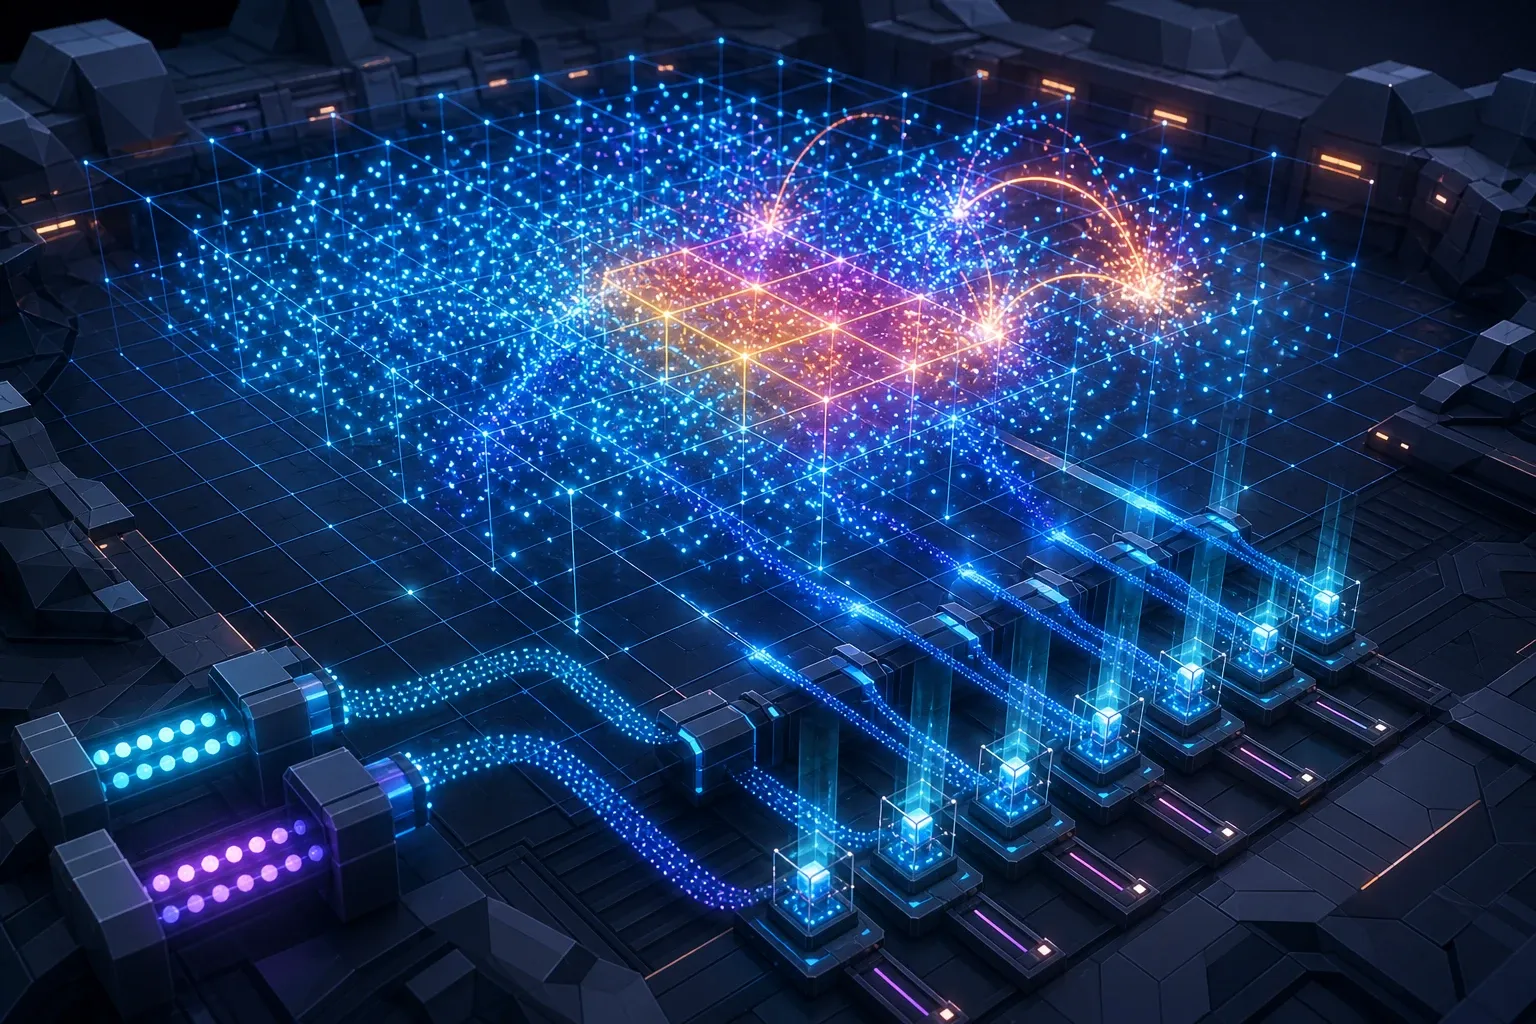
1. 파티클 상태를 SoA 형태의 NativeArray로 준비한다
관리 객체를 매 프레임 생성하거나 Transform.position을 Job 안에서 직접 읽지 않는다. 위치, 속도, 반지름처럼 자주 읽는 값을 NativeArray에 보관한다.
private NativeArray<float2> positions;
private NativeArray<float2> velocities;
private NativeArray<float> radii;

void OnEnable()
{
    positions = new NativeArray<float2>(particleCount, Allocator.Persistent);
    velocities = new NativeArray<float2>(particleCount, Allocator.Persistent);
    radii = new NativeArray<float>(particleCount, Allocator.Persistent);
}

void OnDisable()
{
    if (positions.IsCreated) positions.Dispose();
    if (velocities.IsCreated) velocities.Dispose();
    if (radii.IsCreated) radii.Dispose();
}Allocator.Persistent로 만든 컨테이너는 여러 프레임에 걸쳐 사용할 수 있다. 반드시 OnDisable() 또는 OnDestroy()에서 Dispose()해야 하며 아직 실행 중인 Job이 참조하는 배열을 먼저 해제하면 안 된다.
2. 공간 해싱으로 충돌 후보를 인접 셀로 제한한다
균일 격자의 셀 크기는 일반적으로 최대 충돌 지름 이상으로 잡는다. 반지름이 모두 같다면 cellSize = radius * 2f가 시작점이 될 수 있다. 좌표를 셀 좌표로 변환한 뒤 같은 셀 또는 주변 8개 셀의 파티클만 후보로 검사한다.
2D에서는 NativeParallelMultiHashMap<int, int>에 cellKey → particleIndex를 저장하는 방식이 실용적이다. 해시 키는 셀 좌표를 정수 키로 변환해 만든다.
[BurstCompile]
public struct BuildGridJob : IJobParallelFor
{
    [ReadOnly] public NativeArray<float2> Positions;
    public float CellSize;
    public NativeParallelMultiHashMap<int, int>.ParallelWriter Grid;

    public void Execute(int index)
    {
        int2 cell = (int2)math.floor(Positions[index] / CellSize);
        int key = cell.x * 73856093 ^ cell.y * 19349663;
        Grid.Add(key, index);
    }
}
해시 충돌 자체는 NativeParallelMultiHashMap이 처리하지만 서로 다른 셀이 같은 정수 키를 만들 가능성은 완전히 제거되지 않는다. 정확성이 절대적으로 중요하다면 값으로 셀 좌표도 함께 저장해 조회 후 확인하거나 프로젝트의 좌표 범위에 맞는 충돌 없는 키 인코딩을 사용한다.
3. 충돌 계산과 위치 반영을 분리한다
두 파티클의 거리를 비교하는 조건은 다음과 같다.
한 Job이 충돌을 발견할 때 즉시 두 파티클의 위치를 수정하면 여러 스레드가 동일한 인덱스에 동시에 쓸 수 있다. 예를 들어 파티클 B가 A, C와 각각 충돌하면 두 작업이 Positions[B]를 경쟁적으로 갱신한다.
가장 단순한 해법은 파티클별 보정값을 별도 배열에 기록하는 것이다. 각 Execute(index)는 자기 인덱스의 보정값만 쓰고 다음 Job이 그 값을 위치에 적용한다.
[BurstCompile]
public struct ApplyCorrectionJob : IJobParallelFor
{
    public NativeArray<float2> Positions;
    [ReadOnly] public NativeArray<float2> Corrections;

    public void Execute(int index)
    {
        Positions[index] += Corrections[index];
    }
}
충돌 쌍마다 양쪽 입자에 보정을 누적해야 한다면 NativeStream으로 쌍별 결과를 기록한 후 단일 소비 단계에서 합산하거나 원자적 누적이 가능한 데이터 표현을 별도로 설계해야 한다. 먼저 정확성과 단순성을 위해 한쪽 기준 보정 또는 고정 횟수의 반복 해법을 선택하고 프로파일링 결과가 필요할 때만 더 복잡한 축소 단계를 도입하는 편이 안전하다.
JobHandle 의존성은 어떻게 연결해야 할까?
그리드 생성이 끝나기 전에 충돌 탐색 Job이 실행되면 아직 작성되지 않은 셀을 읽을 수 있다. JobHandle로 데이터 의존성을 명시적으로 연결한다.
NativeParallelMultiHashMap<int, int> grid =
    new NativeParallelMultiHashMap<int, int>(particleCount * 2, Allocator.TempJob);

grid.Clear();

var buildGridJob = new BuildGridJob
{
    Positions = positions,
    CellSize = cellSize,
    Grid = grid.AsParallelWriter()
};

JobHandle gridHandle = buildGridJob.Schedule(particleCount, 64);

// 프로젝트별 구현이 필요한 자리: grid/positions를 조회해 corrections를 채웁니다.
JobHandle collisionHandle = ScheduleCollisionSearch(
    grid, positions, corrections, particleCount, gridHandle);

var applyJob = new ApplyCorrectionJob
{
    Positions = positions,
    Corrections = corrections
};

JobHandle applyHandle = applyJob.Schedule(particleCount, 64, collisionHandle);
applyHandle.Complete();
grid.Dispose();Complete()는 결과가 실제로 필요해지는 시점까지 미루는 것이 좋다. 예를 들어 렌더링을 위해 메인 스레드에서 위치를 읽기 직전에 완료하면 그 사이 메인 스레드는 입력 처리나 다른 시스템을 수행할 수 있다. 다만 grid처럼 Allocator.TempJob으로 생성한 컨테이너는 Job 완료 후 해제해야 한다.
배치 크기와 데이터 구조는 어떻게 정할까?
Schedule(count, batchSize)의 batchSize는 작업 분배 단위다. 정답은 기기와 연산량에 따라 달라지지만 처음에는 32~128 범위에서 측정하는 것이 좋다. 파티클 하나당 작업량이 매우 작으면 너무 작은 배치는 스케줄링 비용을 키우고 너무 큰 배치는 코어 간 작업 분배를 불균형하게 만든다.
| 항목 | 권장 시작점 | 확인할 점 |
|---|---|---|
IJobParallelFor 배치 크기 | 64 | CPU 코어 수와 파티클당 연산량 |
| 셀 크기 | 최대 충돌 지름 | 한 셀에 너무 많은 파티클이 몰리는지 |
| 그리드 용량 | 파티클 수의 1~2배 | 추가 할당과 해시 충돌 빈도 |
| 충돌 반복 횟수 | 1~4회 | 안정성, 관통, 프레임 예산 |
| 동기화 시점 | 렌더 직전 | 불필요한 조기 Complete() 여부 |
공간 해싱은 객체가 균일하게 분포할 때 특히 효과적이다. 모든 파티클이 하나의 셀에 몰리는 상황에서는 다시 많은 후보를 비교하게 된다. 군집이 잦은 게임이라면 셀 크기, 최대 셀 점유 수, 계층형 그리드나 쿼드트리 도입 여부를 프로파일러 데이터로 판단해야 한다.
Unity Profiler에서 무엇을 검증해야 하는가?
최적화 전후에는 FPS만 보지 말고 병목 위치를 비교한다.
- CPU Usage 모듈에서 메인 스레드의 충돌 루프 시간이 줄었는지 확인한다.
- Timeline 뷰에서 Worker Thread에 Job이 실제로 분산되었는지 확인한다.
- Profile Analyzer로 다수 프레임의 중앙값과 상위 프레임 시간을 비교한다.
- Memory 모듈에서 매 프레임
NativeArray또는 해시 맵을 생성해 GC와 네이티브 할당이 늘지 않는지 확인한다. - 에디터 수치만 믿지 말고 목표 플랫폼의 Development Build에서 Burst 활성화 상태로 다시 측정한다.
에디터에서 Transform 동기화, 안전 검사, 프로파일러 오버헤드가 결과에 영향을 줄 수 있다. 또한 Burst가 실제로 활성화됐는지 Unity 메뉴의 Burst 설정과 빌드 로그를 함께 확인해야 한다.
자주 묻는 질문 (FAQ)
Job System만 적용하면 N-Body 충돌이 충분히 빨라지나?
아니다. Job System은 계산을 여러 코어에 분산하지만 모든 쌍을 검사하는 비용은 남는다. 대규모 객체에서는 공간 해싱 같은 브로드페이즈로 후보 수를 먼저 줄여야 한다.
NativeArray를 매 프레임 새로 만들어도 되나?
가능하지만 권장하지 않는다. 크기가 고정되거나 드물게 변한다면 Allocator.Persistent 배열을 재사용해 할당과 해제 비용을 줄인다. 임시 데이터는 Allocator.TempJob을 쓰되 Job 완료 후 즉시 해제한다.
충돌 Job 안에서 Transform을 수정해도 되나?
일반적인 Transform 직접 접근은 Job과 Burst에 적합하지 않다. 위치는 NativeArray<float2> 또는 NativeArray<float3>에서 계산하고 완료 후 메인 스레드나 TransformAccessArray 기반 Job에서 시각 객체에 반영한다.
정리
Unity C# Job System과 NativeArray는 대규모 파티클 계산을 병렬화하는 기반이다. 하지만 성능 개선의 순서는 명확하다. 먼저 공간 해싱으로 충돌 후보를 줄이고 그 다음 데이터 지향 배열과 Burst Job으로 계산을 분산하며 마지막으로 JobHandle과 별도 보정 배열로 쓰기 경쟁을 제거한다. 이 세 단계를 분리해 프로파일링하면 파티클 수 증가에 따른 병목을 더 예측 가능하게 관리할 수 있다.