C# Job System과 Burst Compiler로 대규모 병렬 연산 처리하기
Unity의 C# Job System과 Burst Compiler를 함께 사용해 CPU 집약적인 게임 연산을 병렬화하는 방법을 정리합니다. 데이터 배치, 안전한 메모리 접근, 의존성 연결, 프로파일링 기준까지 실전 관점에서 살펴봅니다.
왜 Job System이 필요한가
적 AI의 거리 계산, 군중 이동, 탄환 궤적 갱신처럼 같은 형태의 계산을 많은 대상에 반복하면 메인 스레드가 빠르게 포화된다. Update()에서 foreach나 for 루프로 수만 건을 처리하는 방식은 구현은 단순하지만 프레임 시간에 직접 영향을 준다.
Unity의 C# Job System은 작업을 여러 워커 스레드에 나누어 실행할 수 있게 한다. Burst Compiler는 그 작업 코드를 네이티브 코드로 컴파일하고 SIMD 같은 CPU 최적화를 적용한다. 둘을 함께 쓰면 CPU 집약적이고 데이터 독립적인 반복 연산에서 특히 큰 효과를 기대할 수 있다.
다만 모든 코드를 Job으로 옮기는 것이 답은 아니다. 작업을 예약하고 동기화하는 비용도 있으므로 대상 수가 적거나 Unity API 호출이 중심인 로직은 오히려 복잡도만 커질 수 있다.
처리 구조 이해하기
Job은 메인 스레드에서 즉시 실행되지 않는다. 먼저 필요한 데이터를 준비하고 Job을 예약한 뒤 Unity가 적절한 워커 스레드에서 실행한다. 결과가 필요한 시점에는 Complete()로 완료를 보장해야 한다.
flowchart LR
    A[메인 스레드에서 데이터 준비] --> B[Job 예약]
    B --> C[워커 스레드에서 병렬 실행]
    C --> D[JobHandle로 의존성 연결]
    D --> E[필요한 시점에 Complete]
    E --> F[결과를 게임 로직과 렌더링에 반영]
중요한 점은 Schedule() 직후에 결과를 읽지 않는 것이다. Job이 아직 실행 중일 수 있기 때문이다. 반대로 예약한 직후 바로 Complete()를 호출하면 병렬 실행의 이점을 상당 부분 잃는다. 결과가 실제로 필요해지는 지점까지 완료를 늦추는 편이 좋다.
예제: 대량 위치에 대한 거리 제곱 계산
거리 비교만 필요하다면 Vector3.Distance로 제곱근을 구할 필요가 없다. 거리 제곱을 비교하면 더 적은 연산으로 같은 판정을 할 수 있다.
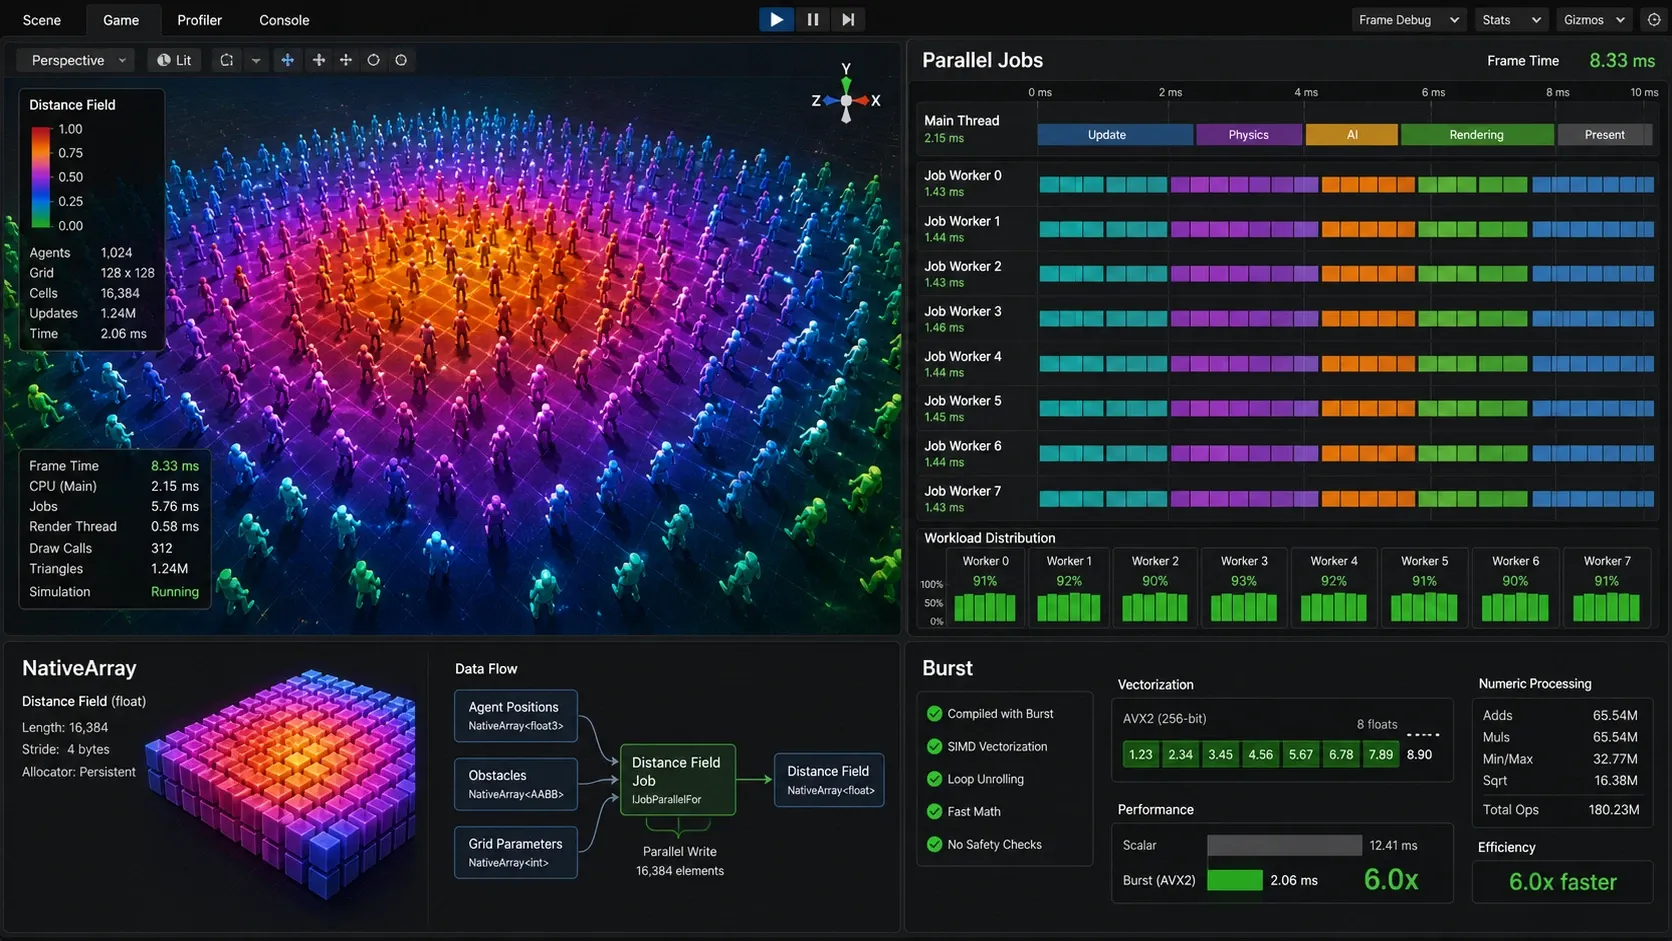
아래 Job은 여러 위치와 기준점 사이의 거리 제곱을 계산한다. NativeArray는 Job이 안전하게 접근할 수 있는 네이티브 메모리 컨테이너다.
using Unity.Burst;
using Unity.Collections;
using Unity.Jobs;
using Unity.Mathematics;

[BurstCompile]
public struct DistanceSquaredJob : IJobParallelFor
{
    [ReadOnly] public NativeArray<float3> Positions;
    public float3 Origin;
    [WriteOnly] public NativeArray<float> DistancesSquared;

    public void Execute(int index)
    {
        float3 offset = Positions[index] - Origin;
        DistancesSquared[index] = math.lengthsq(offset);
    }
}IJobParallelFor는 인덱스별 연산이 서로 독립적일 때 적합하다. 각 Execute() 호출은 자기 인덱스의 입력을 읽고 자기 인덱스의 출력만 기록하므로 병렬화하기 쉽다.
using Unity.Collections;
using Unity.Jobs;
using Unity.Mathematics;
using UnityEngine;

public class DistanceJobExample : MonoBehaviour
{
    [SerializeField] private Transform origin;

    private NativeArray<float3> positions;
    private NativeArray<float> distancesSquared;
    private JobHandle distanceHandle;

    private void Start()
    {
        positions = new NativeArray<float3>(10_000, Allocator.Persistent);
        distancesSquared = new NativeArray<float>(10_000, Allocator.Persistent);

        for (int i = 0; i < positions.Length; i++)
        {
            positions[i] = new float3(i % 100, 0f, i / 100);
        }
    }

    private void Update()
    {
        var job = new DistanceSquaredJob
        {
            Positions = positions,
            Origin = origin.position,
            DistancesSquared = distancesSquared
        };

        distanceHandle = job.Schedule(positions.Length, 64);
    }

    private void LateUpdate()
    {
        distanceHandle.Complete();

        float detectionRadius = 10f;
        float detectionRadiusSquared = detectionRadius * detectionRadius;

        for (int i = 0; i < distancesSquared.Length; i++)
        {
            if (distancesSquared[i] <= detectionRadiusSquared)
            {
                // 범위 안에 있는 대상 처리
            }
        }
    }

    private void OnDestroy()
    {
        distanceHandle.Complete();

        if (positions.IsCreated)
        {
            positions.Dispose();
        }

        if (distancesSquared.IsCreated)
        {
            distancesSquared.Dispose();
        }
    }
}
두 번째 인수 64는 배치 크기다. Unity는 전체 인덱스 범위를 이 크기의 작업 묶음으로 나눈다. 절대적인 최적값은 없으며 대상 수, 연산량, CPU 코어 수에 따라 달라진다. 작은 값부터 측정해 프로젝트에 맞는 값을 찾는 것이 안전하다.
Burst가 잘 최적화하는 코드 형태
Burst는 관리형 C# 런타임에 의존하지 않는 단순한 수치 연산에서 강점을 보인다. Unity.Mathematics의 float3, math.dot, math.lengthsq 같은 타입과 함수를 사용하면 Burst 친화적인 코드를 작성하기 좋다.
다음 요소는 Job과 Burst 코드에서 피해야 하거나 별도 설계가 필요하다.
GameObject,Transform,MonoBehaviour같은 UnityEngine 객체 직접 접근string, 클래스 인스턴스, 일반 배열처럼 관리형 메모리에 의존하는 데이터- Job 실행 중의
Debug.Log - 여러 인덱스가 같은 메모리 위치를 동시에 수정하는 구조
예를 들어 Transform 위치를 Job 안에서 읽으려 하기보다 메인 스레드에서 위치를 NativeArray<float3>에 복사한 뒤 Job에 전달한다. 계산 결과도 배열에 기록하고 완료 후 메인 스레드에서 Transform이나 렌더링 상태에 반영한다.
의존성이 있는 Job 연결하기
실제 게임에서는 한 Job의 출력이 다음 Job의 입력이 되는 경우가 많다. 이때 중간 단계마다 Complete()를 호출할 필요가 없다. JobHandle을 다음 Job의 의존성으로 넘기면 Unity가 올바른 순서로 실행한다.
JobHandle distanceHandle = distanceJob.Schedule(count, 64);
JobHandle filterHandle = filterJob.Schedule(count, 64, distanceHandle);

filterHandle.Complete();
이 방식은 메인 스레드의 대기 시간을 줄이고 워커 스레드가 작업을 이어서 처리할 기회를 만든다. 다만 마지막 결과를 사용하기 전에는 최종 JobHandle을 완료해야 한다.
메모리 수명과 안전 규칙
NativeArray를 Allocator.Persistent로 만들었다면 더 이상 사용하지 않을 때 반드시 Dispose()해야 한다. Job이 해당 배열을 사용 중인 상태에서 해제하면 안 되므로 해제 전에 관련 JobHandle을 완료한다.
매 프레임 생성과 해제를 반복하는 것도 피하는 편이 좋다. 대량 데이터용 컨테이너는 필요한 최대 용량을 고려해 재사용하고 대상 수가 변한다면 필요한 시점에만 크기를 조정한다.
Job System의 안전 검사는 읽기와 쓰기 충돌을 찾아내는 데 도움을 준다. 오류를 억지로 우회하는 속성보다 데이터 흐름을 분리하는 설계를 우선해야 한다. 입력 배열은 읽기 전용으로 선언하고 각 Job이 자신의 출력 배열을 갖도록 만들면 문제를 줄일 수 있다.
성능을 확인하는 방법
최적화는 수치가 아니라 측정으로 판단해야 한다. Unity Profiler에서 Main Thread뿐 아니라 Job Worker 스레드의 사용량, 스케줄링 비용, 동기화 지점을 함께 확인한다.
다음 기준으로 전후를 비교해 보자.
- 같은 장면과 같은 대상 수에서 평균 프레임 시간
- 메인 스레드의 CPU 시간 감소 여부
- Job Worker가 실제로 계산을 나누어 처리하는지 여부
Complete()에서 기다리는 시간이 과도하지 않은지 여부- Native 컨테이너 생성과 해제로 인한 할당이 반복되지 않는지 여부
대상 수가 작으면 일반 루프가 더 빠를 수 있다. 반대로 독립적인 수치 연산이 수천 건 이상 반복되고 메인 스레드가 병목이라면 Job System과 Burst는 유효한 선택지가 된다.
정리
C# Job System은 일을 여러 스레드에 분배하는 도구이고 Burst Compiler는 그 계산 코드를 더 효율적인 네이티브 코드로 바꾸는 도구다. 효과를 얻으려면 먼저 데이터를 연속적인 네이티브 컨테이너로 준비하고 인덱스별로 독립적인 연산을 만들며 필요한 순간까지 완료를 미뤄야 한다.
가장 좋은 출발점은 병목이 확인된 반복 계산 하나를 고르는 것이다. 프로파일러로 기준 성능을 기록한 다음 IJobParallelFor와 Burst를 적용하고 결과가 좋아졌는지 다시 측정하자.