파밍 메커니즘: 의도적인 드롭률 조작(PRD) 알고리즘
PRD(Pseudo-Random Distribution)는 실패가 이어질수록 다음 성공 확률을 높여 긴 불운을 줄이는 드롭 시스템이다. 단순 확률, 누적 확률, 보정 상수 설계와 Unity 구현 방법을 함께 정리한다.
PRD가 필요한 이유
몬스터 처치마다 10% 확률로 희귀 아이템을 떨어뜨린다고 해 보자. 각 시도가 독립이라면 평균적으로는 열 번 중 한 번 성공한다. 하지만 실제 플레이에서는 열 번 연속 실패하거나 반대로 짧은 시간에 여러 번 성공할 수 있다. 평균값이 맞더라도 플레이어는 이 결과를 불공정하게 느끼기 쉽다.
PRD(Pseudo-Random Distribution)는 성공하지 못한 횟수에 비례해 다음 시도의 성공 확률을 올리는 방식이다. 성공하면 보정은 초기화된다. 즉, 장기적인 기대값을 유지하면서도 극단적인 연속 실패를 줄이는 데 목적이 있다.
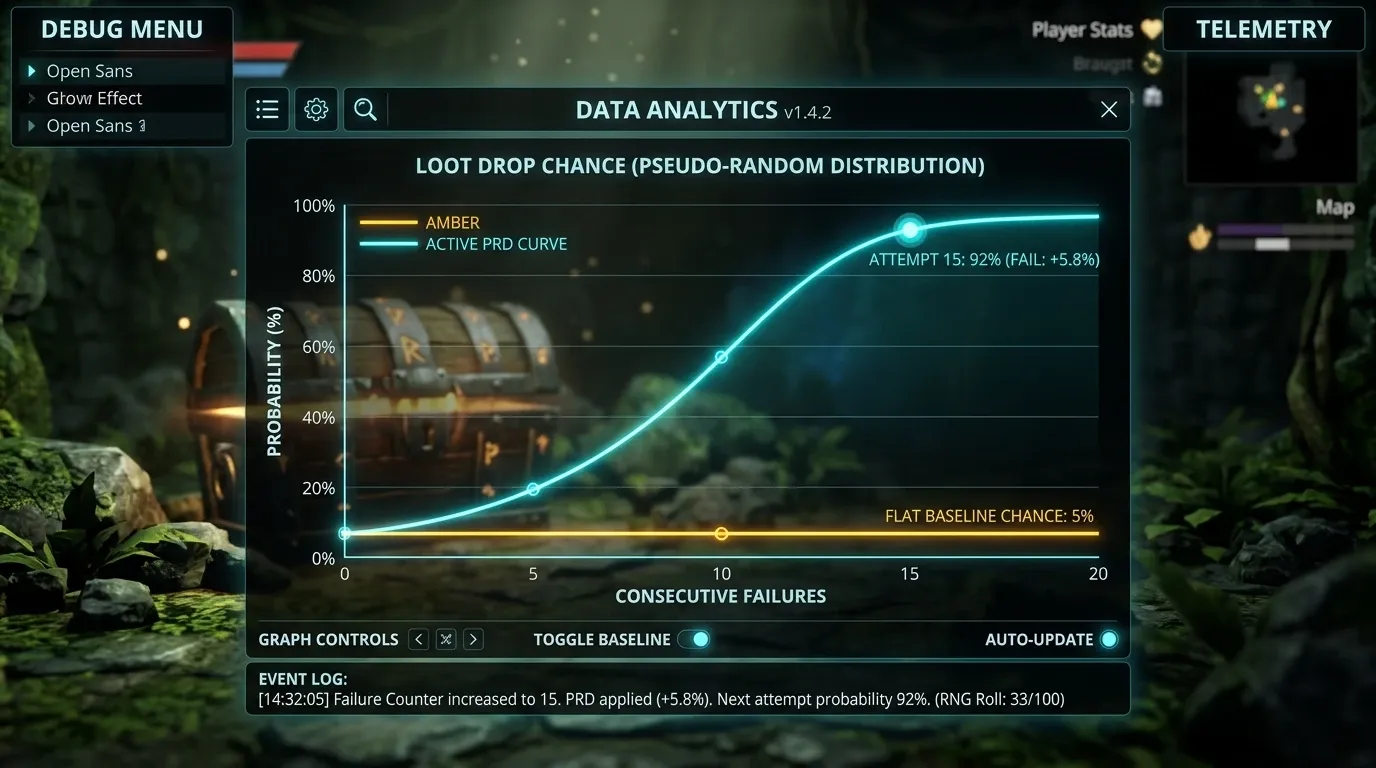
독립 시행과 PRD의 차이
독립 시행에서 기본 드롭률을 라고 하면 각 시도의 성공 확률은 언제나 같다.
반면 가장 널리 알려진 PRD 형태는 보정 상수 와 현재 연속 실패 횟수 을 사용한다. 이번 시도의 확률은 다음과 같이 계산한다.
여기서 은 보통 첫 시도에서 1로 시작한다. 첫 시도에 실패하면 다음 시도는 , 다시 실패하면 가 된다. 성공한 순간 연속 실패 횟수를 0으로 되돌린다.
flowchart TD
    A[드롭 시도 시작] --> B[연속 실패 횟수 증가]
    B --> C[확률 = min 1, 실패 횟수 × c]
    C --> D{난수 < 확률?}
    D -->|성공| E[아이템 지급]
    E --> F[연속 실패 횟수 초기화]
    D -->|실패| G[실패 횟수 유지]
    F --> H[다음 드롭 시도]
    G --> H
이 방식은 단순히 실패 횟수를 보고 보상을 보장하는 천장 시스템과는 다르다. PRD는 매번 난수를 굴리지만 충분히 많은 실패 뒤에는 확률이 100%에 도달할 수 있다. 따라서 보장 횟수가 명확해야 하는 가챠나 핵심 퀘스트 보상에는 별도의 천장 규칙을 함께 두는 편이 안전하다.
목표 드롭률과 보정 상수의 관계
중요한 점은 가 목표 평균 드롭률과 같지 않다는 것이다. 예를 들어 목표 평균이 20%라고 해서 를 쓰면 실제 평균 성공률은 20%보다 높아진다. 실패할수록 확률이 올라가기 때문이다.
시도 에서 처음 성공할 확률은 이전 시도 전체가 실패하고 이번 시도에서 성공할 확률이다.
성공까지 필요한 기대 시도 횟수는 다음과 같다.
장기 평균 드롭률은 대략 가 된다. 따라서 원하는 평균 드롭률을 먼저 정하고 이를 만족하는 를 수치적으로 찾아야 한다. 대표적인 방법은 이분 탐색이다.
보정 상수를 오프라인에서 찾기
아래 코드는 목표 평균 드롭률에 맞는 를 계산한다. 이 계산은 밸런싱 도구나 에디터에서 한 번 수행한 뒤 결과를 데이터로 저장하는 용도에 적합하다.
using System;

public static class PrdTuning
{
    public static double FindCoefficient(double targetDropRate)
    {
        if (targetDropRate <= 0.0 || targetDropRate >= 1.0)
            throw new ArgumentOutOfRangeException(nameof(targetDropRate));

        double low = 0.0;
        double high = targetDropRate;

        for (int iteration = 0; iteration < 80; iteration++)
        {
            double candidate = (low + high) * 0.5;
            double actualRate = CalculateAverageDropRate(candidate);

            if (actualRate < targetDropRate)
                low = candidate;
            else
                high = candidate;
        }

        return (low + high) * 0.5;
    }

    public static double CalculateAverageDropRate(double coefficient)
    {
        double survivalProbability = 1.0;
        double expectedAttempts = 0.0;
        int maxAttempts = (int)Math.Ceiling(1.0 / coefficient);

        for (int attempt = 1; attempt <= maxAttempts; attempt++)
        {
            double chance = Math.Min(1.0, attempt * coefficient);
            double firstSuccessProbability = survivalProbability * chance;

            expectedAttempts += attempt * firstSuccessProbability;
            survivalProbability *= 1.0 - chance;
        }

        return 1.0 / expectedAttempts;
    }
}targetDropRate가 0.2일 때 반환되는 값은 0.2보다 작은 수다. 반환값 자체를 기획 문서의 드롭률로 노출하지 말고 내부 보정 상수라는 이름으로 관리하는 것이 혼동을 줄인다.
Unity에서 상태를 갖는 PRD 구현
PRD는 드롭 테이블의 정적 데이터만으로 끝나지 않는다. 누가 어떤 보상에서 몇 번 실패했는지 저장해야 한다. 몬스터 공통 드롭인지 계정 단위의 희귀 재료인지 캐릭터별 보상인지에 따라 실패 카운터의 소유 범위를 먼저 결정해야 한다.
using System;
using System.Collections.Generic;
using UnityEngine;

[Serializable]
public class PrdDropState
{
    [SerializeField] private int consecutiveFailures;

    public int ConsecutiveFailures => consecutiveFailures;

    public bool Roll(float coefficient)
    {
        if (coefficient <= 0f || coefficient > 1f)
            throw new ArgumentOutOfRangeException(nameof(coefficient));

        consecutiveFailures++;
        float chance = Mathf.Min(1f, consecutiveFailures * coefficient);

        if (chance >= 1f || UnityEngine.Random.value < chance)
        {
            consecutiveFailures = 0;
            return true;
        }

        return false;
    }
}

public class LootPrdService
{
    private readonly Dictionary<string, PrdDropState> states = new();

    public bool TryDrop(string dropKey, float coefficient)
    {
        if (!states.TryGetValue(dropKey, out PrdDropState state))
        {
            state = new PrdDropState();
            states.Add(dropKey, state);
        }

        return state.Roll(coefficient);
    }
}dropKey는 예를 들어 playerId:rare_ore처럼 보상 종류와 적용 범위를 함께 표현할 수 있다. 서버 권한 게임이라면 consecutiveFailures를 클라이언트에만 저장하면 안 된다. 저장 파일 조작이나 패킷 재전송으로 보정을 악용할 수 있으므로 난수 생성과 상태 갱신을 서버에서 처리해야 한다.
설계할 때 결정할 것
실패 카운터를 공유할 범위
같은 희귀 광석을 어떤 몬스터에게서 잡아도 같은 카운터를 쌓게 할지, 몬스터 종류마다 따로 쌓게 할지에 따라 체감이 달라진다. 보상이 부족하게 느껴지는 문제를 해결하려는 목적이라면 보상 아이템 단위로 공유하는 편이 일반적으로 더 직관적이다. 반대로 특정 보스의 파밍 가치를 유지해야 한다면 보스별 상태가 더 적합할 수 있다.
최대 확률과 보장 여부
기본 PRD는 가 1에 도달하면 성공을 보장한다. 최대 시도 횟수를 더 길게 유지하고 싶다면 확률 상한을 1보다 낮게 설정할 수 있다. 다만 이 경우 연속 실패가 이론적으로 무한히 이어질 수 있다. 핵심 진행 아이템에는 명시적 천장 규칙을 추가하는 편이 낫다.
float chance = Mathf.Min(maxChance, failures * coefficient);

if (failures >= guaranteedAttempt)
{
    chance = 1f;
}
여러 희귀 보상이 한 번에 굴러갈 때
독립된 PRD를 여러 보상에 각각 적용하면 한 처치에서 여러 희귀 아이템이 동시에 나올 수 있다. 이것이 의도한 결과가 아니라면 먼저 희귀 보상 슬롯의 당첨 여부를 정하고 당첨된 뒤에 가중치 테이블로 아이템 하나를 선택한다. PRD는 어떤 단계의 불운을 완화할지 명확히 정한 뒤 적용해야 한다.
검증 방법
PRD는 평균만 보면 놓치는 문제가 많다. 최소한 다음 지표를 시뮬레이션으로 확인하는 것이 좋다.
- 장기 평균 드롭률이 목표값과 충분히 가까운지
- 성공까지 필요한 시도 횟수의 평균과 중앙값
- 90퍼센타일, 99퍼센타일의 최대 실패 구간
- 한 세션 안에서 보상 획득이 지나치게 몰리는지
- 저장과 재접속 뒤에도 실패 카운터가 정확히 유지되는지
public static int SimulateAttempts(float coefficient, System.Random random)
{
    int failures = 0;

    while (true)
    {
        failures++;
        float chance = Mathf.Min(1f, failures * coefficient);

        if (random.NextDouble() < chance)
            return failures;
    }
}
시뮬레이션에는 UnityEngine.Random보다 시드를 고정할 수 있는 System.Random이 편리하다. 같은 입력에서 같은 결과를 재현할 수 있으므로 보정 상수를 바꿨을 때 분포가 어떻게 달라졌는지 비교하기 쉽다.
마무리
PRD는 확률을 속이는 장치가 아니라 평균 드롭률은 유지하면서 플레이어가 겪는 불운의 길이를 제어하는 분포 설계다. 목표 드롭률을 그대로 보정 상수로 사용하지 말고 기대 시도 횟수로 실제 평균을 검증해야 한다. 또한 실패 카운터의 저장 범위와 보장 규칙을 게임의 경제 및 진행 설계와 함께 결정해야 예측 가능한 파밍 경험을 만들 수 있다.