ML-Agents로 근접·원거리 보스 패턴 학습시키기
Unity ML-Agents에서 보스 AI를 에이전트로 구성하고 근접 공격과 원거리 투사체 패턴을 강화학습으로 선택하게 만드는 방법을 정리한다. 관측, 행동, 보상 설계와 학습 후 검증 시 주의할 점을 실용적인 예제로 설명한다.
목표와 범위
여기서는 ‘유무선’을 보스의 근접 공격과 원거리 공격을 함께 운용하는 패턴으로 해석한다. 보스가 플레이어와의 거리, 체력, 공격 재사용 대기시간, 최근 피격 여부를 관측한 뒤 이동·근접 공격·원거리 공격을 선택하도록 만드는 것이 목표다.
강화학습이 모든 보스 AI의 정답은 아니다. 연출 순서가 엄격한 레이드 보스나 반드시 재현되어야 하는 컷신 전투에는 상태 머신이 더 적합하다. 반면 플레이어의 위치 변화에 반응하는 보조 패턴, 난이도별 행동 비중 조절, 여러 행동 후보 중 상황에 맞는 선택을 실험할 때 ML-Agents가 유용하다.
학습 환경을 작게 시작하기
처음부터 실제 보스 전투를 그대로 학습 환경에 넣으면 원인 분석이 어려워진다. 평평한 경기장, 플레이어 대역, 보스 대역, 두 종류의 공격만 있는 작은 장면부터 만든다.
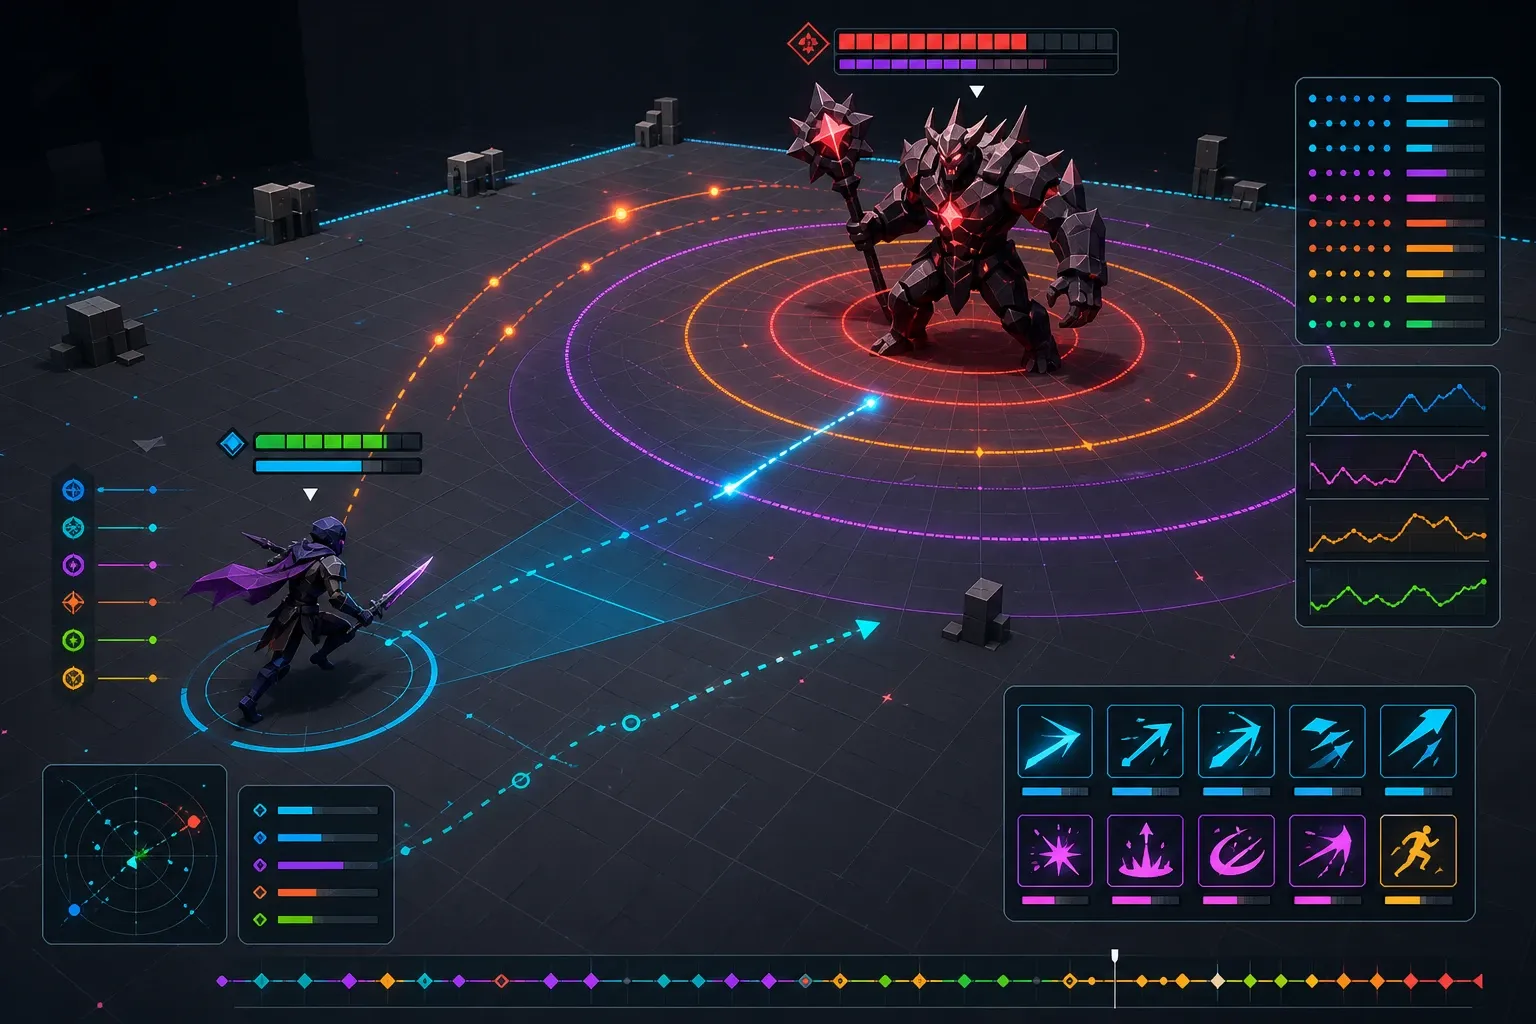
플레이어 대역은 처음에는 단순한 규칙으로 움직여도 된다. 예를 들어 일정 거리 안에서는 옆으로 이동하고 멀어지면 보스 쪽으로 접근하게 만든다. 학습이 안정된 뒤 실제 입력을 받는 플레이어 컨트롤러나 다양한 회피 정책으로 바꾼다.
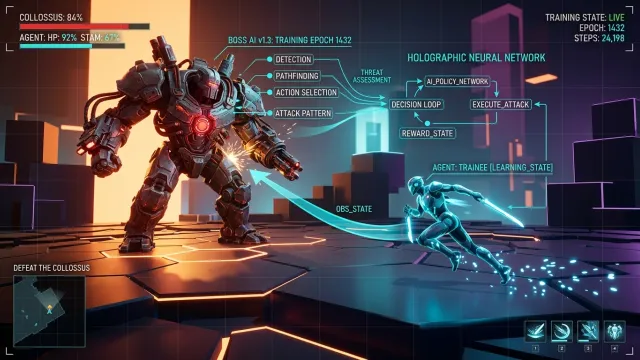
flowchart LR
    O[관측 수집] --> P[정책 신경망]
    P --> A[이동·근접·원거리 행동]
    A --> S[전투 상태 갱신]
    S --> R[보상 계산]
    R --> O
이 순환에서 중요한 점은 정책이 직접 ‘패턴 이름’을 고르는 것이 아니라는 점이다. 정책은 매 결정마다 연속 이동값과 공격 선택값을 출력하고 보스 컨트롤러가 쿨다운과 사거리 같은 게임 규칙을 적용한다.
관측 설계
관측에는 보스가 실제로 판단에 사용할 수 있는 정보만 넣는다. 월드 좌표를 그대로 넣기보다 보스 기준의 상대 좌표를 정규화하면 학습이 쉬워진다.
권장 관측 예시는 다음과 같다.
- 플레이어의 상대 위치와 상대 속도
- 보스와 플레이어의 현재 체력 비율
- 보스의 이동 속도와 바라보는 방향
- 근접 공격 및 원거리 공격의 쿨다운 비율
- 플레이어가 근접 사거리 또는 원거리 유효 사거리에 있는지 여부
- 최근 일정 시간 동안 공격을 맞혔는지 또는 피격됐는지 나타내는 짧은 상태값
관측값의 범위를 가능한 한 비슷하게 맞춘다. 예를 들어 거리는 최대 감지 거리로 나누고 쿨다운은 0에서 1 사이 값으로 전달한다.
public override void CollectObservations(VectorSensor sensor)
{
    Vector3 toPlayer = player.position - transform.position;
    Vector3 localDirection = transform.InverseTransformDirection(toPlayer.normalized);

    sensor.AddObservation(localDirection);
    sensor.AddObservation(Mathf.Clamp01(toPlayer.magnitude / maxObserveDistance));
    sensor.AddObservation(playerVelocity / maxPlayerSpeed);
    sensor.AddObservation(currentHealth / maxHealth);
    sensor.AddObservation(playerHealth / playerMaxHealth);
    sensor.AddObservation(Mathf.Clamp01(meleeCooldown / meleeCooldownMax));
    sensor.AddObservation(Mathf.Clamp01(rangedCooldown / rangedCooldownMax));
    sensor.AddObservation(IsInMeleeRange() ? 1f : 0f);
    sensor.AddObservation(IsInRangedRange() ? 1f : 0f);
}
시야 가림, 벽, 낙차가 전투의 핵심이라면 RayPerceptionSensor3D 같은 센서를 추가할 수 있다. 다만 처음부터 많은 레이를 넣기보다 상대 위치 기반 환경에서 보상과 행동이 정상 동작하는지 먼저 확인하는 편이 낫다.
행동 공간 구성
연속 행동 두 개로 이동 방향을 받고 이산 행동 하나로 공격 종류를 선택하는 구성이 이해하기 쉽다.
- 연속 행동 0, 1: 좌우 이동과 전후 이동
- 이산 행동 0: 공격 없음
- 이산 행동 1: 근접 공격 시도
- 이산 행동 2: 원거리 공격 시도
Behavior Parameters에서는 연속 행동 크기를 2로 두고 이산 브랜치 하나의 크기를 3으로 설정한다. 공격의 성공 여부와 쿨다운 검사는 C# 코드에서 처리한다. 정책이 쿨다운 중인 공격을 선택했다고 즉시 예외 처리하지 말고 공격하지 못한 상태로 넘어가게 해야 학습 과정에서 불필요한 행동의 가치를 낮출 수 있다.
public override void OnActionReceived(ActionBuffers actions)
{
    Vector2 moveInput = new(
        actions.ContinuousActions[0],
        actions.ContinuousActions[1]);
    Move(moveInput.normalized);

    int attack = actions.DiscreteActions[0];
    switch (attack)
    {
        case 1 when meleeCooldown <= 0f && IsInMeleeRange():
            StartMeleeAttack();
            break;
        case 2 when rangedCooldown <= 0f && IsInRangedRange():
            FireProjectile();
            break;
    }
}
공격 애니메이션이 길다면 매 프레임 의사 결정을 받지 않도록 한다. 공격 중에는 결정 요청을 멈추거나 행동 마스크로 사용할 수 없는 공격을 제한한다. 그렇지 않으면 정책이 애니메이션 중에도 공격 명령을 반복하며 학습 신호를 흐릴 수 있다.
보상은 전투 의도에 맞춰 설계한다
보상은 ‘플레이어를 쓰러뜨린다’는 최종 목표만으로 시작하면 너무 희소할 수 있다. 그러나 중간 보상을 과도하게 주면 보스가 전투보다 보상 수집에 유리한 행동만 반복한다. 작은 단계부터 검증할 수 있게 보상을 분리한다.
예를 들어 한 스텝의 보상을 아래처럼 구성할 수 있다.
r_damage: 플레이어에게 실제 피해를 줬을 때의 양의 보상r_pressure: 적정 거리에서 공격 기회를 만든 행동에 대한 작은 보상r_invalid: 사거리 밖 또는 쿨다운 중 공격을 시도했을 때의 작은 패널티r_stall: 장시간 아무 행동 없이 멀리 도망가는 정책을 막는 시간 패널티
보스가 입힌 피해와 받은 피해를 비율로 환산하면 체력이 다른 캐릭터에도 보상 크기를 비교적 일관되게 유지할 수 있다.
public void OnDamageDealt(float damage)
{
    AddReward(0.8f * damage / playerMaxHealth);
}

public void OnDamageTaken(float damage)
{
    AddReward(-0.5f * damage / maxHealth);
}

private void FixedUpdate()
{
    AddReward(-0.0005f); // 지나친 지연 방지
}

public void OnInvalidAttackAttempt()
{
    AddReward(-0.01f);
}
플레이어 처치와 보스 처치에는 명확한 종료 보상을 준다. 한쪽이 쓰러지거나 제한 시간이 지나면 에피소드를 종료하고 양쪽의 위치·체력·쿨다운을 초기화한다.
public void EndBattle(bool bossWon)
{
    AddReward(bossWon ? 1f : -1f);
    EndEpisode();
}
커리큘럼과 무작위화
보스가 한 종류의 플레이어 대역만 상대하면 그 움직임에만 과적합될 수 있다. 다음 순서처럼 난이도를 점진적으로 올린다.
- 플레이어가 거의 움직이지 않는 환경에서 사거리와 공격 선택을 학습한다.
- 플레이어가 일정한 속도로 회피하도록 만든다.
- 시작 거리, 체력, 쿨다운, 플레이어의 회피 방향을 무작위화한다.
- 실제 플레이어 조작 또는 서로 다른 규칙 기반 대역을 상대로 평가한다.
처음부터 모든 변수를 무작위화하면 정책이 배워야 할 규칙을 찾기 어렵다. 반대로 너무 고정된 환경만 사용하면 실제 전투에서 성능이 급격히 떨어진다. 학습 성공률이 안정된 뒤 한 번에 한 요소씩 변동 범위를 넓히는 방식이 원인 파악에 유리하다.
학습과 검증 체크리스트
PPO를 기본 선택으로 두고 결정 주기와 시간 배율은 장면의 물리 안정성을 해치지 않는 범위에서 조절한다. 학습 로그에서는 누적 보상만 보지 말고 아래 지표를 함께 기록한다.
- 근접 공격과 원거리 공격의 선택 비율
- 유효 타격률과 무효 공격 시도 횟수
- 평균 전투 시간
- 플레이어 대역 종류별 승률
- 보스가 특정 위치나 행동만 반복하는지 여부
학습 중 보상이 상승해도 좋은 전투가 만들어졌다는 뜻은 아니다. 예를 들어 거리 유지 보상이 너무 크면 보스는 공격하지 않고 안전한 거리만 지킬 수 있다. 반대로 피격 패널티가 지나치면 플레이어에게 접근하지 않는 정책이 나올 수 있다. 학습 결과는 반드시 녹화나 플레이 모드 관찰로 확인한다.
상태 머신과 함께 쓰기
실전에서는 강화학습 정책에 모든 권한을 주기보다 상태 머신 안에 넣는 편이 관리하기 쉽다. 페이즈 전환, 무적 시간, 연출 공격, 필수 패턴은 상태 머신이 담당한다. 강화학습 에이전트는 ‘일반 전투 페이즈에서 어떤 위치를 잡고 어떤 공격을 시도할지’를 결정한다.
이렇게 분리하면 디자이너가 보장해야 하는 전투 흐름은 유지하면서도 플레이어 위치에 따라 근접 압박과 원거리 견제를 다르게 섞는 행동을 실험할 수 있다. 학습된 정책을 배포하기 전에는 관측 누락, 쿨다운 초기화, 애니메이션 이벤트와 실제 피해 판정의 불일치를 우선 점검하자.