게임 뉴스레터 구독자 반응 데이터로 주간 콘텐츠 자동 큐레이션하는 방법
게임 뉴스레터의 오픈율, 클릭률, 체류 시간, 구독 취소 데이터를 활용해 매주 콘텐츠를 자동 선별하고 Steam·마케팅·퍼블리싱 독자에게 맞춤 발송하는 실전 설계를 소개합니다.
핵심 요약
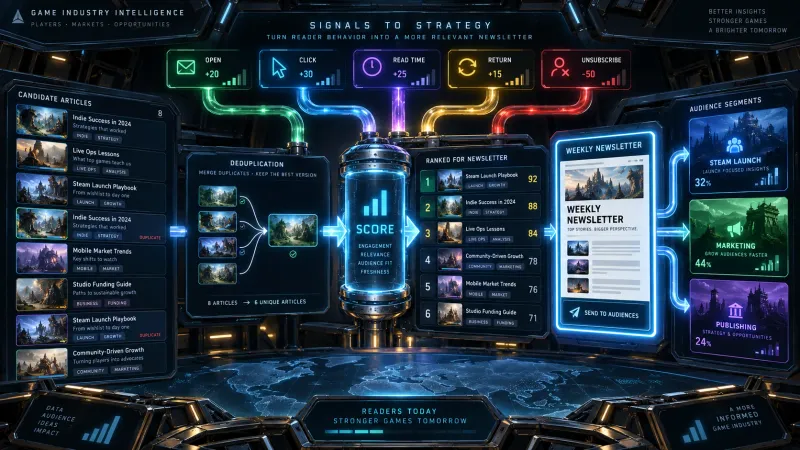
게임 뉴스레터의 주간 콘텐츠 자동 큐레이션은 구독자의 오픈율과 클릭률만 보는 작업이 아니다. 콘텐츠별 클릭 이벤트, 페이지 체류 시간, 재방문, 구독 취소를 하나의 이벤트 스키마로 수집한 뒤 관심도 점수를 계산하고 상위 콘텐츠를 자동 조합하는 시스템이다.
핵심은 수집 → 점수화 → 중복 제거 → 편집 규칙 적용 → 발송 → 결과 학습의 반복 구조다. Steam 출시 전략, 게임 마케팅, 퍼블리싱 계약, 가격 정책, 현지화처럼 주제가 넓은 뉴스레터일수록 구독자 세그먼트와 최신성 가중치를 함께 적용해야 품질이 안정된다.
게임 뉴스레터 자동 큐레이션은 왜 필요한가?
게임 산업 뉴스는 하루에도 여러 건이 쌓인다. 그러나 뉴스레터 운영자가 모든 글을 직접 읽고 매주 같은 기준으로 선별하기는 어렵다. 특히 다음 문제가 반복된다.
- 발행자 개인의 관심사에 따라 콘텐츠가 편향된다.
- 지난주와 비슷한 뉴스가 반복되어 클릭률이 떨어진다.
- 신규 구독자와 장기 구독자에게 같은 콘텐츠가 발송된다.
- 제목은 열렸지만 실제로 읽히지 않은 콘텐츠를 인기 글로 오판한다.
- 특정 주제의 반응이 좋았다는 이유로 관련 콘텐츠를 과도하게 넣는다.
자동 큐레이션의 목표는 사람이 하는 편집을 없애는 것이 아니다. 데이터가 추천 후보를 좁히고 편집자가 최종 맥락과 우선순위를 검수하도록 만드는 것이다.
어떤 구독자 반응 데이터를 수집해야 하는가?
최소한 뉴스레터 발송 이벤트와 콘텐츠 소비 이벤트를 분리해 수집해야 한다. 이메일 플랫폼의 통계만으로는 뉴스레터 안에서 어떤 콘텐츠가 실제로 관심을 받았는지 구분하기 어렵다.
| 데이터 | 이벤트 예시 | 활용 목적 |
|---|---|---|
| 발송 | newsletter_sent | 분모와 발송 성공률 계산 |
| 오픈 | newsletter_opened | 제목과 발송 시간 평가 |
| 클릭 | content_clicked | 콘텐츠별 관심도 계산 |
| 체류 | article_engaged | 단순 클릭과 실제 소비 구분 |
| 재방문 | article_returned | 장기 관심 콘텐츠 식별 |
| 공유 | content_shared | 확산 가능성 평가 |
| 구독 취소 | subscription_cancelled | 피로도와 부정 반응 감지 |
이벤트에는 최소한 다음 속성을 포함한다.
{
  "event_name": "content_clicked",
  "subscriber_id": "sub_1024",
  "content_id": "article_778",
  "topic": "steam-pricing",
  "segment": "indie-developer",
  "occurred_at": "2026-08-24T09:30:00+09:00",
  "utm_campaign": "weekly-2026-w34",
  "device": "mobile"
}subscriber_id는 이메일 주소를 그대로 저장하지 말고 내부 식별자나 해시값을 사용하는 편이 안전하다. 또한 개인정보 보호를 위해 보관 기간과 접근 권한을 먼저 정해야 한다.
관심도 점수는 어떻게 설계하는가?
가장 단순한 방식은 클릭 수가 많은 콘텐츠를 다음 주에 다시 추천하는 것이다. 하지만 이 방식은 오래된 인기 콘텐츠와 특정 대형 세그먼트에 편향될 수 있다. 실무에서는 반응의 질과 최신성을 함께 계산하는 점수 모델이 유용하다.
예를 들어 콘텐츠 점수는 다음처럼 정의할 수 있다.
각 항목은 0에서 1 사이로 정규화한다.
CTR: 해당 콘텐츠 클릭 수를 전달 성공 수로 나눈 값Engagement: 콘텐츠 페이지에서 기준 시간 이상 체류한 세션의 비율ShareRate: 클릭 세션 중 공유가 발생한 비율Freshness: 발행 후 시간이 지날수록 감소하는 최신성 점수
최신성 점수는 지수 감쇠 함수로 구현할 수 있다.
여기서 Δt는 콘텐츠 발행 후 경과 시간이고 λ는 주제별 감쇠 계수다. 출시 소식은 λ를 크게 설정해 빠르게 오래된 정보로 처리하고 가격 전략이나 현지화 가이드는 λ를 작게 설정해 장기적으로 추천할 수 있다.
type ContentMetric = {
  ctr: number;
  engagement: number;
  shareRate: number;
  freshness: number;
};

export function calculateScore(metric: ContentMetric): number {
  return (
    metric.ctr * 0.35 +
    metric.engagement * 0.25 +
    metric.shareRate * 0.2 +
    metric.freshness * 0.2
  );
}
절대적인 가중치는 정답이 아니다. 초기에는 운영 목표에 맞춰 고정하고 4~8주 단위로 발송 결과를 비교하면서 조정한다. 클릭률을 높이는 것이 목표인지 유료 상품 페이지 방문을 늘리는 것이 목표인지에 따라 점수 모델은 달라져야 한다.
오픈율보다 클릭 후 행동을 봐야 하는 이유는 무엇인가?
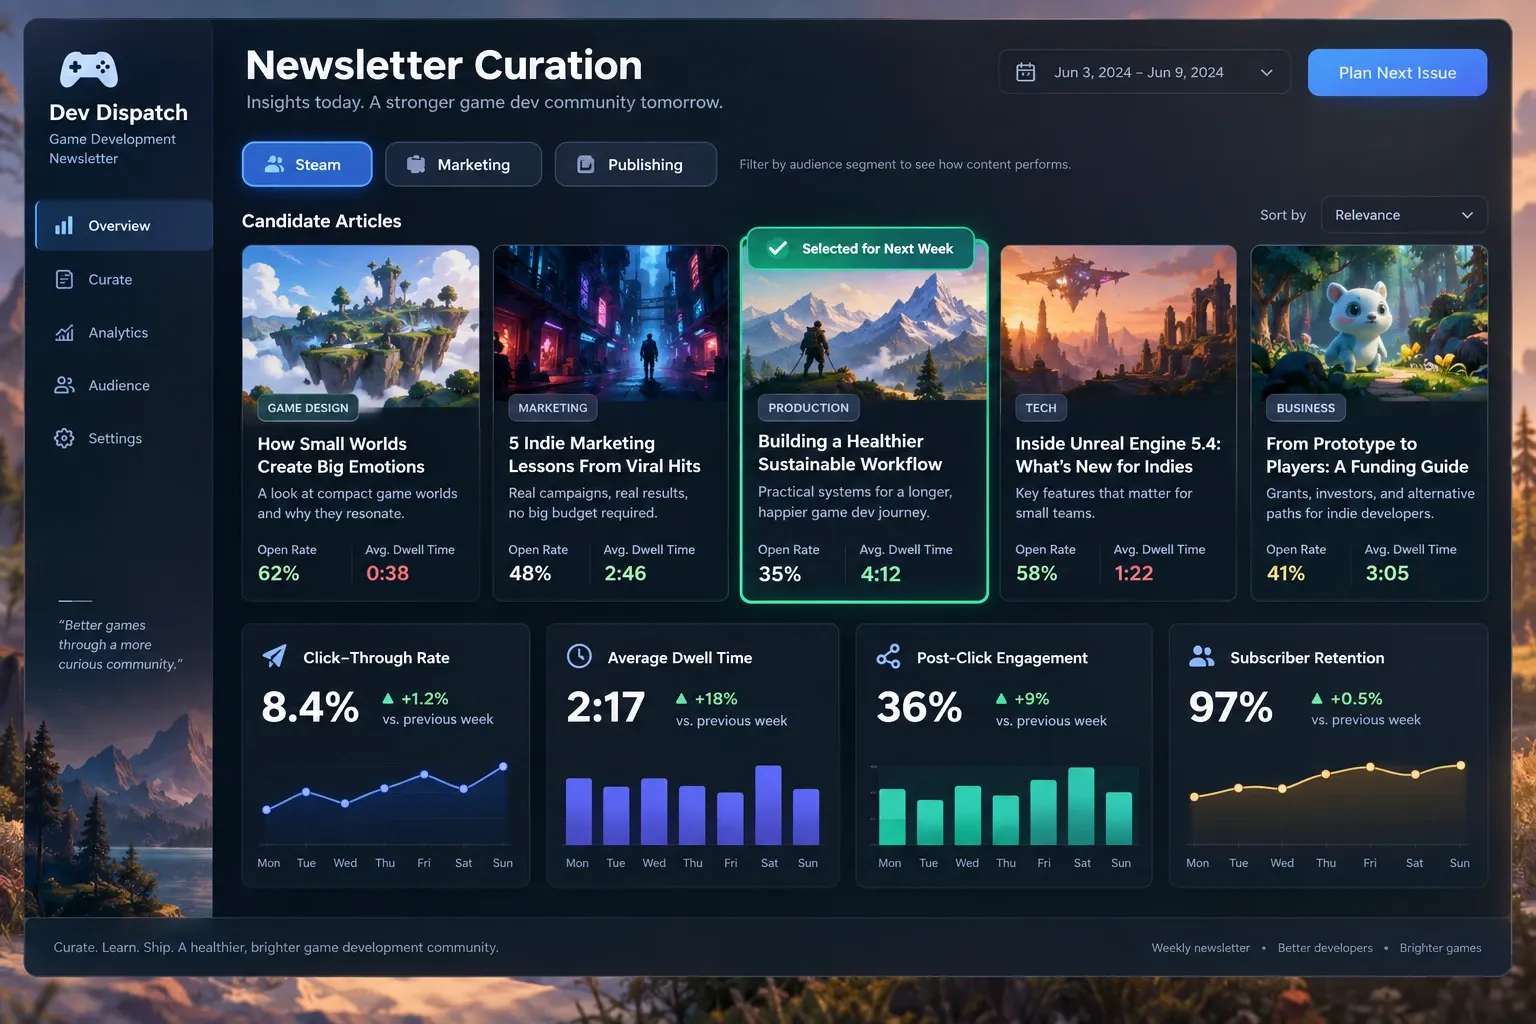
오픈율은 제목, 발송 시간, 메일 클라이언트의 이미지 로딩 정책에 영향을 받는다. 따라서 콘텐츠 품질을 평가하는 단일 지표로 사용하기 어렵다.
다음 지표를 함께 확인하는 것이 좋다.
| 지표 | 계산 방식 | 해석 |
|---|---|---|
| 오픈율 | 오픈 수 ÷ 전달 성공 수 | 제목과 발송 타이밍 |
| 클릭률 | 클릭 수 ÷ 전달 성공 수 | 전체 콘텐츠 관심도 |
| 클릭 후 참여율 | 참여 세션 ÷ 클릭 세션 | 실제 읽기 품질 |
| 콘텐츠별 CTR | 콘텐츠 클릭 수 ÷ 메일 클릭 수 | 슬롯별 경쟁력 |
| 구독 유지율 | 기간 종료 구독자 ÷ 기간 시작 구독자 | 장기 가치 |
예를 들어 제목이 자극적이면 오픈율은 높지만 클릭 후 체류 시간이 짧을 수 있다. 반대로 제목은 평범해도 클릭 후 참여율과 공유율이 높은 콘텐츠는 다음 큐레이션에서 우선순위를 높일 가치가 있다.
주간 콘텐츠 자동 큐레이션은 어떻게 구현할까?
1단계: 콘텐츠 메타데이터를 표준화한다
추천 엔진이 제목만 보고 콘텐츠를 비교하면 결과가 불안정하다. 각 콘텐츠에 고정된 메타데이터를 부여해야 한다.
type Content = {
  id: string;
  title: string;
  url: string;
  topics: string[];
  audience: string[];
  publishedAt: string;
  commercialIntent: 'awareness' | 'consideration' | 'conversion';
  isSponsored: boolean;
};
추천 메타데이터에는 다음 항목을 포함할 수 있다.
- 주제:
steam,pricing,publishing,localization,launch - 대상 독자: 인디 개발자, 퍼블리셔, 마케팅 담당자, 투자자
- 구매 단계: 인지도, 검토, 전환
- 형식: 뉴스, 분석, 인터뷰, 체크리스트, 사례 연구
- 상업성: 일반 콘텐츠, 스폰서 콘텐츠, 제품 안내
주제 이름은 자유 입력보다 고정된 taxonomy를 사용하는 것이 좋다. Steam 가격, 스팀 가격, 가격 정책처럼 같은 의미가 여러 이름으로 저장되면 세그먼트 분석이 분산된다.
2단계: 구독자를 행동 기반 세그먼트로 나눈다
직무나 가입 설문만으로는 현재 관심사를 충분히 반영하기 어렵다. 최근 4~8주 동안 실제로 클릭한 콘텐츠를 기준으로 행동 세그먼트를 만든다.
| 세그먼트 | 주요 행동 | 추천 주제 |
|---|---|---|
| 인디 개발자 | 개발·출시 글 클릭 | Steam 출시, 가격, 현지화 |
| 퍼블리싱 탐색자 | 계약·딜 관련 글 클릭 | 퍼블리싱 계약, 수익 배분 |
| 마케팅 실무자 | 캠페인·광고 글 클릭 | 위시리스트, 트레일러, CRM |
| 장기 비활성자 | 30일 이상 미클릭 | 인기 요약, 입문형 콘텐츠 |
세그먼트별 점수는 개인화 강도를 조절하는 데 사용한다. 구독자의 관심 주제 점수와 콘텐츠 주제의 유사도를 곱하면 다음과 같이 표현할 수 있다.
TopicAffinity는 구독자가 특정 주제의 콘텐츠를 클릭한 비율이나 최근 클릭 횟수로 계산할 수 있다. 다만 개인화가 지나치면 새로운 주제를 발견할 기회가 줄어들므로 전체 구독자에게 공통으로 노출하는 슬롯도 남겨두는 편이 좋다.
3단계: 후보 콘텐츠를 점수화하고 중복을 제거한다
상위 점수 콘텐츠만 나열하면 같은 주제가 뉴스레터를 독점할 수 있다. 추천 전에 주제별 최대 개수와 형식별 최소 개수를 설정한다.
type Rule = {
  maxPerTopic: number;
  requiredFormats: string[];
  maxSponsored: number;
};

export function selectContents(contents: Content[], rule: Rule): Content[] {
  const topicCount = new Map<string, number>();
  let sponsoredCount = 0;
  const selected: Content[] = [];

  for (const content of contents) {
    const mainTopic = content.topics[0] ?? 'general';
    const currentCount = topicCount.get(mainTopic) ?? 0;

    if (currentCount >= rule.maxPerTopic) continue;
    if (content.isSponsored && sponsoredCount >= rule.maxSponsored) continue;

    selected.push(content);
    topicCount.set(mainTopic, currentCount + 1);
    if (content.isSponsored) sponsoredCount += 1;
  }

  return selected;
}
실제 운영에서는 score DESC, published_at DESC 순서로 후보를 정렬한 뒤 다음 규칙을 적용할 수 있다.
- 주간 추천 콘텐츠는 5~7개로 제한한다.
- 동일한 주제는 최대 2개까지만 넣는다.
- 같은 출처의 콘텐츠가 2개 이상 연속되지 않게 한다.
- 스폰서 콘텐츠는 전체 슬롯의 비율을 제한한다.
- 이미 클릭한 콘텐츠를 다시 추천할지 여부를 세그먼트별로 다르게 설정한다.
- 가격, 계약, 법률처럼 해석 위험이 있는 글은 사람이 검수한다.
자동화 파이프라인은 어떤 구조로 만드는가?
다음 구조는 콘텐츠 수집과 이메일 발송을 분리해 운영하기 쉽다.
flowchart LR
  A[콘텐츠 수집] --> B[메타데이터 분류]
  B --> C[반응 데이터 결합]
  C --> D[관심도 점수 계산]
  D --> E[중복 제거와 편집 규칙]
  E --> F[편집자 검수]
  F --> G[뉴스레터 발송]
  G --> H[결과 이벤트 저장]
  H --> C
구현 조합은 팀의 규모와 기존 인프라에 따라 선택한다.
| 구성 요소 | 예시 역할 | 선택 기준 |
|---|---|---|
| 수집기 | RSS, CMS, Airtable, 데이터베이스 | 입력 채널의 안정성 |
| 저장소 | PostgreSQL, BigQuery | 이벤트 규모와 분석 복잡도 |
| 작업 스케줄러 | GitHub Actions, cron, Airflow | 실행 주기와 재시도 필요성 |
| 분석 계층 | SQL, dbt, Python | 팀의 데이터 역량 |
| 발송 도구 | 이메일 CRM, ESP API | 세그먼트와 자동화 지원 여부 |
| 모니터링 | 로그, 알림, 대시보드 | 실패 감지와 운영 책임 |
주간 실행 시점에는 멱등성을 보장해야 한다. 같은 주차 작업이 재실행되어도 뉴스레터가 중복 발송되지 않도록 campaign_id와 subscriber_id 조합에 고유 제약을 두거나 발송 전 상태를 확인한다.
자동 큐레이션 품질을 어떻게 검증할까?
자동화가 완료되었다고 바로 전체 구독자에게 발송하면 안 된다. 먼저 추천 결과의 품질과 운영 안전성을 확인해야 한다.
편집 품질 체크리스트
- 제목과 본문 요약이 실제 원문과 일치하는가?
- 출시일, 가격, 계약 조건처럼 변동 가능한 정보에 날짜가 표시되어 있는가?
- 동일한 뉴스의 다른 출처가 중복 추천되지 않았는가?
- 스폰서 콘텐츠와 일반 콘텐츠가 명확히 구분되는가?
- 추적 URL에
utm_source,utm_medium,utm_campaign,utm_content가 포함되었는가? - 모바일 화면에서 제목과 CTA가 잘리는 부분이 없는가?
- 구독 취소 링크와 개인정보 안내가 정상 동작하는가?
A/B 테스트 기준
처음부터 여러 요소를 동시에 바꾸면 원인을 찾기 어렵다. 한 번에 하나의 변수만 테스트한다.
- 제목: 정보형 제목과 문제 해결형 제목
- 발송 시간: 평일 오전과 오후
- 큐레이션 수: 5개와 7개
- 요약 길이: 2문장과 4문장
- CTA: 원문 읽기와 실무 체크리스트 다운로드
평가 지표는 오픈율 하나가 아니라 클릭 후 참여율, 구독 유지율, 전환율까지 연결해야 한다. 테스트 기간과 최소 표본 수를 미리 정하지 않으면 일시적인 반응을 장기 정책으로 잘못 해석할 수 있다.
자주 묻는 질문 FAQ
구독자가 적어도 자동 큐레이션을 시작할 수 있는가?
가능하다. 초기에는 개인화 모델보다 고정 규칙과 주제별 클릭률 분석부터 시작하면 된다. 데이터가 쌓인 뒤 세그먼트별 점수와 최신성 가중치를 추가하는 순서가 안전하다.
오픈율이 낮으면 콘텐츠 큐레이션이 실패한 것인가?
반드시 그렇지는 않다. 오픈율은 제목과 발송 시간의 영향을 크게 받는다. 콘텐츠별 CTR, 클릭 후 체류 시간, 재방문, 구독 유지율을 함께 확인해야 원인을 구분할 수 있다.
AI가 제목과 요약을 모두 자동으로 작성해도 되는가?
초안 작성에는 활용할 수 있지만 가격, 계약, 출시 일정, 플랫폼 정책과 관련된 내용은 사람이 원문을 대조해야 한다. 자동 생성 결과에는 원문 URL과 발행일을 함께 저장해 검수 가능성을 확보하는 것이 좋다.
정리
게임 뉴스레터의 주간 자동 큐레이션은 단순한 인기 콘텐츠 정렬이 아니다. content_clicked, article_engaged, content_shared 같은 이벤트를 표준화하고 CTR, 참여율, 공유율, 최신성 점수를 조합해야 실제 관심을 반영할 수 있다.
운영 순서는 간단하게 시작하면 된다.
- 콘텐츠 메타데이터와 반응 이벤트를 표준화한다.
- 주제별 관심도와 최신성으로 후보를 점수화한다.
- 중복 제거와 상업성 제한 규칙을 적용한다.
- 편집자 검수 후 세그먼트별로 발송한다.
- 발송 결과를 다시 점수 모델에 반영한다.
이 구조를 갖추면 뉴스레터가 매주 같은 형식으로 반복되는 메일이 아니라 독자의 실제 행동을 학습하는 게임 산업 콘텐츠 채널로 발전할 수 있다.