게임 개발 회의 음성 녹음을 실시간 텍스트로 변환하고 핵심 결정 사항을 자동 정리하는 방법
게임 개발 회의의 음성을 WebSocket 기반 실시간 STT로 변환하고 발화자·타임스탬프·결정 사항을 자동 추출해 일정과 스코프 문서로 연결하는 설계 방법을 정리합니다.
핵심 요약
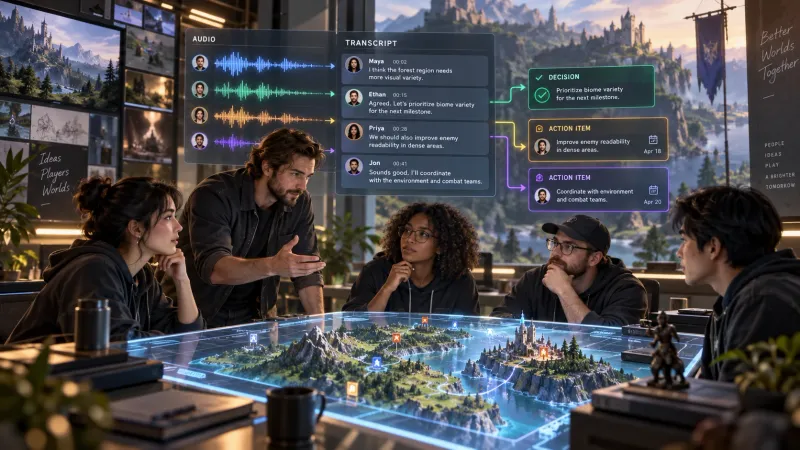
게임 개발 회의 자동화의 핵심은 음성을 녹음하는 데 있지 않습니다. WebSocket으로 오디오 청크를 전송하고 스트리밍 STT로 중간 문장을 표시한 뒤 VAD, 발화자 분리, 결정 사항 추출을 순서대로 적용해야 실무에서 사용할 수 있는 회의록이 됩니다. 최종 결과는 발언 전문이 아니라 결정 내용, 담당자, 기한, 근거가 포함된 구조화된 액션 아이템이어야 합니다.
게임 개발 회의 음성 기록이 문서화로 이어지지 않는 이유는 무엇인가?
게임 개발 회의에서는 기획, 클라이언트, 서버, 아트, QA가 동시에 이야기합니다. 회의가 끝난 뒤에도 다음과 같은 문제가 반복됩니다.
- 누가 어떤 결정을 제안했는지 확인하기 어렵다.
- “다음 스프린트에 처리한다”처럼 기한이 모호한 표현이 남는다.
- 스코프 변경과 단순 아이디어가 같은 수준으로 기록된다.
- 회의 중에는 이해했지만 며칠 뒤 결정 배경을 찾기 어렵다.
- 음성 녹음은 남아 있어도 필요한 발언을 다시 찾는 데 시간이 오래 걸린다.
따라서 목표를 “회의 전체를 글로 바꾸기”로 잡으면 안 됩니다. 목표는 회의 중 발화를 다음 네 가지 문서 데이터로 변환하는 것입니다.
| 데이터 | 예시 | 활용 위치 |
|---|---|---|
| 결정 사항 | 보스전 2페이즈를 정식 출시에서 제외 | 결정 로그 |
| 액션 아이템 | 전투 디자이너가 난이도 표를 수정 | 태스크 보드 |
| 담당자 | 김기획 | 담당자 필드 |
| 기한 | 9월 2일 스프린트 리뷰 전 | 일정 및 알림 |
실시간 텍스트 변환 시스템은 어떻게 구성할까?
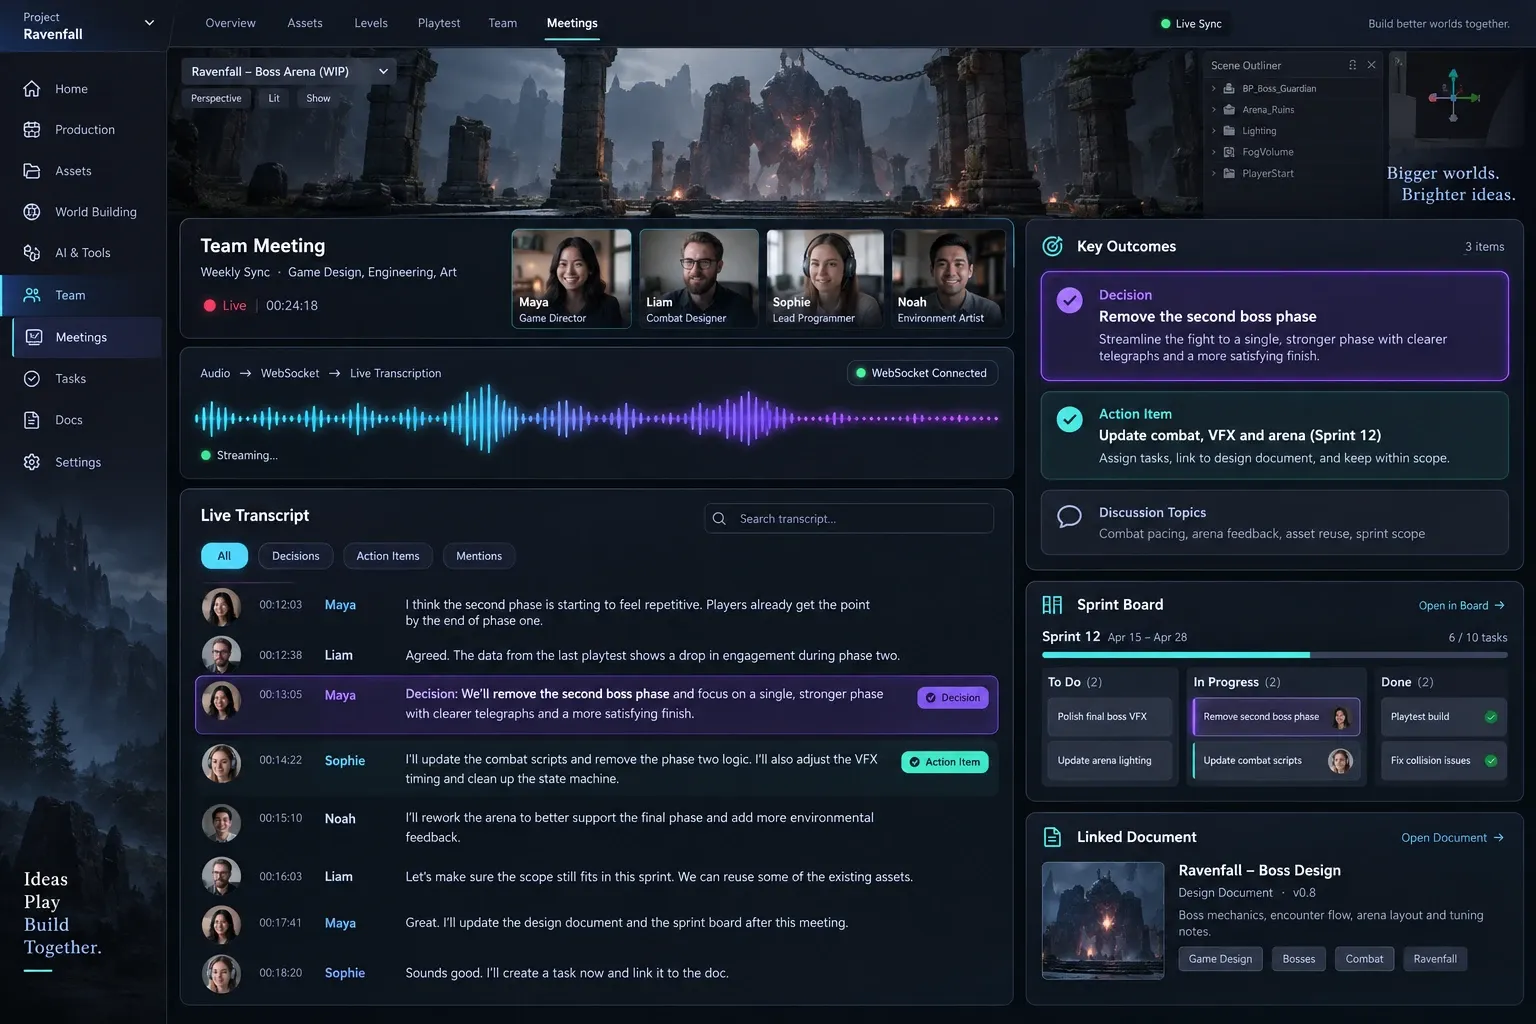
실무에서 사용할 수 있는 기본 파이프라인은 다음과 같습니다.
flowchart LR
    A[마이크 입력] --> B[Web Audio API 또는 MediaRecorder]
    B --> C[WebSocket 오디오 스트림]
    C --> D[VAD와 오디오 정규화]
    D --> E[스트리밍 STT 엔진]
    E --> F[중간 자막과 최종 문장]
    F --> G[발화자 분리와 타임스탬프]
    G --> H[결정 사항 추출 LLM]
    H --> I[회의록과 액션 아이템 저장]
    I --> J[PM 대시보드와 알림]
구현 예시는 TypeScript 5.x, Node.js 22 LTS, PostgreSQL 16, Redis 7, WebSocket, WebRTC Opus를 기준으로 잡을 수 있습니다. STT는 클라우드 스트리밍 API나 자체 호스팅한 Whisper 계열 모델로 교체할 수 있지만 인터페이스는 interim과 final 결과를 분리하는 형태가 좋습니다.
1. 마이크 오디오를 작은 청크로 전송한다
브라우저에서는 MediaRecorder 또는 AudioWorklet으로 입력을 수집할 수 있습니다. 구현 난이도를 낮추려면 MediaRecorder를 사용하고 낮은 지연 시간과 일정한 샘플 포맷이 필요하면 AudioWorklet을 선택합니다.
오디오 스트림은 한 번에 전체 파일로 업로드하지 않고 짧은 청크로 보냅니다. 청크 간격이 너무 길면 자막 지연이 커지고 너무 짧으면 WebSocket 메시지 오버헤드가 증가합니다. 초기값으로 250~500ms를 사용한 뒤 실제 회의 환경에서 조정하는 방식이 안전합니다.
const stream = await navigator.mediaDevices.getUserMedia({
  audio: {
    channelCount: 1,
    echoCancellation: true,
    noiseSuppression: true,
    autoGainControl: true
  }
});

const socket = new WebSocket('/api/meetings/meeting-42/audio');
const recorder = new MediaRecorder(stream, {
  mimeType: 'audio/webm;codecs=opus'
});

recorder.ondataavailable = async (event) => {
  if (event.data.size > 0 && socket.readyState === WebSocket.OPEN) {
    socket.send(await event.data.arrayBuffer());
  }
};

recorder.start(300);
브라우저와 STT 엔진의 지원 포맷이 다르면 서버에서 PCM s16le, 모노, 16kHz 또는 엔진이 요구하는 샘플레이트로 변환해야 합니다. 이때 ffmpeg를 실시간 파이프라인에 무리하게 연결하면 CPU 사용량과 지연 시간이 증가할 수 있으므로 먼저 엔진이 지원하는 입력 포맷을 확인해야 합니다.
2. VAD로 무음 구간과 문장 경계를 처리한다
VAD(Voice Activity Detection)는 음성이 시작되고 끝나는 지점을 찾는 단계입니다. 회의에서는 말이 끊긴 뒤 다음 사람이 발언하기까지의 무음이 자주 발생하므로 VAD 없이 고정 길이로만 자르면 문장이 중간에서 잘릴 수 있습니다.
VAD의 주요 파라미터는 다음과 같습니다.
| 파라미터 | 의미 | 조정 방향 |
|---|---|---|
min_speech_duration_ms | 음성으로 인정할 최소 길이 | 짧은 추임새 제거 |
min_silence_duration_ms | 발화 종료로 판단할 무음 길이 | 문장 연결과 반응성의 균형 |
speech_pad_ms | 발화 앞뒤에 추가할 여유 구간 | 단어 앞뒤 잘림 방지 |
max_segment_duration_s | 한 세그먼트의 최대 길이 | 긴 독백 분할 |
초기값은 min_silence_duration_ms=500, speech_pad_ms=150, max_segment_duration_s=15처럼 설정할 수 있습니다. 다만 한국어 회의에서는 생각하는 동안 긴 침묵이 생길 수 있으므로 회의 스타일에 따라 값을 조정해야 합니다.
3. 중간 결과와 최종 결과를 구분한다
스트리밍 STT는 아직 확정되지 않은 interim result와 확정된 final result를 보냅니다. 중간 결과는 화면에 빠르게 보여주되 데이터베이스에는 임시 상태로 저장하고 최종 결과만 회의록 분석의 입력으로 사용하는 것이 좋습니다.
type TranscriptSegment = {
  meetingId: string;
  segmentId: string;
  speakerId?: string;
  text: string;
  startMs: number;
  endMs: number;
  status: 'interim' | 'final';
  confidence?: number;
};

function upsertTranscript(segment: TranscriptSegment) {
  if (segment.status === 'interim') {
    return transcriptCache.set(segment.segmentId, segment);
  }

  return transcriptRepository.upsert({
    id: segment.segmentId,
    meetingId: segment.meetingId,
    speakerId: segment.speakerId,
    text: segment.text,
    startMs: segment.startMs,
    endMs: segment.endMs,
    confidence: segment.confidence ?? null
  });
}
중간 결과를 최종 문장처럼 처리하면 같은 내용이 여러 번 저장되거나 문장이 확정되기 전에 결정 사항으로 분류되는 문제가 발생합니다.
발화자를 어떻게 구분하고 회의록 신뢰도를 높일까?
발화자 구분은 두 가지 방식으로 접근할 수 있습니다.
- 회의 시작 시 각 사용자가 자신의 이름을 선택하고 별도 채널을 사용한다.
- 하나의 오디오 채널에서
speaker diarization모델로 발화 구간을 분리한다.
첫 번째 방식은 정확도가 높고 구현이 단순합니다. 원격 회의에서 참가자별 오디오 트랙을 확보할 수 있다면 참가자 ID와 음성 세그먼트를 직접 매핑하는 편이 좋습니다. 두 번째 방식은 단일 녹음 파일에도 적용할 수 있지만 겹쳐 말하기와 마이크 품질에 영향을 크게 받습니다.
발화자 이름을 확정할 수 없는 경우에는 억지로 이름을 붙이지 말고 Speaker 1, Speaker 2처럼 표시해야 합니다. 잘못된 담당자 이름은 오탈자보다 더 큰 운영 문제를 만듭니다.
회의록에는 다음 메타데이터도 함께 저장하는 것이 좋습니다.
- 발화 시작 및 종료 시각
- STT 신뢰도
- 사용한 언어 코드 예:
ko-KR - 오디오 품질 또는 오류 상태
- 수정된 문장인지 여부
- 원문으로 이동할 수 있는 타임스탬프
핵심 결정 사항은 어떻게 자동으로 추출할까?
단순 요약 모델에 “회의를 요약해줘”라고 요청하면 중요한 결정과 배경 설명이 섞입니다. 대신 결정 사항의 조건을 명시한 구조화 출력 스키마를 사용해야 합니다.
결정 사항은 다음 조건을 만족할 때만 생성하도록 정의할 수 있습니다.
- 팀이 선택한 방향이 명확하다.
- 이전 계획이나 스코프가 바뀌었는지 알 수 있다.
- 담당자 또는 후속 행동을 지정할 수 있다.
- 발언 전문에서 근거 구간을 찾을 수 있다.
예시 스키마는 다음과 같습니다.
type DecisionItem = {
  id: string;
  title: string;
  decision: string;
  reason?: string;
  owner?: string;
  dueDate?: string;
  priority?: 'P0' | 'P1' | 'P2' | 'P3';
  scopeImpact: 'none' | 'small' | 'large';
  evidenceSegmentIds: string[];
  confidence: number;
  reviewStatus: 'pending' | 'approved' | 'rejected';
};
LLM 프롬프트에는 발화 전문 전체를 그대로 넣기보다 확정된 세그먼트를 시간 순서로 전달합니다. 모델이 근거를 임의로 만들지 않도록 evidenceSegmentIds를 반드시 반환하게 하고 해당 ID가 실제 회의 세그먼트에 존재하는지 서버에서 검증해야 합니다.
역할: 게임 개발 프로젝트 매니저 보조
목표: 회의에서 합의되었거나 명시적으로 승인된 결정만 추출한다.
규칙:
- 제안, 질문, 추측은 결정 사항으로 분류하지 않는다.
- 담당자와 기한이 명시되지 않았다면 null을 사용한다.
- 각 결과에는 실제 transcript segment_id를 하나 이상 포함한다.
- 회의 발화에 없는 사실을 추가하지 않는다.
- JSON 스키마 외의 텍스트는 출력하지 않는다.
모델이 “아마 다음 주에 처리할 수 있다”를 확정된 일정으로 변환하지 않게 하는 것이 핵심입니다. 확정, 제안, 보류, 추가 확인 필요를 별도 상태로 두면 PM이 검토할 수 있습니다.
자동 생성된 액션 아이템을 일정과 스코프에 연결하는 방법
결정 사항을 문서에만 저장하면 자동화의 효과가 제한됩니다. 최소한 다음 필드를 갖춘 액션 아이템으로 변환해야 합니다.
| 필드 | 처리 규칙 |
|---|---|
| 제목 | 동사로 시작하는 짧은 작업명 |
| 담당자 | 회의에서 명시된 사람만 연결 |
| 기한 | 절대 날짜가 있으면 ISO 8601로 저장 |
| 우선순위 | 긴급도와 릴리스 영향으로 계산하되 최종 승인 필요 |
| 스코프 영향 | 기능 추가, 삭제, 변경 여부 기록 |
| 근거 | 원문 세그먼트와 타임스탬프 연결 |
| 상태 | 검토 전에는 반드시 pending |
상대 날짜는 자동으로 확정하지 않는 편이 안전합니다. 예를 들어 “금요일까지”라는 표현은 회의 날짜와 팀의 근무일 기준을 함께 확인해야 합니다. 변환이 불확실하면 원문을 유지하고 PM 검토 대상으로 표시합니다.
우선순위는 다음처럼 간단한 규칙으로 시작할 수 있습니다.
여기서 R은 릴리스 차단 여부, S는 스코프 영향도, D는 의존 작업 수, U는 사용자 경험 영향도를 각각 0 또는 1로 표현한 값입니다. 이 점수는 자동 정렬용 보조 지표일 뿐이며 최종 우선순위는 팀이 승인해야 합니다.
실시간 회의 자막과 최종 요약의 지연 시간을 어떻게 관리할까?
사용자 경험은 한 종류의 지연 시간으로 평가되지 않습니다.
| 구간 | 목표 예시 | 사용자에게 보이는 결과 |
|---|---|---|
| 오디오 캡처 | 100ms 이하 | 자연스러운 입력 |
| 중간 STT | 1~2초 | 실시간 자막 |
| 최종 STT | 2~5초 | 확정 문장 |
| 결정 추출 | 회의 중 수 초 또는 종료 후 | 검토 가능한 카드 |
| 문서 저장 | 1초 이하 | 회의록 자동 갱신 |
실시간 자막과 결정 사항 추출을 같은 경로에서 처리하면 LLM 지연 때문에 자막이 늦어질 수 있습니다. 자막 경로는 오디오 수집 → STT → 화면 표시로 짧게 유지하고 결정 분석은 최종 세그먼트가 일정 개수 쌓였을 때 비동기로 처리하는 것이 안정적입니다.
회의 종료 후에는 전체 전문을 다시 분석해 누락된 결정 사항을 보완할 수 있습니다. 단, 이 결과도 자동 확정하지 말고 기존 실시간 결과와 중복을 제거한 뒤 검토 목록으로 보여주는 편이 좋습니다.
개인정보와 음성 데이터는 어떻게 보호할까?
회의 음성에는 미공개 게임 기능, 계약 정보, 개인 평가가 포함될 수 있습니다. 따라서 기술 설계와 함께 보존 정책을 정해야 합니다.
- 녹음 시작 전에 참석자에게 녹음 및 전사 사실을 알린다.
- 프로젝트와 회의별 접근 권한을 분리한다.
- 전송 구간은 TLS로 보호하고 저장 데이터는 암호화한다.
- 원본 음성, 전사문, 요약문에 서로 다른 보존 기간을 적용한다.
- 외부 STT나 LLM API로 전송되는 데이터의 저장 및 학습 정책을 확인한다.
- 이름, 이메일, 전화번호 같은 개인정보를 마스킹할 수 있는 단계를 둔다.
- 삭제 요청이 들어오면 원본 오디오와 파생 전사·요약 데이터를 함께 삭제한다.
특히 음성 데이터는 텍스트보다 재식별 가능성이 높습니다. 빠른 프로토타입이라도 “무기한 보관”을 기본값으로 두지 않는 것이 좋습니다.
구현 절차: 실시간 회의 전사 기능을 어떻게 단계적으로 만들까?
Step 1. 회의록 데이터 모델부터 정의한다
먼저 meetings, transcript_segments, decisions, action_items 테이블을 나눕니다. 전사 세그먼트와 결정 사항을 한 테이블에 넣으면 문장 수정과 결정 검토 상태를 독립적으로 관리하기 어렵습니다.
CREATE TABLE transcript_segments (
  id UUID PRIMARY KEY,
  meeting_id UUID NOT NULL,
  speaker_id UUID NULL,
  text TEXT NOT NULL,
  start_ms INTEGER NOT NULL,
  end_ms INTEGER NOT NULL,
  confidence NUMERIC(4,3),
  status VARCHAR(16) NOT NULL DEFAULT 'final',
  created_at TIMESTAMPTZ NOT NULL DEFAULT now()
);

CREATE TABLE decisions (
  id UUID PRIMARY KEY,
  meeting_id UUID NOT NULL,
  decision TEXT NOT NULL,
  reason TEXT NULL,
  owner_id UUID NULL,
  due_date DATE NULL,
  scope_impact VARCHAR(16) NOT NULL DEFAULT 'none',
  confidence NUMERIC(4,3) NOT NULL,
  review_status VARCHAR(16) NOT NULL DEFAULT 'pending',
  created_at TIMESTAMPTZ NOT NULL DEFAULT now()
);
Step 2. 한 명의 사용자와 짧은 회의로 STT 정확도를 검증한다
처음부터 여러 명이 겹쳐 말하는 긴 회의를 처리하지 말고 다음 항목을 측정합니다.
- 한국어 고유명사 인식률
- 기획 용어와 기능명 인식률
- 중간 자막 지연 시간
- 최종 문장 수정 비율
- 발화자 구분 정확도
- 회의 종료 후 결정 사항 누락률
정확도는 단순한 단어 일치율만으로 판단하기 어렵습니다. 게임 이름, 캐릭터명, 스킬명, 내부 시스템명처럼 프로젝트 사전에 있는 용어의 오류율을 별도로 확인해야 합니다.
Step 3. 결정 사항을 검토 가능한 카드로 표시한다
자동 추출 결과는 다음 정보를 한 화면에서 보여줘야 합니다.
- 결정 제목
- 결정 내용
- 담당자와 기한
- 스코프 영향
- 신뢰도
- 근거 발언으로 이동하는 링크
- 승인, 수정, 반려 버튼
PM이 원문을 다시 듣거나 읽지 않고 승인할 수 있어야 하지만 필요할 때는 타임스탬프를 눌러 해당 발언으로 이동할 수 있어야 합니다.
Step 4. 승인된 결과만 외부 시스템에 동기화한다
회의 중 생성된 액션 아이템을 곧바로 일정이나 이슈 트래커에 등록하면 잘못된 작업이 팀에 전파될 수 있습니다. pending → approved 상태 변경 후에만 Jira, Linear, Notion 또는 사내 태스크 보드로 동기화하는 구조가 적절합니다.
Step 5. 회의 종료 후 품질 리포트를 남긴다
자동화 품질을 개선하려면 결과뿐 아니라 실패 원인도 기록해야 합니다.
- STT 오류가 많은 구간
- 발화자 미식별 구간
- 사람이 수정한 결정 내용
- 반려된 자동 액션 아이템
- 누락으로 신고된 결정 사항
이 데이터를 모으면 프로젝트별 용어 사전과 프롬프트를 개선할 수 있습니다.
자동 요약 품질을 평가하는 기준은 무엇인가?
회의 요약은 문장이 자연스러운지만 봐서는 안 됩니다. PM 관점에서는 실행 가능성과 근거가 중요합니다.
| 평가 항목 | 질문 |
|---|---|
| 사실성 | 원문에 없는 내용을 추가하지 않았는가? |
| 완전성 | 중요한 결정과 액션 아이템을 빠뜨리지 않았는가? |
| 근거성 | 모든 결정에 원문 위치가 연결되는가? |
| 실행 가능성 | 담당자와 다음 행동이 명확한가? |
| 중복성 | 같은 결정이 여러 카드로 생성되지 않았는가? |
| 불확실성 | 보류와 확정이 구분되는가? |
초기 운영에서는 자동화율보다 “잘못된 확정 결정의 비율”을 더 중요한 지표로 보는 것이 좋습니다. 회의록 한 건을 완전히 자동 생성하는 것보다 사람이 빠르게 검토할 수 있는 정확한 초안을 제공하는 편이 팀 신뢰를 얻기 쉽습니다.
자주 묻는 질문 FAQ
실시간 음성 텍스트 변환은 녹음 파일 업로드보다 무엇이 좋은가?
회의 중 자막과 결정 후보를 바로 확인할 수 있다는 점이 가장 큽니다. 다만 최종 정확도는 녹음 종료 후 재처리한 결과가 더 나을 수 있으므로 실시간 결과와 사후 보정 결과를 분리하는 것이 좋습니다.
Whisper만 사용하면 발화자와 결정 사항까지 자동으로 알 수 있는가?
Whisper 계열 모델은 주로 음성을 텍스트로 변환합니다. 발화자 분리는 별도의 diarization 단계가 필요하고 결정 사항 추출은 규칙 기반 처리나 LLM 분석을 추가해야 합니다.
AI가 만든 회의 결정을 자동으로 일정에 등록해도 되는가?
초기에는 권장하지 않습니다. 담당자, 기한, 스코프 영향이 불확실할 수 있으므로 pending 상태로 저장한 뒤 PM 또는 회의 진행자가 승인한 항목만 외부 일정과 태스크 보드에 등록해야 합니다.
정리
게임 개발 회의 자동화의 핵심은 음성 인식 모델 하나를 선택하는 일이 아닙니다. 오디오 청크 전송, VAD, 스트리밍 STT, 발화자 분리, 구조화된 결정 추출, 사람의 승인 과정을 하나의 운영 흐름으로 연결하는 일입니다.
가장 현실적인 시작점은 한 명의 사용자가 참여하는 짧은 회의에서 interim/final 전사를 구현하고 최종 세그먼트에만 결정 사항 분석을 적용하는 것입니다. 이후 프로젝트 용어 사전과 검토 데이터를 축적하면 일정, 스코프, 우선순위 문서가 회의 직후 자동으로 갱신되는 PM 워크플로로 확장할 수 있습니다.