Elasticsearch와 Kibana로 구축하는 실시간 게임 어뷰징 및 작업장 탐지 시스템
게임 내 재화 인플레이션과 생태계를 파괴하는 작업장 및 매크로 어뷰징을 Elasticsearch 8.x와 Kibana의 집계 파이프라인과 실시간 이상 탐지 규칙으로 탐지·차단하는 아키텍처 가이드입니다.
핵심 요약
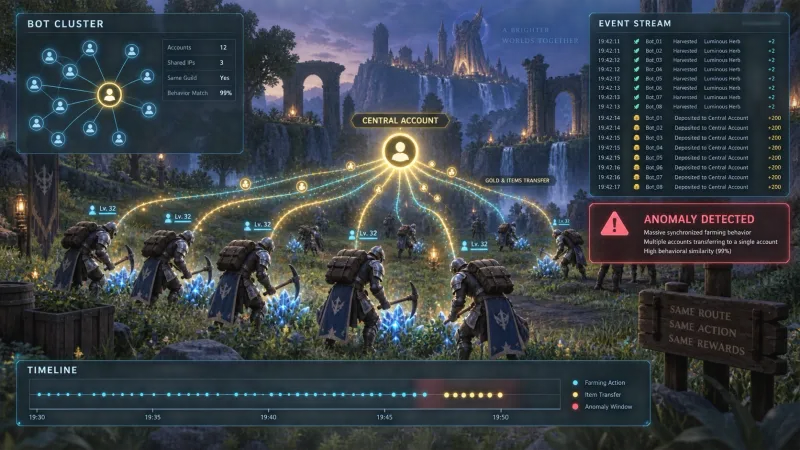
게임 내 작업장(Botnet)과 비정상 어뷰징을 실시간으로 탐지하려면 여러 계정의 행동 로그를 시계열로 분석해야 합니다. RDBMS 인덱싱이나 단일 룰셋만으로는 대응하기 어려울 수 있습니다. 이 글에서는 Kafka와 Logstash/Vector로 게임 서버 이벤트를 Elasticsearch 8.x Data Streams에 저장하고, Aggregations·EQL(Event Query Language)·Kibana Alerting을 연결해 작업장 계정과 이상 거래를 탐지하는 파이프라인을 설명합니다. 탐지와 제재까지 1분 이내에 처리하는 구성을 다룹니다.
게임 어뷰징과 작업장 탐지, 왜 RDBMS만으로는 한계가 있는가?
온라인 게임에서 발생하는 매크로 파밍, 다계정 작업장, 재화 불법 이동, 스피드핵/좌표 텔레포트 등의 어뷰징 행위는 개별 트랜잭션 단위로는 정상적인 API 호출처럼 보이는 경우가 많습니다. 예를 들어 한 번의 사냥 퀘스트 완료나 1회의 골드 거래는 시스템상 완전히 유효한 요청입니다.
그러나 이를 수십 대의 가상머신(VM)이나 수백 개의 다중 클라이언트 관점에서 시계열로 분석하면 다음과 같은 뚜렷한 작업장 시그니처가 드러납니다.
- 행동의 기계적 주기성: 인간 플레이어와 달리 오차 범위 수 밀리초() 단위로 반복되는 이동 및 스킬 사용 패턴
- 다계정 자원 집중(Fan-in) 네트워크: 수십 개의 파밍 캐릭터가 획득한 재화가 특정 유통 계정으로 모이는 비대칭 거래 그래프
- 동일 인프라 다중 접속: 동일한 공인 IP 대역, 기기 고유 식별자(HWID), GPU 렌더러 핑거프린트를 공유하는 비정상적인 동시 접속 군집
이러한 패턴을 탐지하려면 유저의 모든 인게임 액션(로그인, 이동, 전투, 거래, 인벤토리 변경)을 초당 수만 건 이상 수집하고 최근 N분~N시간 윈도우 내에서 다차원 집계 쿼리를 즉시 수행해야 합니다. 읽기·쓰기 락(Lock)과 수평 확장의 한계를 지닌 전통적인 RDBMS 환경에서는 이와 같은 대규모 시계열 집계가 데이터베이스 성능 병목을 유발합니다. 따라서 대용량 분산 검색 및 실시간 집계에 특화된 Elasticsearch와 시각화·알림 도구인 Kibana의 조합이 강력한 해결책이 됩니다.
flowchart LR
    GS[게임 서버 클러스터] -->|이벤트 발행| KF[Apache Kafka]
    KF -->|로그 파싱 및 정규화| LS[Logstash / Vector]
    LS -->|Bulk 인덱싱| ES[(Elasticsearch 클러스터)]
    ES -->|대시보드 모니터링| KB[Kibana]
    ES -->|EQL 및 Watcher 탐지| AL[Elastic Alerting]
    AL -->|웹훅 제재 요청| GM[게임 운영 / 자동 제재 API]
실시간 탐지 파이프라인 구축 3단계
실시간 어뷰징 탐지 파이프라인은 데이터 수집, 인덱스 모델링, 탐지 규칙 정의의 순서로 구성됩니다.
1단계: 게임 행동 이벤트 스키마 설계 및 인덱스 매핑 최적화
Elasticsearch 8.x 환경에서는 시계열 로그 데이터를 효율적으로 관리하기 위해 Data Streams와 ECS(Elastic Common Schema) 기반의 매핑 구조를 권장합니다. 문자열 필드는 검색 목적에 따라 keyword와 text를 엄격히 분리하고 불필요한 필드는 doc_values 및 index 옵션을 제어하여 저장 공간과 인덱싱 처리량을 최적화합니다.
아래는 작업장 및 어뷰징 탐지를 위한 게임 액션 인덱스 템플릿 예시입니다.
PUT _index_template/game-action-logs-template
{
  "index_patterns": ["game-action-logs-*"],
  "data_stream": {},
  "template": {
    "settings": {
      "number_of_shards": 3,
      "number_of_replicas": 1,
      "index.refresh_interval": "5s",
      "index.codec": "best_compression"
    },
    "mappings": {
      "properties": {
        "@timestamp": { "type": "date" },
        "user_id": { "type": "keyword" },
        "character_id": { "type": "keyword" },
        "session_id": { "type": "keyword" },
        "action_type": { "type": "keyword" },
        "client_ip": { "type": "ip" },
        "hwid": { "type": "keyword" },
        "map_id": { "type": "integer" },
        "location": { "type": "geo_point" },
        "payload": {
          "properties": {
            "target_id": { "type": "keyword" },
            "currency_amount": { "type": "long" },
            "duration_ms": { "type": "integer" },
            "ping_ms": { "type": "short" }
          }
        }
      }
    }
  }
}
[!NOTE]
action_type,user_id,hwid,client_ip는 집계와 필터링의 핵심 키이므로 반드시keyword또는ip타입으로 매핑해야 성능 저하를 방지할 수 있습니다.
2단계: 다계정 군집 및 행동 주기성 탐지 쿼리 작성
단순한 단일 규칙 외에 동일 IP/기기에서 비정상적으로 많은 계정이 접속하거나 동일한 루틴을 수행하는 군집을 탐지하려면 Elasticsearch의 composite 집계 또는 terms 집계를 활용합니다.
동일 IP 대역 내 다계정 동시 파밍 탐지 쿼리
최근 10분간 단일 IP에서 5개 이상의 계정이 접속하여 퀘스트를 완료한 이상 징후를 추출하는 쿼리입니다.
POST game-action-logs-*/_search
{
  "size": 0,
  "query": {
    "bool": {
      "filter": [
        { "range": { "@timestamp": { "gte": "now-10m" } } },
        { "term": { "action_type": "QUEST_COMPLETE" } }
      ]
    }
  },
  "aggs": {
    "suspicious_ips": {
      "terms": {
        "field": "client_ip",
        "min_doc_count": 50,
        "size": 100
      },
      "aggs": {
        "distinct_users": {
          "cardinality": {
            "field": "user_id"
          }
        },
        "filter_multi_account": {
          "bucket_selector": {
            "buckets_path": {
              "unique_accounts": "distinct_users"
            },
            "script": "params.unique_accounts >= 5"
          }
        }
      }
    }
  }
}
EQL(Event Query Language)을 활용한 좌표 텔레포트(Speed Hack) 탐지
연속된 두 이벤트 사이의 이동 거리와 경과 시간을 기반으로 물리적으로 불가능한 속도로 이동한 유저를 탐지할 때는 EQL 시퀀스 쿼리가 탁월합니다.
sequence by user_id with maxspan=2s
  [ game.action where action_type == "PLAYER_POSITION" ] by payload.pos_x, payload.pos_y
  [ game.action where action_type == "PLAYER_POSITION" and payload.distance_moved > 500 ]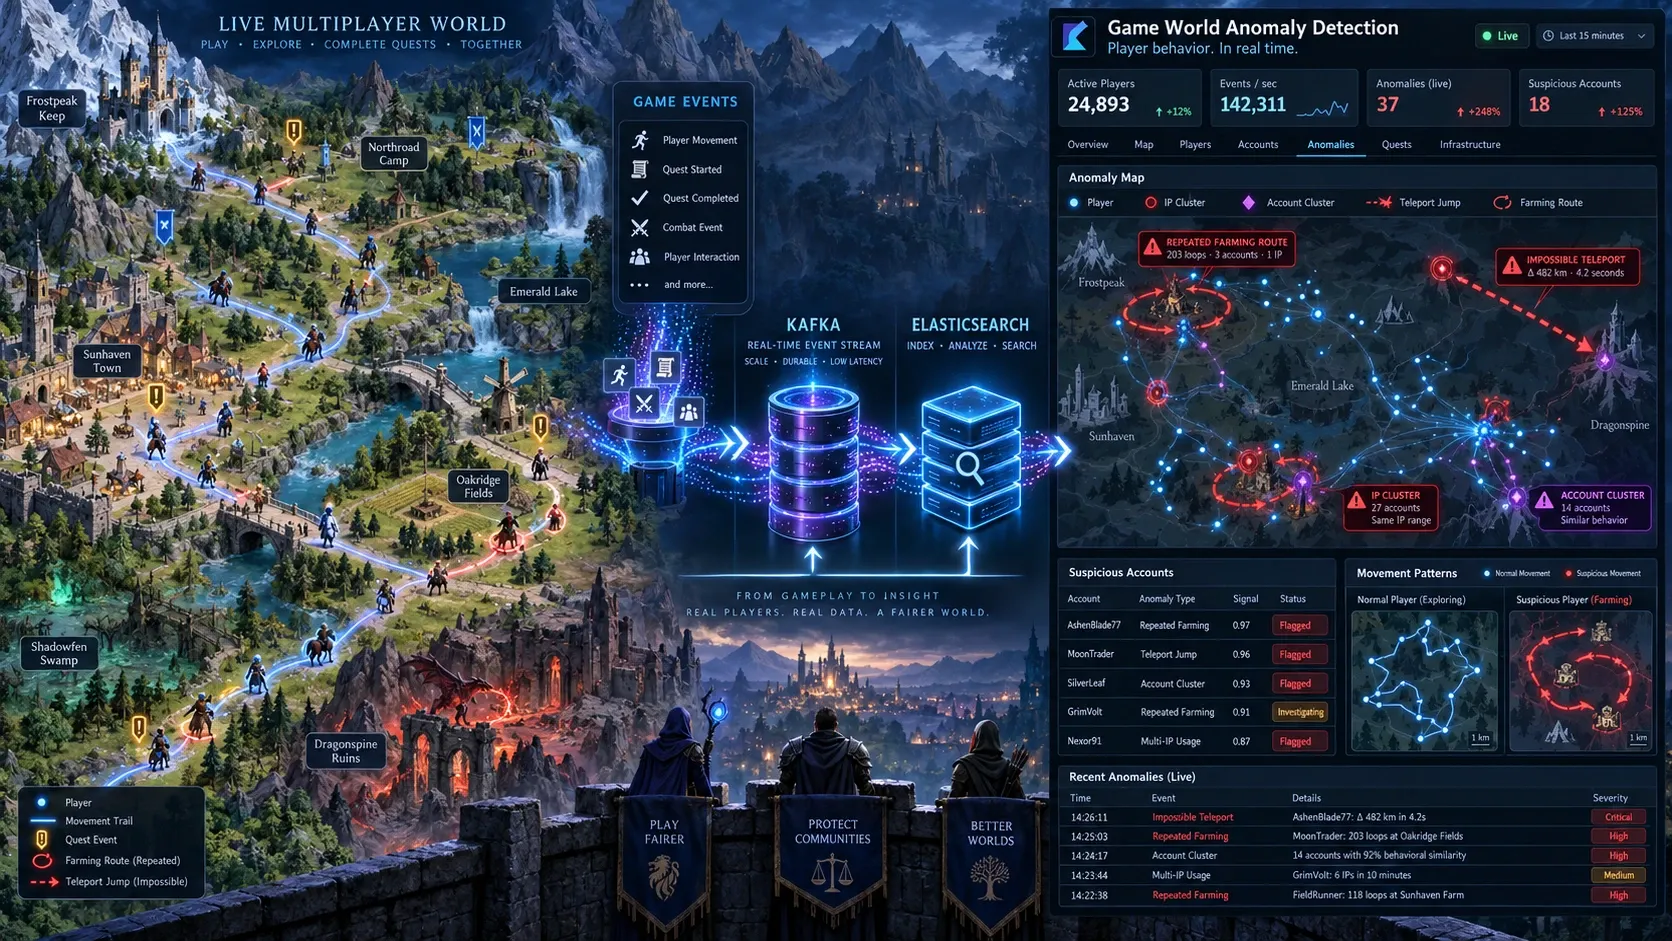
3단계: Kibana Alerting 및 Webhook을 활용한 실시간 자동 제재
집계된 이상 지표는 Kibana의 Alerting Rules(또는 Elasticsearch Watcher)를 통해 외부 제재 API와 연동합니다.
- Trigger 조건 설정: Elasticsearch 집계 결과
distinct_users >= 5를 만족하는 IP 버킷이 반환될 경우 발화(Fire) - Throttling 적용: 동일 대상에 대해 중복 알림이 발생하지 않도록 30분 단위 Throttling 구성
- Webhook Action 호출: 게임 서버의 GM 인증 API 엔드포인트로 의심 대상
user_id목록과 증거 로그 페이로드를 POST 요청으로 전송하여 임시 차단(Shadow Ban) 또는 CAPTCHA 검증 트리거
어뷰징 수치 계산: 행동 엔트로피와 통계적 이상치 판별
정상 유저와 매크로 봇을 가르는 핵심 지표는 행동 간격 시간의 **표준편차()와엔트로피(Entropy)**입니다.
인간 플레이어의 조작 간격 시간()은 정규분포 또는 로그정규분포를 따르며 분산이 크게 나타나지만 단순 스크립트 기반 매크로는 일정한 간격()을 유지합니다.
특정 행동의 간격 표준편차를 기반으로 하는 Z-score 판별식은 다음과 같습니다.
행동 간격 시간의 분산이 극단적으로 0에 수렴()하거나 특정 시간대별 행동 빈도 분포의 샤논 엔트로피()가 임계치 이하로 떨어지면 매크로로 판정합니다.
| 분석 항목 | 정상 플레이어 지표 | 작업장 / 봇 계정 지표 |
|---|---|---|
| 조작 간격 표준편차 () | 고수준 (불규칙한 반응 속도) | 저수준 (수 밀리초 내 오차) |
| 일일 플레이 타임 분포 | 주기적 수면 및 휴식 구간 존재 | 24시간 연속 또는 정시 교대 패턴 |
| IP 당 동시 액티브 계정 수 | 1 ~ 3개 | 5 ~ 수십 개 이상 |
| 재화 흐름 (In/Out) | 획득 및 인게임 소모가 균형 | 획득 후 단일 계정으로 90% 이상 송금 |
Kibana 대시보드 구축과 모니터링 실전 팁
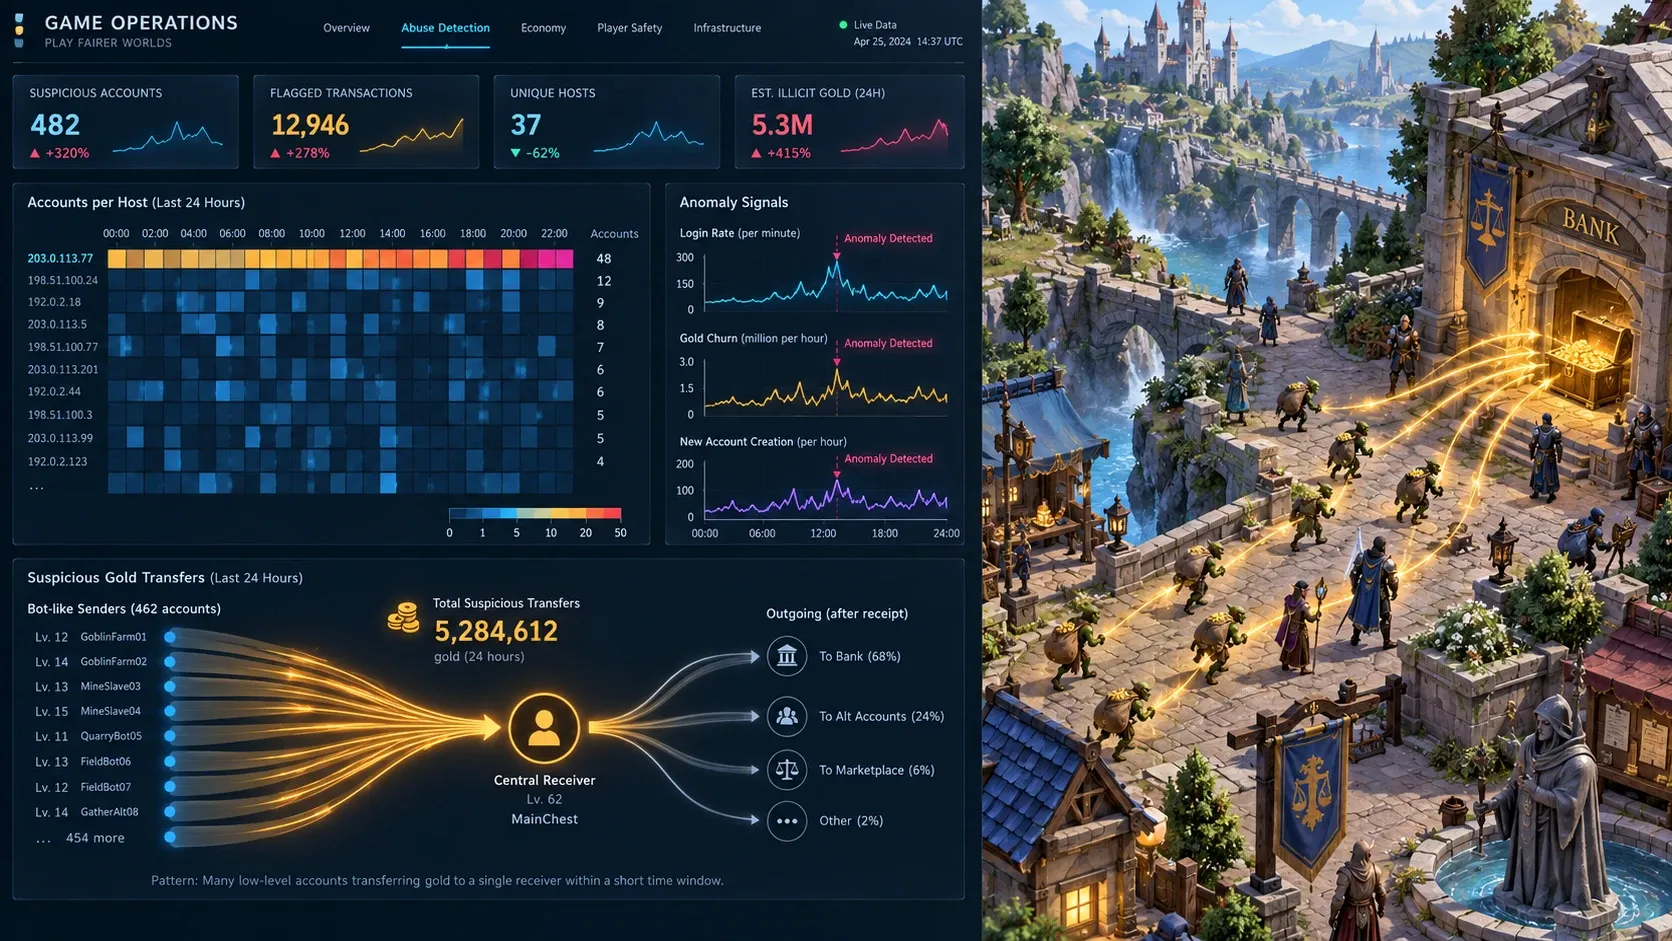
Kibana Lens와 TSVB(Time Series Visual Builder)를 활용하여 다음과 같은 모니터링 패널을 구성하면 운영팀과 보안팀이 즉각적으로 상황을 파악할 수 있습니다.
- IP / HWID별 동시 접속 계정 수 Top 20 Heatmap: 다중 클라이언트를 실행 중인 의심 호스트 식각화
- 재화 거래 플로우 Sankey 다이어그램: 최상위 송금자(Sender)와 수취자(Receiver) 간의 골드 이동 시각화
- 지도 기반 Geo-IP 이상 접속 분산: 비정상적인 VPN/프록시 IP 대역에서의 대량 인입 모니터링
[!TIP]
Elasticsearch의 Machine Learning Anomaly Detection 기능을 활용하면 규칙을 직접 정의하지 않고도 평소 퀘스트 완료 주기나 재화 생산량의 기저선(Baseline)을 자동 학습하여 이상 피크가 발생했을 때 선제적으로 알림을 받을 수 있습니다.
자주 묻는 질문 (FAQ)
Q1. 대용량 로그가 유입될 때 Elasticsearch 클러스터의 인덱싱 지연(Lag)을 줄이려면 어떻게 해야 하나요?
인덱싱 처리량을 극대화하기 위해 다음 설정을 적용해야 합니다.
index.refresh_interval을 기본 1초에서5s~30s로 상향 조정합니다.- 로그 수집기(Logstash, Vector 등)에서
bulk요청 크기를 5MB~15MB(또는 2,000~5,000건) 단위로 배치 처리합니다. @timestamp필드를 기준으로 Data Streams를 적용하고 ILM(Index Lifecycle Management)을 통해 오래된 인덱스를 Hot -> Warm -> Cold 스토리지로 자동 롤오버(Rollover)합니다.
Q2. 정상 유저가 PC방이나 동일 공유기 환경에서 접속하여 오탐(False Positive)될 가능성은 없나요?
단순히 client_ip 단일 조건만으로 제재를 가하면 PC방이나 기숙사 환경의 정상 유저가 오탐될 위험이 높습니다. 따라서 IP뿐만 아니라 hwid(하드웨어 식별자), 캐릭터 생성 시점의 유사성, 퀘스트 동선 일치도, 계정 간 재화 일방 이동 여부 등 최소 3개 이상의 상관 지표(Correlated Metrics)가 동시에 임계치를 초과할 때만 자동 제재를 실행하고 그 외에는 2차 인증(CAPTCHA)이나 수동 검토 큐로 전달하는 다단계 정책을 적용해야 합니다.
Q3. Watcher 대신 Elasticsearch 8.x의 Kibana Alerting을 사용하는 이유는 무엇인가요?
과거에는 복잡한 JSON 기반의 Watcher 스크립트를 직접 작성해야 했으나 Kibana Alerting(Rule & Connector)은 GUI 환경에서 직관적으로 룰을 생성할 수 있고 PagerDuty, Slack, 사내 커스텀 Webhook과의 연결이 표준화되어 있습니다. 또한 인덱스 임계치 룰뿐만 아니라 EQL 룰, ML 이상 탐지 룰을 손쉽게 결합할 수 있어 유지보수 생산성이 크게 향상됩니다.
요약 및 운영 권장사항
게임 서비스가 성장할수록 작업장과 어뷰징의 기법은 정교화됩니다. Elasticsearch와 Kibana 기반의 분석 파이프라인은 정적 룰셋 기반의 차단을 넘어 데이터 기반의 통계적 이상 탐지와 군집 분석을 실시간으로 가능하게 만듭니다.
안정적인 시스템 운영을 위해 초기에는 탐지 룰의 결과를 자동 밴(Ban)으로 즉시 연결하지 말고 탐지 전용 모니터링 모드로 운영하며 2주 이상의 오탐 검증 기간을 거치는 점진적 롤아웃 전략을 권장합니다.