HLSL 컴퓨트 셰이더 기반 텍스처 베이킹: 런타임 스플랫맵(Splatmap) 실시간 합성 기법
지형 및 표면 블렌딩에서 발생하는 다중 텍스처 샘플러 오버헤드를 HLSL Compute Shader와 RWTexture2D 기반 런타임 베이킹으로 최적화하는 원리와 구현 단계를 상세히 정리합니다.
핵심 요약
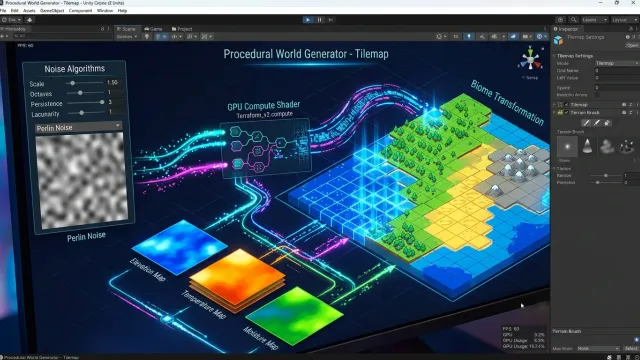
오픈월드 지형이나 대규모 오브젝트 렌더링 시 다중 레이어 텍스처를 픽셀 셰이더에서 실시간으로 직접 블렌딩하면 텍스처 샘플러 슬롯 한계와 픽셀 셰이더 연산 부하가 급증합니다. HLSL 기반 컴퓨트 셰이더(Compute Shader)를 활용해 런타임에 가중치 맵(Splatmap)과 레이어 텍스처를 단일 아틀라스 또는 컴포짓 텍스처로 베이킹(Baking)하면 지형 렌더링 셰이더의 샘플링 횟수를 에서 로 줄여 GPU 대역폭과 프레임 드랍을 획기적으로 개선할 수 있습니다.
런타임 스플랫맵 합성을 왜 컴퓨트 셰이더로 처리해야 할까?
지형(Terrain) 시스템이나 복합 표면 셰이더에서 4개 이상의 레이어(풀, 흙, 자갈, 바위 등)를 표현할 때 가장 흔히 직면하는 병목은 다중 텍스처 샘플링 오버헤드와 하드웨어 샘플러 제한입니다.
전통적인 포워드/디퍼드 픽셀 셰이더에서 8개 레이어를 블렌딩하려면 레이어당 알베도(Albedo), 노멀(Normal), 매스크(Mask) 텍스처를 각각 읽어야 하므로 픽셀당 최소 16~24회 이상의 텍스처 페치(Texture Fetch)가 발생합니다. 이는 모바일 및 콘솔 환경에서 극심한 GPU 대역폭(Bandwidth) 병목과 텍스처 캐시 미스(Texture Cache Miss)를 유발합니다.
flowchart LR
    subgraph Traditional [전통적인 픽셀 셰이더 블렌딩]
        A[8개 레이어 텍스처 세트] --> B[픽셀 셰이더]
        S1[스플랫맵 1/2] --> B
        B -->|픽셀당 24회 샘플링| Out1[최종 렌더 타깃]
    end

    subgraph ComputeBaking [컴퓨트 셰이더 런타임 베이킹]
        L[동적 레이어 텍스처/가중치] --> CS[HLSL Compute Shader]
        CS -->|비동기 1회 연산| RT[합성된 단일 베이크 텍스처]
        RT -->|단 1~2회 샘플링| PS[지형 서피스 셰이더]
        PS --> Out2[최종 렌더 타깃]
    end
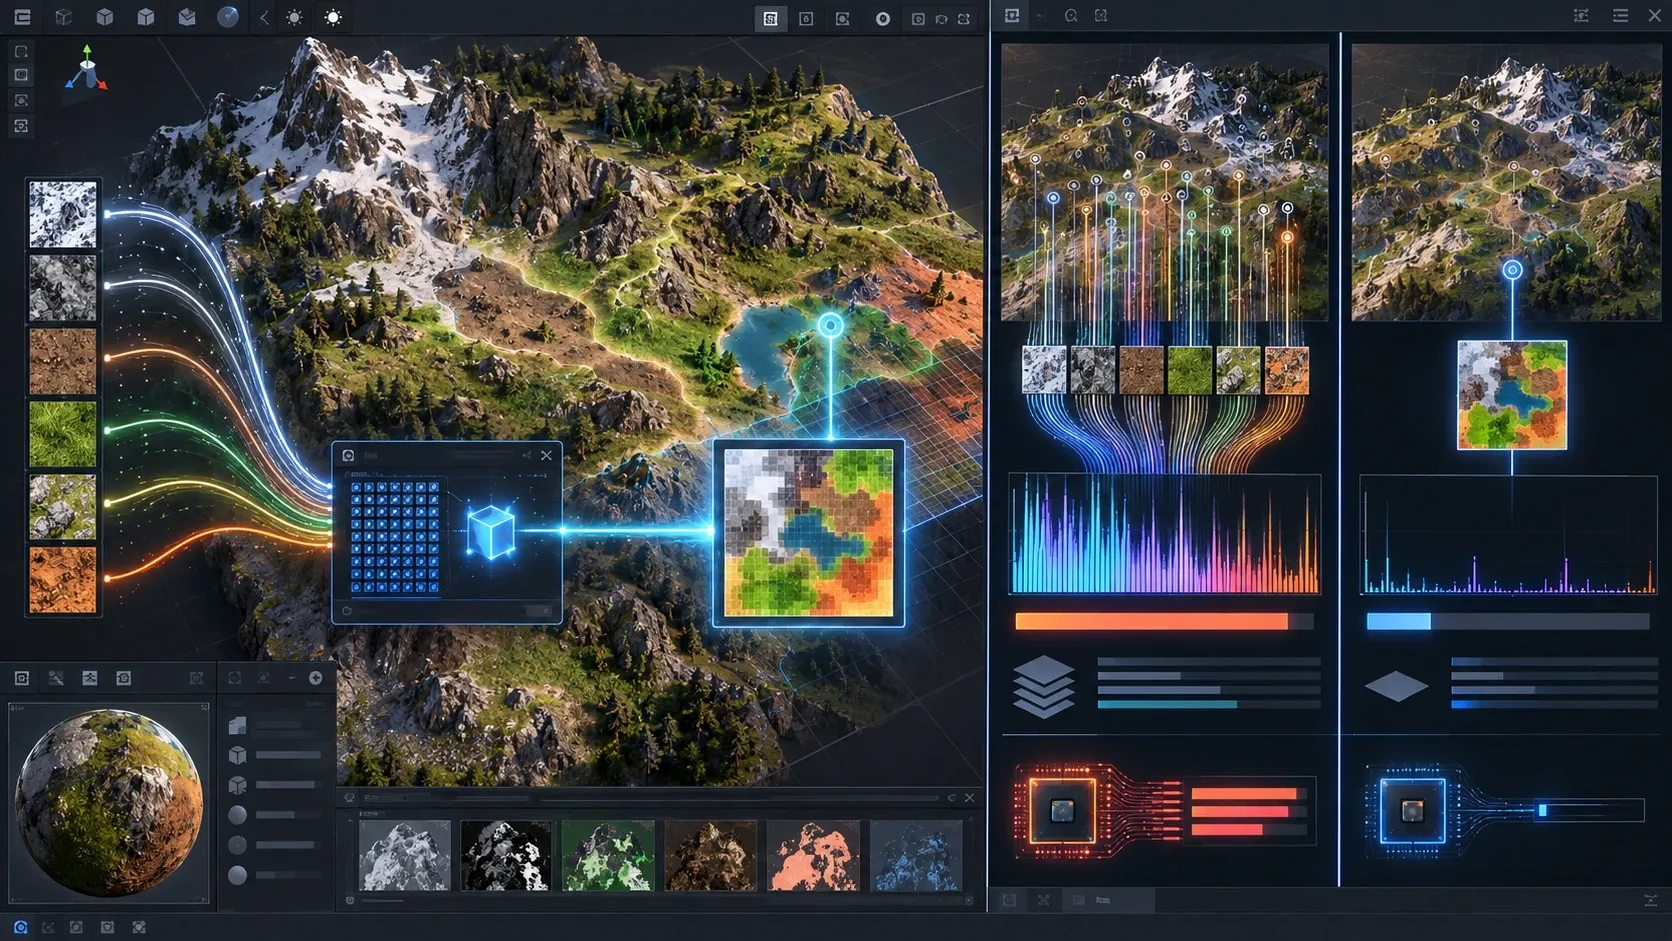
컴퓨트 셰이더를 사용해 변경이 일어날 때만(예: 플레이어 변형 지형, 페인트 인터랙션, 바이옴 전환) 텍스처를 베이킹해 두면 렌더 루프 본선에서는 단일 텍스처 세트만 참조하므로 드로우콜 및 셰이더 실행 비용을 최소화할 수 있습니다.
실시간 스플랫맵 합성의 핵심 수학 원리
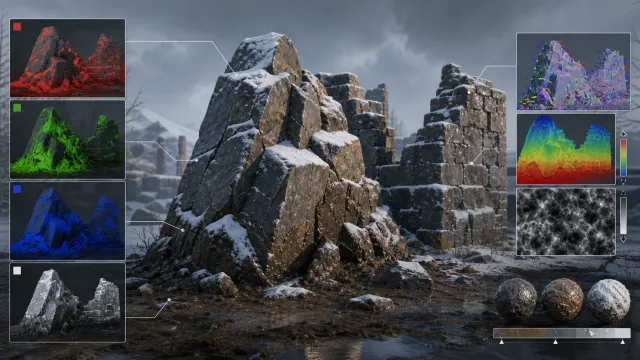
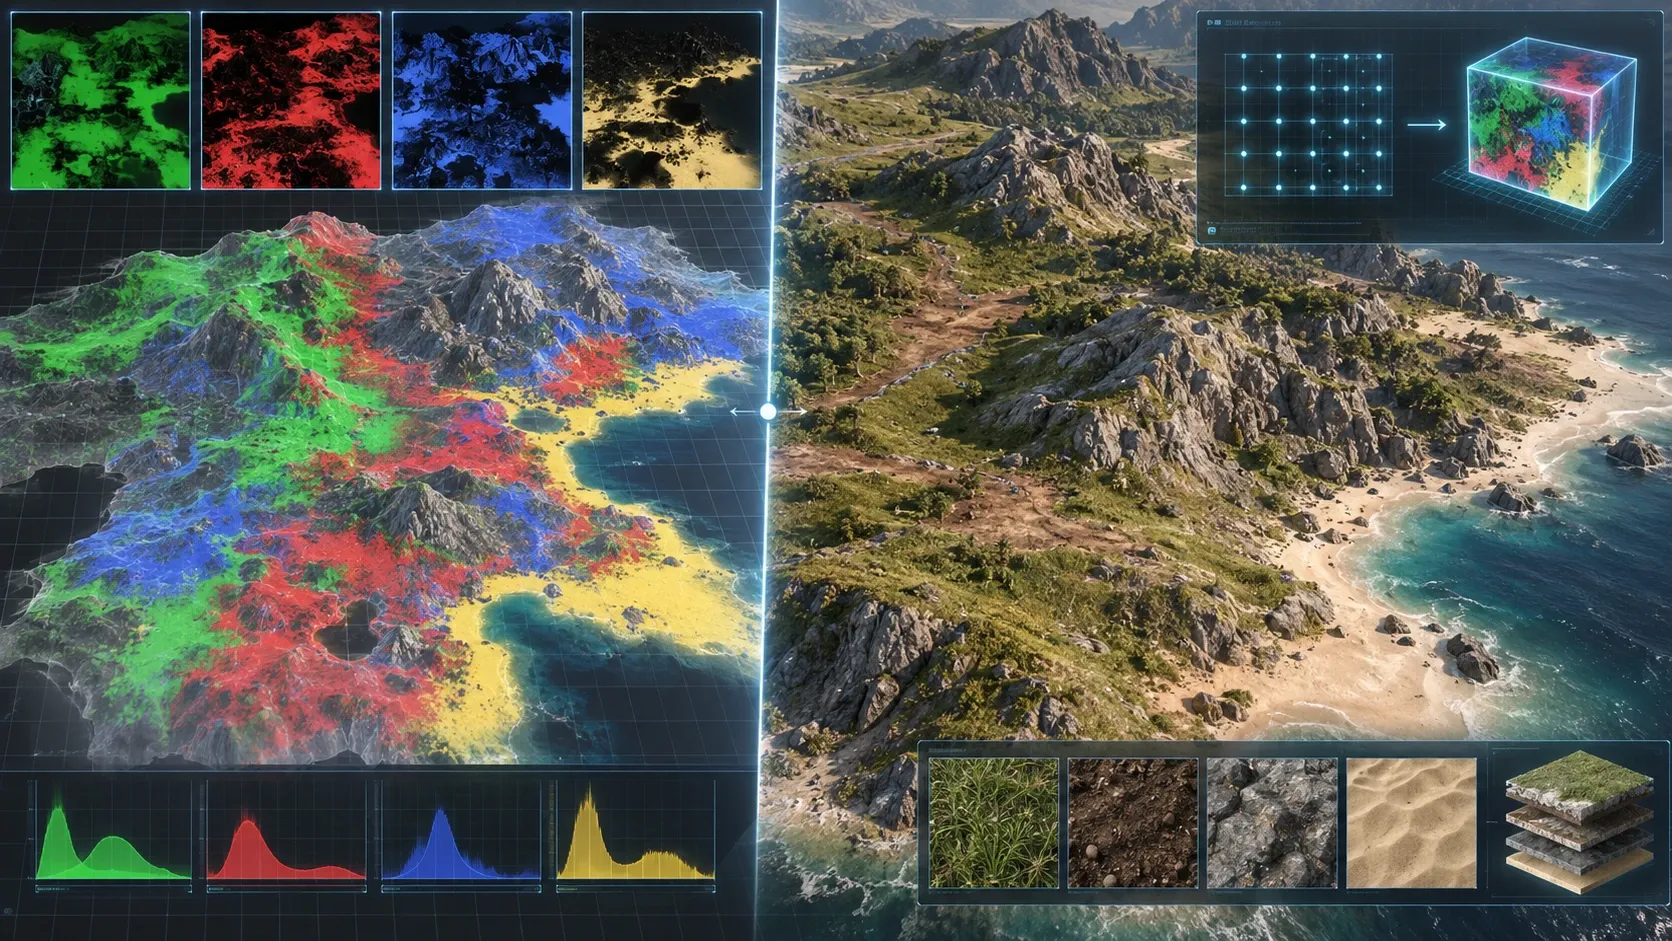
스플랫맵 합성의 핵심은 가중치 정규화(Weight Normalization)와 높이 기반 블렌딩(Height-based Blending)입니다. 단순 선형 보간(Linear Interpolation)은 표면이 뿌옇게 흐려지는 블러링 현상이 발생하므로 높이맵(Heightmap) 데이터를 결합한 콘트라스트 블렌딩을 적용해야 자연스러운 결과를 얻습니다.
1. 가중치 정규화 수식
각 레이어의 초기 가중치를 , 총 레이어 수를 이라고 할 때, 최종 가중치 합이 정확히 1이 되도록 정규화합니다.
여기서 은 제로 디비전(0 나눗셈)을 방지하기 위한 미소값()입니다.
2. 높이 기반 블렌딩 (Height-Transition Blend)
높이맵 와 가중치 를 결합하여 전이 강도 에 따른 보정 높이 점수 를 산출합니다.
레이어 중 최댓값 를 기준으로 전이 임계값 를 설정한 뒤 최종 블렌딩 계수 를 계산합니다.
이 수식을 HLSL 컴퓨트 셰이더의 벡터 병렬 연산으로 구현하면 GPU 상에서 수 밀리초(ms) 이내에 4K 해상도 텍스처를 합성할 수 있습니다.
컴퓨트 셰이더 기반 스플랫맵 베이킹 구현 3단계
실제 프로덕션 환경(Unity/Unreal 대응 HLSL)에서 컴퓨트 셰이더를 작성하고 C# 호스트 스크립트와 연동하는 실무 절차를 살펴봅니다.
1단계: HLSL Compute Shader 커널 작성
RWTexture2D<float4> UAV(Unordered Access View)를 출력 버퍼로 지정하고 스플랫맵 텍스처와 레이어별 소스 텍스처를 읽어 합성하는 커널입니다.
#pragma kernel CS_BakeSplatmap

// 텍스처 및 샘플러 정의
Texture2D<float4> _SplatControlTex;
Texture2D<float4> _Layer0_AlbedoHeight;
Texture2D<float4> _Layer1_AlbedoHeight;
Texture2D<float4> _Layer2_AlbedoHeight;
Texture2D<float4> _Layer3_AlbedoHeight;

SamplerState sampler_LinearClamp;
SamplerState sampler_LinearRepeat;

// 출력 타깃 (UAV)
RWTexture2D<float4> _ResultAlbedo;

// 파라미터
float4 _TextureDimensions; // x: Width, y: Height, z: 1/Width, w: 1/Height
float4 _BlendStrengths;     // 레이어별 전이 강도 (K)

[numthreads(8, 8, 1)]
void CS_BakeSplatmap(uint3 id : SV_DispatchThreadID)
{
    // 텍스처 경계 밖 스레드 얼리 엑싯
    if (id.x >= (uint)_TextureDimensions.x || id.y >= (uint)_TextureDimensions.y)
        return;

    float2 uv = (float2(id.xy) + 0.5) * _TextureDimensions.zw;

    // 1. 스플랫 컨트롤 맵 샘플링 (RGBA = 4개 레이어 가중치)
    float4 weights = _SplatControlTex.SampleLevel(sampler_LinearClamp, uv, 0);

    // 2. 가중치 정규화
    float weightSum = dot(weights, float4(1, 1, 1, 1)) + 1e-5;
    weights /= weightSum;

    // 3. 각 레이어의 Albedo (RGB) 및 Height (A) 샘플링
    float4 col0 = _Layer0_AlbedoHeight.SampleLevel(sampler_LinearRepeat, uv * 4.0, 0);
    float4 col1 = _Layer1_AlbedoHeight.SampleLevel(sampler_LinearRepeat, uv * 4.0, 0);
    float4 col2 = _Layer2_AlbedoHeight.SampleLevel(sampler_LinearRepeat, uv * 4.0, 0);
    float4 col3 = _Layer3_AlbedoHeight.SampleLevel(sampler_LinearRepeat, uv * 4.0, 0);

    // 4. 높이 기반 점수 계산
    float4 scores = float4(col0.a, col1.a, col2.a, col3.a) + weights;
    float maxScore = max(max(scores.x, scores.y), max(scores.z, scores.w));
    float blendThreshold = maxScore - 0.2; // 전이 폭(K) = 0.2

    float4 finalWeights = max(0.0, scores - blendThreshold);
    float finalSum = dot(finalWeights, float4(1, 1, 1, 1)) + 1e-5;
    finalWeights /= finalSum;

    // 5. 최종 알베도 색상 블렌딩
    float3 finalAlbedo = col0.rgb * finalWeights.x +
                         col1.rgb * finalWeights.y +
                         col2.rgb * finalWeights.z +
                         col3.rgb * finalWeights.w;

    // 6. 결과 기록
    _ResultAlbedo[id.xy] = float4(finalAlbedo, 1.0);
}
2단계: 스레드 그룹(ThreadGroup) 배치 최적화
[numthreads(8, 8, 1)]은 그룹당 64개 스레드를 할당하여 NVIDIA Warp(32 스레드) 및 AMD Wavefront(32/64 스레드) 구조 모두에서 높은 점유율(Occupancy)을 달성합니다.- 2048x2048 해상도 텍스처의 경우 가로세로 각각
2048 / 8 = 256개의 스레드 그룹을 디스패치합니다.
3단계: C# 호스트 스크립트 실행 및 Dispatch 제어
호스트 엔진에서 RenderTexture의 enableRandomWrite 속성을 활성화하고 디스패치하는 예제입니다.
using UnityEngine;

public class SplatmapBaker : MonoBehaviour
{
    [SerializeField] private ComputeShader splatComputeShader;
    [SerializeField] private Texture2D splatControlTex;
    [SerializeField] private Texture2D[] layerAlbedoHeights; // 4개 레이어
    [SerializeField] private Material terrainMaterial;

    private RenderTexture bakedAlbedoRT;
    private int kernelIndex;
    private const int TextureSize = 2048;

    void Awake()
    {
        // UAV 바인딩이 가능한 RenderTexture 생성
        bakedAlbedoRT = new RenderTexture(TextureSize, TextureSize, 0, RenderTextureFormat.ARGB32)
        {
            enableRandomWrite = true,
            autoGenerateMips = false,
            filterMode = FilterMode.Bilinear,
            wrapMode = TextureWrapMode.Clamp
        };
        bakedAlbedoRT.Create();

        kernelIndex = splatComputeShader.FindKernel("CS_BakeSplatmap");
    }

    public void BakeTerrainSplatmap()
    {
        // 텍스처 및 변수 전달
        splatComputeShader.SetTexture(kernelIndex, "_SplatControlTex", splatControlTex);
        splatComputeShader.SetTexture(kernelIndex, "_Layer0_AlbedoHeight", layerAlbedoHeights[0]);
        splatComputeShader.SetTexture(kernelIndex, "_Layer1_AlbedoHeight", layerAlbedoHeights[1]);
        splatComputeShader.SetTexture(kernelIndex, "_Layer2_AlbedoHeight", layerAlbedoHeights[2]);
        splatComputeShader.SetTexture(kernelIndex, "_Layer3_AlbedoHeight", layerAlbedoHeights[3]);
        splatComputeShader.SetTexture(kernelIndex, "_ResultAlbedo", bakedAlbedoRT);

        splatComputeShader.SetVector("_TextureDimensions", new Vector4(TextureSize, TextureSize, 1f / TextureSize, 1f / TextureSize));

        // 디스패치 계산 (8x8 스레드 기준)
        int threadGroupsX = Mathf.CeilToInt(TextureSize / 8.0f);
        int threadGroupsY = Mathf.CeilToInt(TextureSize / 8.0f);

        splatComputeShader.Dispatch(kernelIndex, threadGroupsX, threadGroupsY, 1);

        // 머티리얼에 합성된 베이크 텍스처 적용
        terrainMaterial.SetTexture("_MainTex", bakedAlbedoRT);
    }

    void OnDestroy()
    {
        if (bakedAlbedoRT != null)
        {
            bakedAlbedoRT.Release();
            Destroy(bakedAlbedoRT);
        }
    }
}
렌더링 방식별 성능 및 대역폭 비교
동일한 4레이어 지형 렌더링 환경에서 런타임 컴퓨트 셰이더 베이킹 기법과 일반적인 프래그먼트 셰이더 실시간 블렌딩 기법을 비교한 결과입니다.
| 항목 | 기존 픽셀 셰이더 실시간 블렌딩 | Compute Shader 런타임 베이킹 |
|---|---|---|
| 매 프레임 텍스처 샘플링 수 | 12~16회 (Albedo/Normal 4장씩 + Splat) | 1~2회 (Bake된 Albedo/Normal) |
| GPU 픽셀 셰이더 대역폭 부하 | 높음 (High Memory Bandwidth) | 매우 낮음 (Low Memory Bandwidth) |
| 텍스처 샘플러 슬롯 제한 | 레이어가 늘어날수록 하드웨어 제한(16개) 도달 | 단일 텍스처 슬롯만 점유 |
| 베이킹 소요 시간 | N/A (상시 연산) | 2048x2048 기준 0.25~0.6ms (1회 실행) |
| 동적 변형 대응 | 즉시 반영 | 변경 발생 프레임에만 1회 Dispatch |
자주 묻는 질문 (FAQ)
Q1. 매 프레임 Compute Shader를 실행하면 오히려 오버헤드가 발생하지 않나요?
매 프레임 무조건 Dispatch하는 방식은 권장하지 않습니다. 지형 브러시 수정, 동적 날씨 변화에 따른 젖음(Wetness) 맵 업데이트, 바이옴 진입 등 스플랫맵 가중치나 베이스 텍스처가 변경되었을 때만 이벤트 기반(Event-driven)으로 1회 Dispatch해야 최대의 성능 이득을 누릴 수 있습니다.
Q2. 모바일 GPU(Tile-Based Renderer)에서도 원활히 동작하나요?
Vulkan, Metal, OpenGL ES 3.1 이상을 지원하는 최신 모바일 기기에서는 Compute Shader와 RWTexture2D를 사용할 수 있습니다. 다만 메모리를 절약하려면 텍스처 해상도를 1024x1024 수준으로 조정하고 ARGB32 대신 RGB565 또는 R11G11B10Float 포맷을 고려할 수 있습니다.
Q3. 베이킹된 RenderTexture의 밉맵(Mipmap)은 어떻게 처리해야 하나요?
bakedAlbedoRT.useMipMap = true로 설정한 후, Compute Shader 실행 직후 C# 단에서 bakedAlbedoRT.GenerateMips()를 명시적으로 호출해야 합니다. 그렇지 않으면 원거리 지형에서 텍스처 에일리어싱(Aliasing) 및 깜빡임(Shimmering) 현상이 발생합니다.
마치며: 테크니컬 아티스트를 위한 실무 가이드
컴퓨트 셰이더를 활용한 실시간 텍스처 베이킹은 지형 블렌딩뿐 아니라 캐릭터 커스터마이징 텍스처 병합, 데칼(Decal) 합성, 실시간 웨더링(Weathering)에도 응용할 수 있습니다. 셰이더 연산 부하가 픽셀 파이프라인에 집중되어 있다면 범용 연산 파이프라인(GPGPU)으로 분산하는 런타임 베이킹을 고려할 수 있습니다.