AI 맞춤형 튜토리얼 UX: 플레이 성향별 파밍·전투·탐험형 온보딩 설계법
유저의 초기 행동 데이터를 바탕으로 파밍형·전투형·탐험형 성향을 추정하고 목표·보상·안내 강도를 다르게 제공하는 AI 맞춤형 튜토리얼 UX 설계 방법과 측정 지표를 정리합니다.
핵심 요약
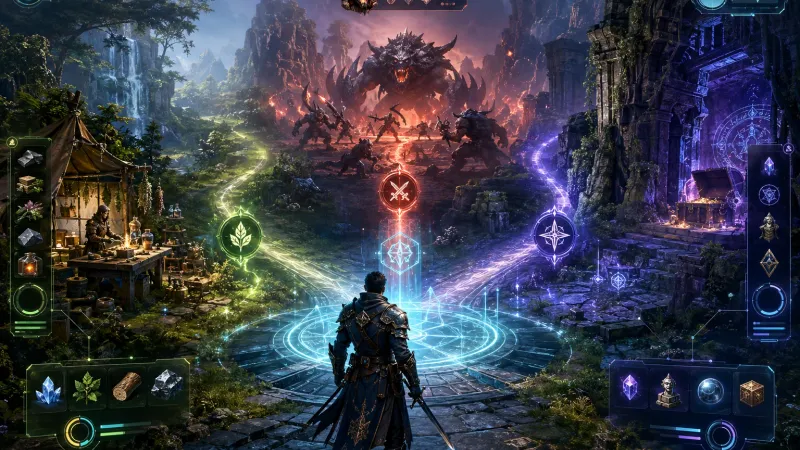
AI 맞춤형 튜토리얼은 모든 유저에게 같은 순서의 설명을 강제하는 대신, 초반 행동 로그로 파밍형·전투형·탐험형 성향을 추정해 다음 목표와 안내 방식을 바꾸는 UX다. 핵심은 성향을 단정하는 것이 아니라 신뢰도에 따라 선택지를 제시하고 완료율·이탈률·자발 행동 지표로 지속적으로 보정하는 데 있다.
왜 획일적인 게임 튜토리얼은 이탈을 만드는가?
튜토리얼의 목적은 조작을 알려주는 데서 끝나지 않는다. 유저가 게임의 핵심 반복 구조를 이해하고 스스로 다음 행동을 선택할 수 있게 만드는 것이 목적이다. 하지만 동일한 순서의 퀘스트는 서로 다른 동기를 가진 유저에게 불필요한 마찰을 만든다.
예를 들어 전투를 선호하는 유저에게 채집 재료 20개를 강제하면 게임의 첫인상이 지루해질 수 있다. 반대로 탐험을 즐기는 유저에게 미니맵 경로만 따라가게 하면 발견의 재미를 제거한다. 여기서 맞춤형 UX는 콘텐츠를 완전히 분기하는 시스템이 아니라 같은 핵심 학습 목표에 도달하는 경로를 다르게 제안하는 설계가 되어야 한다.
| 성향 | 초반 관찰 행동 | 선호할 가능성이 높은 동기 | 튜토리얼 UX 우선순위 |
|---|---|---|---|
| 파밍형 | 채집 노드 반복 상호작용, 제작 메뉴 확인, 재료 보관 | 축적, 효율, 성장 | 제작 루프, 수집 보상, 인벤토리 정리 |
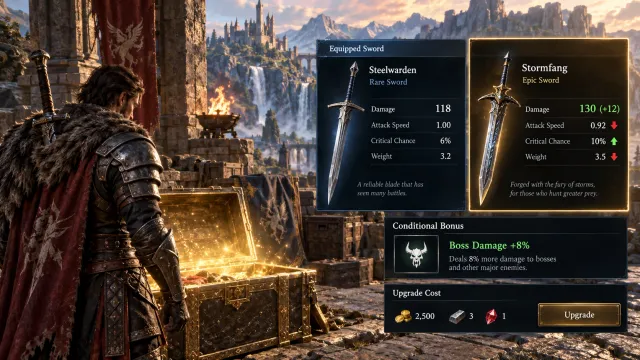
| 전투형 | 적 접근, 전투 재시도, 장비 비교 | 숙련, 승리, 위협 극복 | 전투 피드백, 스킬 연계, 난이도 선택 |
| 탐험형 | 목적지 우회, 시야 밖 이동, 오브젝트 조사 | 발견, 서사, 공간 이해 | 관심 지점, 숨은 보상, 선택 경로 |
플레이 성향은 어떤 데이터로 추정할까?
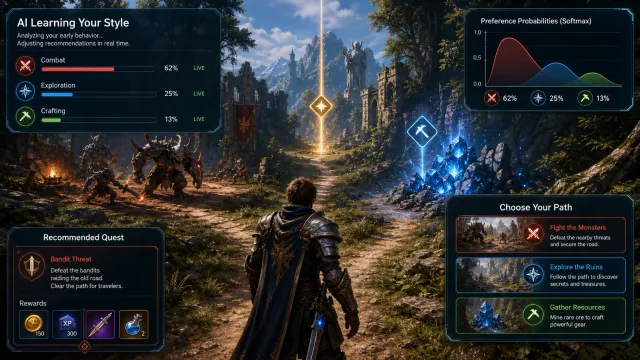
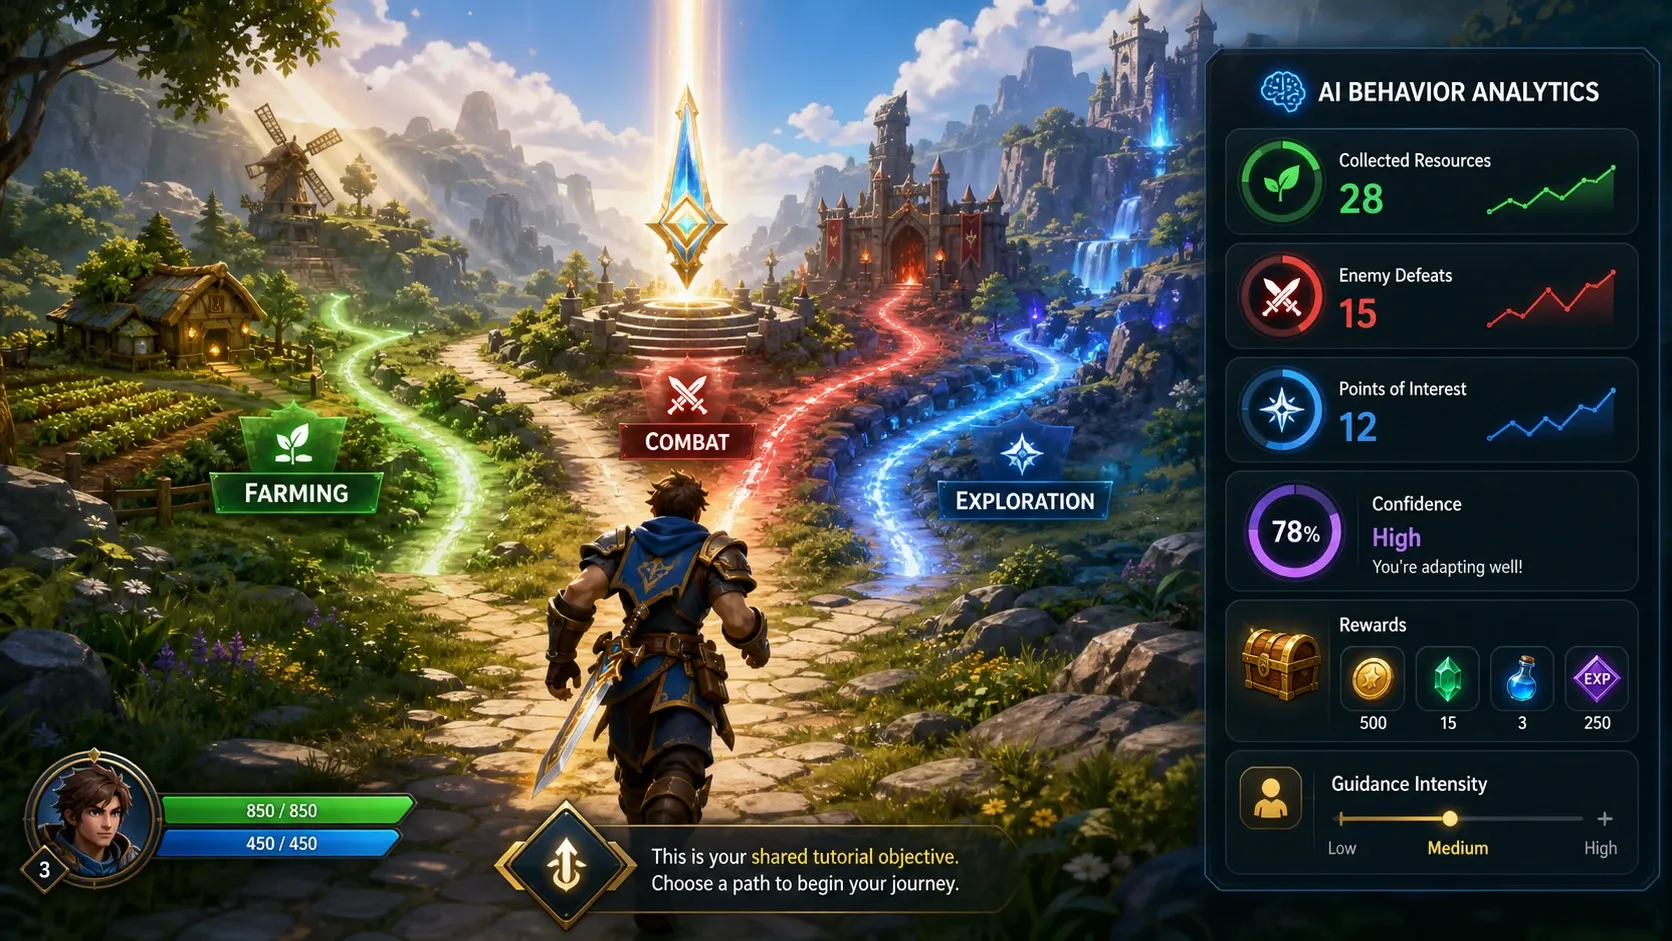
성향 분류는 실제 플레이 로그와 설문 같은 자기보고 자료를 함께 참고할 수 있다. 첫 5~15분의 데이터는 표본이 작으므로 단일 행동 하나로 유저를 고정 분류하면 안 된다. 각 성향에 점수를 누적하고 가장 높은 후보와 신뢰도를 함께 사용한다.
행동 이벤트를 정규화해 성향 점수 만들기
초기 온보딩 구간에서 다음과 같은 이벤트를 수집할 수 있다.
| 이벤트 이름 | 예시 파라미터 | 활용 방식 |
|---|---|---|
resource_collected | resourceId, quantity, zoneId | 수집 빈도와 반복 수집 비율 계산 |
enemy_defeated | enemyType, damageTaken, retryCount | 전투 참여도와 도전 행동 측정 |
poi_discovered | poiType, distanceFromRoute | 권장 경로 이탈과 발견 행동 측정 |
crafting_opened | recipeId, duration | 제작 관심도와 메뉴 탐색 측정 |
tutorial_hint_requested | hintId, context | 안내 필요도와 마찰 구간 파악 |
각 행동의 절대 횟수만 보면 플레이 시간이 긴 유저가 과대평가된다. 따라서 세션 시간 또는 튜토리얼 진행 시간으로 정규화한다.
S_a: 성향a의 정규화 점수w_{a,i}: 행동 이벤트i가 성향a에 기여하는 가중치e_i: 이벤트 발생 횟수 또는 강도t: 관찰 시간(초)
세 성향 점수를 확률처럼 비교하려면 Softmax를 적용할 수 있다.
τ는 점수 차이에 대한 민감도를 조절하는 온도 파라미터다. 초기 데이터에서는 τ를 높여 특정 성향으로 지나치게 쏠리지 않게 하는 편이 안전하다.
AI 맞춤형 튜토리얼 UX는 어떻게 구현할까?
1. 공통 학습 목표와 선택 가능한 경로를 분리한다
먼저 모든 유저가 배워야 하는 공통 목표를 정의한다. 예를 들어 생존 RPG라면 이동, 전투, 회복, 장비 획득, 안전지대 복귀가 공통 목표가 될 수 있다. 이후 목표 달성 방식만 성향별로 변형한다.
| 공통 학습 목표 | 파밍형 경로 | 전투형 경로 | 탐험형 경로 |
|---|---|---|---|
| 회복 아이템 획득 | 약초 3개 수집 후 제작 | 적 처치 보상으로 획득 | 폐허 상자에서 발견 |
| 장비 강화 이해 | 재료 조합으로 강화 | 전투 보상 재료로 강화 | 숨은 제작대에서 강화 |
| 지역 이동 이해 | 자원 밀집 지역 안내 | 전투 구역 안내 | 미발견 관심 지점 안내 |
이 구조라면 콘텐츠 제작 비용을 통제하면서도 유저가 자신의 흥미에 맞는 첫 경험을 얻을 수 있다.
2. 신뢰도 임계값으로 강제 분기를 피한다
최고 점수 성향만 보고 즉시 분기하지 말고 1위와 2위 점수의 차이로 신뢰도를 계산한다.
예를 들어 C < 0.15라면 성향을 확정하지 않고 세 가지 목표 중 하나를 선택하게 한다. C ≥ 0.15일 때는 가장 가능성 높은 경로를 첫 번째 추천으로 배치하되 다른 경로도 닫지 않는다.
public enum TutorialPath { Gather, Combat, Explore, Neutral }

public static TutorialPath SelectPath(float gather, float combat, float explore)
{
    var scores = new[] { gather, combat, explore };
    System.Array.Sort(scores);

    float confidence = scores[2] - scores[1];
    if (confidence < 0.15f)
        return TutorialPath.Neutral;

    if (gather >= combat && gather >= explore) return TutorialPath.Gather;
    if (combat >= explore) return TutorialPath.Combat;
    return TutorialPath.Explore;
}
이 함수에는 앞에서 계산한 세 성향의 Softmax 확률(각 0~1, 합계 1)을 전달한다. 경로 선택의 최소 예시이며, 실제 서비스에서는 점수 원본, 적용한 가중치 버전, 제안 노출 여부, 유저의 수락 또는 거절 이벤트까지 함께 기록해야 분석이 가능하다.
3. 추천의 표현을 ‘명령’이 아니라 ‘제안’으로 설계한다
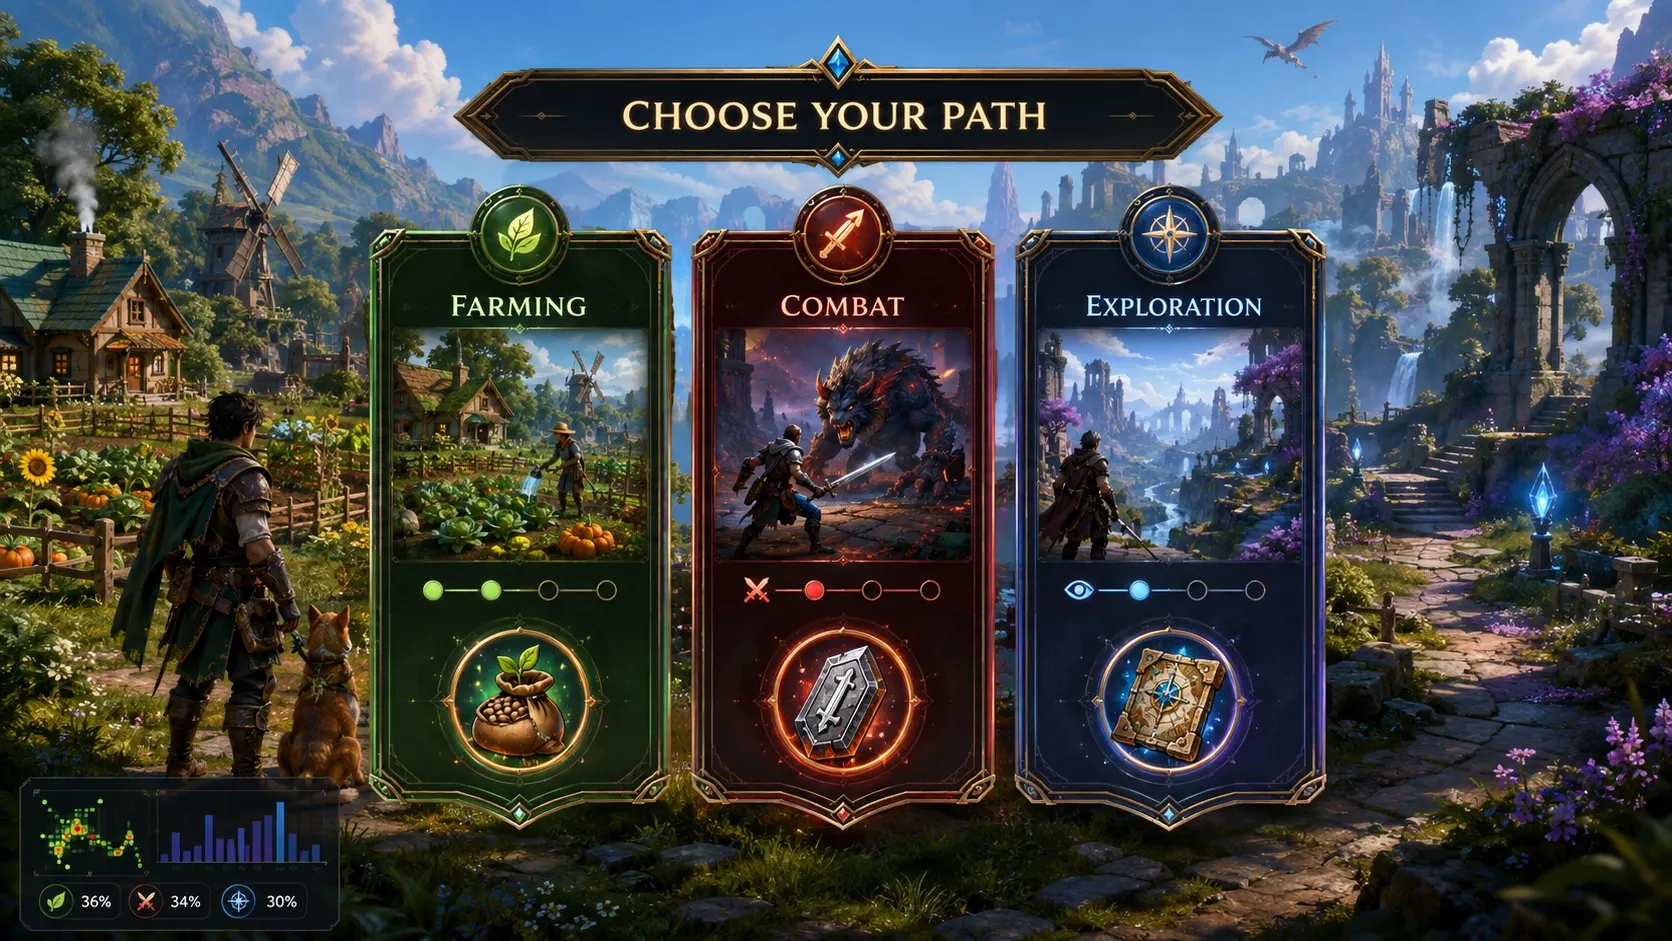
AI가 추정한 성향은 틀릴 수 있다. 따라서 UI 문구는 “당신은 전투형입니다”보다 “전투 도전을 좋아한다면 이 의뢰를 추천합니다”처럼 선택권을 남겨야 한다.
권장 패턴은 다음과 같다.
- 추천 카드에 이유를 짧게 표시한다. 예: “최근 적 8마리를 처치했어요.”
- 추천 외 경로를 동일 화면에 1~2개 함께 노출한다.
- 건너뛰기와 나중에 하기 기능을 제공한다.
- 같은 힌트를 반복 노출하기 전에 최근 무시 횟수를 확인한다.
flowchart TD
    A[초기 플레이 이벤트 수집] --> B[성향 점수 계산]
    B --> C{신뢰도 0.15 이상?}
    C -- 아니오 --> D[선택형 공통 퀘스트 제시]
    C -- 예 --> E[우선 추천 경로 제시]
    D --> F[완료·거절·이탈 로그 기록]
    E --> F
    F --> G[가중치와 추천 규칙 보정]
성향별 튜토리얼 보상은 어떻게 다르게 설계해야 할까?
보상을 성향별로 완전히 다르게 주면 경제 밸런스가 흔들릴 수 있다. 전투형만 강력한 장비를 얻거나 파밍형만 재화를 과도하게 얻는 구조는 곧 최적 경로 강요로 바뀐다. 보상 총가치는 비슷하게 맞추고 보상을 얻는 경험과 즉시 쓰임새를 다르게 구성하는 편이 좋다.
| 성향 | 권장 즉시 보상 | 피해야 할 보상 설계 |
|---|---|---|
| 파밍형 | 제작 재료 묶음, 보관함 슬롯 체험, 제작 레시피 | 재료만 많고 사용처를 알려주지 않는 지급 |
| 전투형 | 무기 시험권, 스킬 포인트, 전투 연습장 해금 | 실패 비용이 큰 강제 보스전 |
| 탐험형 | 지도 조각, 숨은 장소 단서, 외형 수집품 | 길을 하나로 고정하는 자동 길찾기 |
보상 가치를 계산할 때는 재화 가격만 비교하지 말고 이후 30분 내 사용 가능한 비율도 확인해야 한다. 지금 사용할 수 없는 희귀 재료는 초반 유저에게 보상보다 미래의 숙제로 느껴질 수 있다.
맞춤형 튜토리얼의 성과는 무엇으로 측정할까?
튜토리얼 완료율만 높다고 좋은 UX는 아니다. 강제 클릭과 자동 이동을 늘리면 완료율은 오를 수 있지만 이후 플레이 지속에는 도움이 되지 않을 수 있다. 최소한 다음 지표를 함께 본다.
| 지표 | 정의 | 해석 시 주의점 |
|---|---|---|
| 튜토리얼 완료율 | 시작 유저 중 핵심 목표 완료 비율 | 건너뛰기 허용 여부를 분리해 비교 |
| 힌트 의존도 | 힌트 요청 또는 자동 힌트 노출 횟수 | 낮다고 항상 좋은 것은 아님 |
| 자발 행동률 | 안내와 무관한 채집·전투·탐험 행동 비율 | 콘텐츠 배치 변경 영향도 함께 확인 |
| D1 유지율 | 다음 날 재접속 비율 | 유입 채널과 플랫폼별로 분리 |
| 경로 전환율 | 추천 경로에서 다른 경로로 이동한 비율 | 추천 오류 또는 복합 성향 신호일 수 있음 |
실험은 성향별 추천군과 기본 튜토리얼 대조군을 나누는 A/B 테스트로 시작할 수 있다. 신규 유저의 유입 경로, 플랫폼, 언어권, 플레이 세션 길이를 층화하지 않으면 집단 차이가 추천 효과처럼 보일 수 있으므로 주의한다.
자주 묻는 질문 (FAQ)
AI 모델이 꼭 필요한가?
아니다. 초기 버전은 규칙 기반 점수 모델만으로도 충분하다. 로그가 쌓이고 성향 추정 정확도가 검증된 뒤에 클러스터링이나 예측 모델을 도입하는 편이 안전하다.
유저 성향은 한 번 정하면 유지해야 하나?
아니다. 성향은 상황과 진행도에 따라 바뀐다. 튜토리얼에서는 짧은 기간의 선호를 활용하고 이후에는 최근 행동에 더 큰 가중치를 주는 이동 평균 방식으로 갱신하는 것이 좋다.
맞춤형 분기가 많아지면 콘텐츠 제작 비용이 폭증하지 않나?
공통 목표와 결과 보상은 유지하고 퀘스트 진입점·안내 문구·행동 방식만 바꾸면 비용을 제한할 수 있다. 완전히 독립된 세 개의 튜토리얼을 만드는 방식은 초기에 피하는 편이 좋다.
정리
AI 맞춤형 튜토리얼 UX의 핵심은 유저를 세 유형으로 라벨링하는 데 있지 않다. 초기 행동으로 현재의 관심사를 조심스럽게 추정하고 같은 학습 목표를 각자 납득하기 쉬운 경로로 제안하는 데 있다. 규칙 기반 점수, 신뢰도 임계값, 선택권을 남기는 UI, 경제 밸런스를 고려한 보상 그리고 유지율까지 포함한 검증 지표를 함께 설계하면 개인화가 튜토리얼의 압박이 아니라 첫 플레이의 동기가 될 수 있다.