Unity에서 ElevenLabs API로 NPC 실시간 TTS와 입모양 동기화 구현하기
ElevenLabs 스트리밍 TTS를 Unity NPC 대화에 연결하고 문자 타임스탬프로 viseme 입모양을 맞추는 방법을 정리합니다. API 키 보호, 재생 지연, 큐잉과 성능 최적화까지 구현 관점에서 다룹니다.
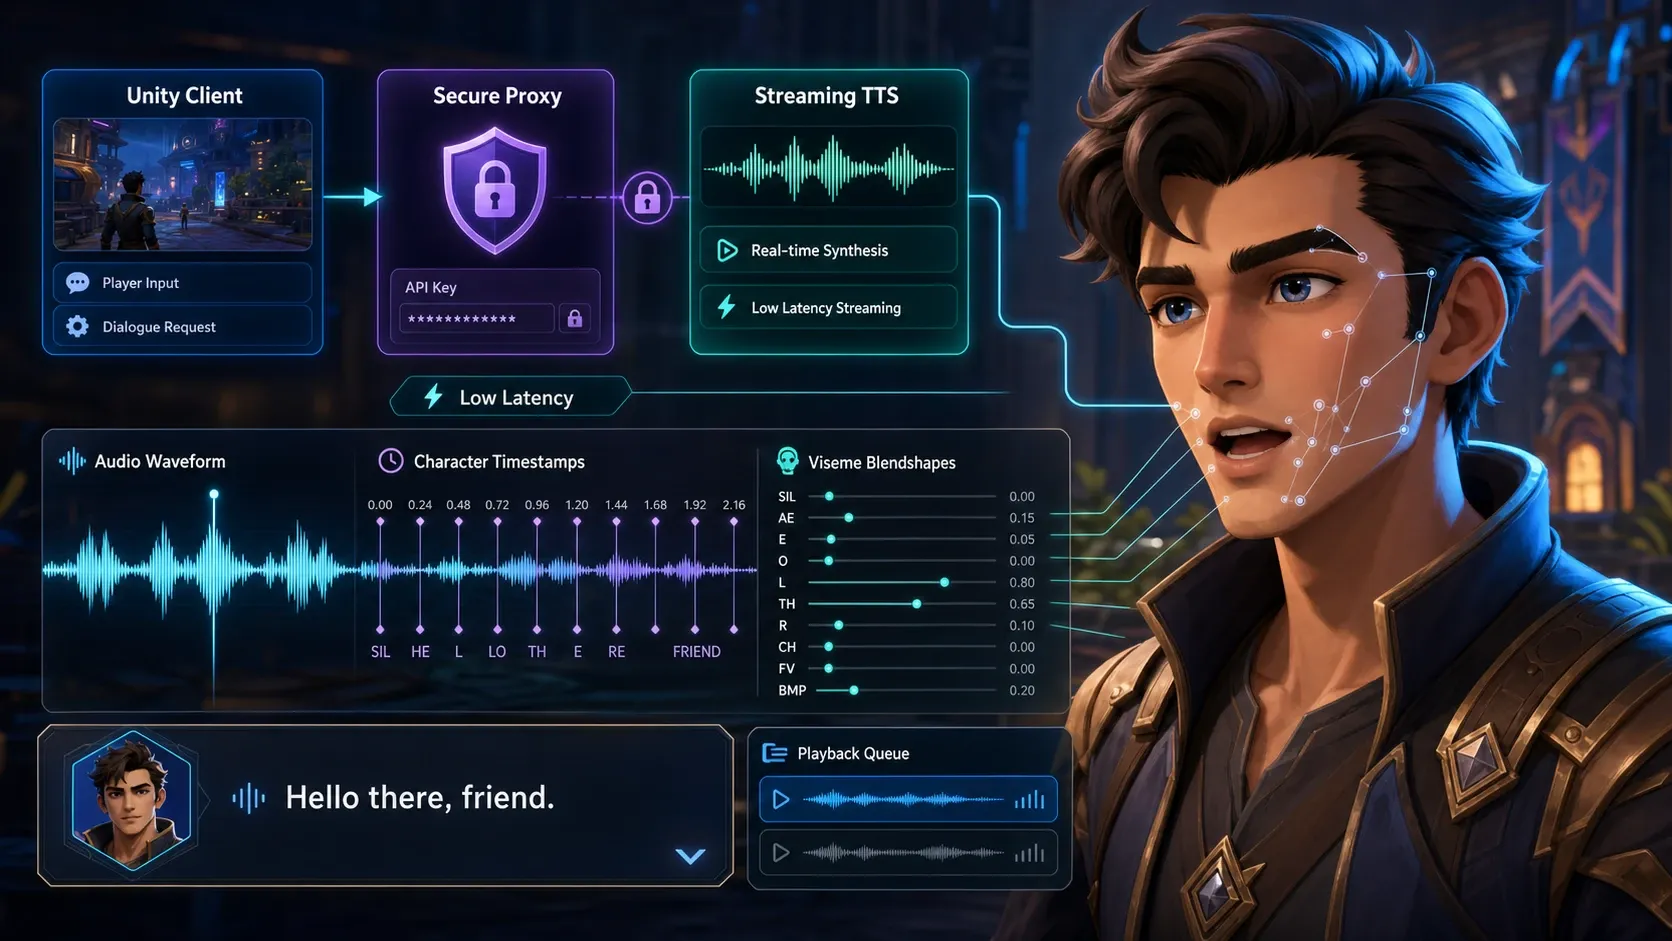
NPC 실시간 음성 합성은 ElevenLabs TTS를 게임 클라이언트에서 직접 호출하는 기능이 아니라 서버 프록시가 음성과 문자별 타임스탬프를 받아 Unity에 전달하는 구조로 구현하는 것이 안전하다. Unity는 AudioSource.time을 기준으로 현재 발화 문자를 찾고 그 문자를 viseme 또는 블렌드셰이프 가중치로 변환하면 음성과 입모양을 같은 시간축에서 동기화할 수 있다.
ElevenLabs 기반 NPC 실시간 TTS 아키텍처
ElevenLabs의 TTS 스트리밍 API는 음성을 생성되는 즉시 전달한다. stream/with-timestamps 엔드포인트는 Base64 오디오와 문자별 시작·종료 시간을 함께 반환하므로 NPC 립싱크의 기준 데이터로 적합하다. 자세한 요청 형식은 ElevenLabs Stream speech with timing API 문서에서 확인할 수 있다.
flowchart LR
    A[Unity NPC 대화 요청] --> B[게임 백엔드]
    B --> C[ElevenLabs TTS with timestamps]
    C --> B
    B --> D[오디오 데이터 + 문자 타임스탬프]
    D --> E[Unity AudioSource]
    D --> F[Viseme Mapper]
    E --> G[NPC 음성 재생]
    F --> H[BlendShape 입모양]
클라이언트에 ElevenLabs API 키를 넣으면 빌드 분석과 프록시 도구로 키가 유출될 수 있다. 따라서 키와 음성 ID 정책은 서버에 두고 Unity에는 짧은 수명의 인증 토큰 또는 게임 서버 세션만 전달한다.
| 책임 | 권장 위치 | 이유 |
|---|---|---|
| ElevenLabs API 키 보관 | 백엔드 | 클라이언트 빌드에서 비밀값을 보호할 수 없음 |
| 대사 검증·길이 제한 | 백엔드 | 비용 폭주와 프롬프트 오남용 방지 |
| 음성 생성 요청·캐시 | 백엔드 | 같은 대사를 재활용하고 공급자 교체가 쉬움 |
| 오디오 재생·입모양 갱신 | Unity 클라이언트 | AudioSource.time으로 렌더링 프레임에 맞춰 처리 |
NPC TTS와 립싱크는 어떻게 구현할까?
1. 서버에서 음성과 타임스탬프를 함께 요청한다
POST /v1/text-to-speech/{voice_id}/stream/with-timestamps를 사용한다. 저지연이 중요한 짧은 NPC 반응에는 eleven_flash_v2_5 같은 저지연 모델을 우선 검토하고 긴 서사 대사에는 음질과 언어 지원을 고려해 모델을 선택한다. 모델별 특성과 스트리밍 전략은 ElevenLabs TTS 개요를 기준으로 확인한다.
서버 요청의 핵심은 다음 세 가지다.
- NPC별
voice_id와model_id를 서버 데이터로 결정한다. - 원문 텍스트와
voice_settings를 전송한다. - 받은 Base64 오디오와
alignment또는normalized_alignment의 문자·시작 시간·종료 시간을 Unity용 DTO로 정리한다.
{
  "text": "어서 오세요. 오늘은 어떤 물건을 찾으시나요?",
  "model_id": "eleven_flash_v2_5",
  "voice_settings": {
    "stability": 0.55,
    "similarity_boost": 0.75,
    "style": 0.0,
    "use_speaker_boost": true
  }
}
대사 원문은 UI 표시용으로 별도 보관한다. ElevenLabs 응답의 문자 배열은 공백과 구두점도 포함할 수 있으므로 자막 인덱스를 단순히 문자열 길이로 맞추지 말고 응답 타임스탬프 자체를 재생 기준으로 사용해야 한다.
2. Unity에서 오디오와 문자 타임스탬프를 받는다
초기 구현에서는 백엔드가 MP3 또는 WAV 파일 URL과 타임스탬프 JSON을 내려주고 Unity가 UnityWebRequestMultimedia.GetAudioClip으로 받아 재생하면 충분하다. 오디오 청크를 즉시 재생하는 완전한 스트리밍은 지연을 더 줄일 수 있지만 압축 포맷 디코딩과 버퍼 관리가 추가로 필요하다.
using System;
using System.Collections;
using System.Collections.Generic;
using UnityEngine;
using UnityEngine.Networking;

[Serializable]
public class CharacterAlignment
{
    public string character;
    public float start;
    public float end;
}

public class NpcSpeechPlayer : MonoBehaviour
{
    [SerializeField] private AudioSource audioSource;
    [SerializeField] private SkinnedMeshRenderer faceRenderer;
    [SerializeField] private int mouthOpenBlendShapeIndex;

    private readonly List<CharacterAlignment> alignment = new();

    public IEnumerator Play(string audioUrl, List<CharacterAlignment> timestamps)
    {
        alignment.Clear();
        alignment.AddRange(timestamps);

        using var request = UnityWebRequestMultimedia.GetAudioClip(audioUrl, AudioType.MPEG);
        yield return request.SendWebRequest();

        if (request.result != UnityWebRequest.Result.Success)
        {
            Debug.LogError($"NPC TTS 다운로드 실패: {request.error}");
            yield break;
        }

        audioSource.clip = DownloadHandlerAudioClip.GetContent(request);
        audioSource.Play();
    }

    private void Update()
    {
        if (!audioSource.isPlaying)
        {
            faceRenderer.SetBlendShapeWeight(mouthOpenBlendShapeIndex, 0f);
            return;
        }

        var current = FindCharacterAt(audioSource.time);
        var weight = ToMouthWeight(current);
        faceRenderer.SetBlendShapeWeight(mouthOpenBlendShapeIndex, weight);
    }

    private string FindCharacterAt(float time)
    {
        foreach (var item in alignment)
        {
            if (time >= item.start && time <= item.end)
                return item.character;
        }

        return string.Empty;
    }

    private static float ToMouthWeight(string character)
    {
        if (string.IsNullOrWhiteSpace(character) || char.IsPunctuation(character[0]))
            return 0f;

        return character[0] switch
        {
            'ㅏ' or 'ㅑ' or 'ㅓ' or 'ㅕ' or 'ㅐ' or 'ㅔ' => 85f,
            'ㅗ' or 'ㅛ' or 'ㅜ' or 'ㅠ' => 55f,
            _ => 35f
        };
    }
}
위 코드는 동작을 검증하기 위한 최소 형태다. 실제 한국어 음절은 초성·중성·종성이 결합된 완성형 문자이므로 가, 나 같은 글자를 그대로 비교해서는 모음 기반 입모양을 정확히 만들 수 없다.
3. 한글 음절을 viseme으로 변환한다
한글 완성형은 유니코드 U+AC00부터 시작하며 중성 인덱스는 아래 식으로 구할 수 있다.
입을 크게 여는 계열, 둥근 입 계열, 닫힌 입 계열처럼 3~5개의 viseme으로 먼저 단순화하면 대부분의 NPC 대화에서 충분히 자연스럽다. 캐릭터가 고품질 얼굴 리그를 갖췄을 때만 ARKit 계열 블렌드셰이프 수를 늘린다.
private static float ToMouthWeight(string character)
{
    if (string.IsNullOrEmpty(character)) return 0f;

    var codePoint = character[0];
    if (codePoint < 0xAC00 || codePoint > 0xD7A3) return 0f;

    var vowelIndex = ((codePoint - 0xAC00) / 28) % 21;
    return vowelIndex switch
    {
        0 or 2 or 4 or 6 or 20 => 90f, // ㅏ, ㅑ, ㅓ, ㅕ, ㅣ 계열
        8 or 12 or 13 or 17 or 18 => 60f, // ㅗ, ㅛ, ㅜ, ㅠ 계열
        _ => 35f
    };
}
문자 단위 타임스탬프는 음소 단위 데이터보다 거칠다. 따라서 각 문자 구간의 앞뒤에 20~40ms 정도의 보간을 두고 Mathf.Lerp로 블렌드셰이프를 변화시키면 입모양이 덜 끊겨 보인다.
실시간 NPC 음성 재생 지연은 왜 발생하는가?
체감 지연은 TTS 모델의 첫 오디오 생성 시간만으로 결정되지 않는다. 대사 생성, 네트워크 왕복, 서버 처리, 오디오 디코딩, Unity 재생 버퍼가 모두 더해진다.
| 지연 원인 | 최소 대응 |
|---|---|
| 대사가 너무 김 | 문장부호 기준으로 1~2문장씩 분할 |
| 매번 새 연결 생성 | 백엔드 HTTP 클라이언트 재사용 |
| 전체 파일 수신 뒤 재생 | 스트리밍 또는 짧은 문장 단위 재생 |
| Unity 다운로드 대기 | 자주 쓰는 인사·반응은 사전 캐시 |
| 대화가 겹침 | NPC별 재생 큐와 취소 토큰 적용 |
정적 퀘스트 대사와 상점 인사말은 빌드 시점 또는 운영 도구에서 미리 생성해 CDN에 두는 편이 가장 싸고 안정적이다. 런타임 TTS는 플레이어 이름, 동적 상태, 생성형 대화처럼 사전 녹음이 불가능한 문장에만 사용한다.
Unity NPC TTS 최적화 체크리스트
- 대사 길이를 제한한다. 짧은 발화는 첫 소리를 빨리 들려 주고 실패 시 재시도 비용도 작다.
- 캐시 키는
voiceId + modelId + normalizedText + voiceSettings의 해시로 만든다. 설정이 다르면 같은 문장도 다른 음성 결과가 될 수 있다. - NPC가 새 대사를 시작하면 이전 요청과 재생을 취소한다. 늦게 도착한 이전 응답이 새 대사를 덮어쓰지 않게 요청 ID를 비교한다.
- 3D NPC 음성은
AudioSource.spatialBlend = 1과 거리 감쇠를 적용하되 립싱크는 거리와 무관하게 로컬 재생 시간으로 계산한다. - 립싱크 갱신은
Update에서 한 NPC당 한 번만 수행한다. 화면 밖 NPC는 입모양 갱신을 멈추거나 낮은 빈도로 줄인다.
자주 묻는 질문 (FAQ)
ElevenLabs API 키를 Unity에 넣어도 되나요?
안 된다. 클라이언트 빌드에 포함된 키는 보호할 수 없다. API 호출은 반드시 백엔드 프록시를 거치고 Unity는 게임 서버가 발급한 인증 정보만 사용해야 한다.
문자 타임스탬프만으로 자연스러운 립싱크가 가능한가요?
가능하다. 대화형 NPC에는 모음 계열 3~5개 viseme과 짧은 보간만으로도 충분한 인상을 준다. 클로즈업 컷신처럼 정밀도가 필요하면 음소 단위 립싱크 데이터나 전용 립싱크 솔루션을 검토한다.
실시간 스트리밍과 미리 생성한 음성 중 무엇을 써야 하나요?
고정 대사는 미리 생성한 파일을 사용하고 플레이어 입력이나 게임 상태에 따라 달라지는 대사만 스트리밍 TTS로 생성하는 혼합 방식이 비용과 지연을 함께 줄인다.
정리
Unity NPC TTS의 핵심은 서버에서 ElevenLabs 음성과 타임스탬프를 함께 받아 AudioSource.time으로 입모양을 구동하는 것이다. 먼저 짧은 대사, 서버 프록시, 문자 기반 viseme 매핑으로 구현하고 실제 플레이에서 지연이나 립싱크 품질이 부족할 때만 청크 재생과 고정밀 음소 분석을 추가한다.