Godot 4 고성능 연산 모듈 제작 가이드: C# 바인딩과 GDExtension 네이티브 연동 최적화
Godot 4에서 대규모 연산 처리를 위해 GDExtension(C++)과 C#을 결합하는 고성능 아키텍처를 소개합니다. 네이티브 메모리 직접 참조와 무복사 버퍼 전달로 마샬링 오버헤드를 극복하는 최적화 기법을 다룹니다.
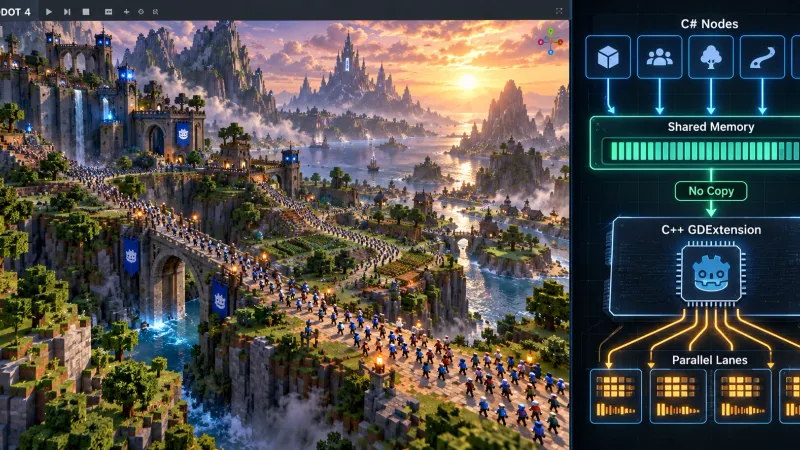
핵심 요약
Godot 4의 대규모 데이터 처리(예: 군집 AI, 절차적 복셀 지형, 유체 시뮬레이션)에서 발생하는 성능 병목은 C#의 GC 부하와 Godot Variant 마샬링 오버헤드에서 비롯됩니다. 핵심 연산 로직을 GDExtension(C++)으로 컴파일하고 Godot 엔진의 범용 바인딩 계층 대신 Direct C ABI P/Invoke 및 **unsafe 메모리 포인터(Zero-Copy)**를 통해 C#과 네이티브 모듈을 직접 연결하면 마샬링 비용 없이 네이티브 SIMD 및 멀티스레딩 성능을 극대화할 수 있습니다.
대규모 게임플레이 연산에서 왜 C#과 GDExtension 조합이 필요한가?
Godot 4는 게임플레이 로직 작성을 위해 고생산성 언어인 C#(.NET 8 기반)을 공식 지원하며 고성능 네이티브 확장을 위해 GDExtension(C/C++/Rust) 인터페이스를 제공합니다.
그러나 수만 개의 파티클 연산, 복셀 메시 생성, 공간 분할 알고리즘처럼 프레임당 수백만 회 이상의 데이터 접근이 필요한 영역에서는 다음과 같은 문제가 발생합니다.
- Godot API 바인딩 오버헤드: C# 스크립트에서 GDExtension으로 등록된
ClassDB메서드를 호출할 때 Godot 내부의Variant변환과 엔진 바인딩 계층을 거치면서 호출 오버헤드가 누적됩니다. - 가비지 컬렉션(GC) 압박: C#에서 대규모 배열을 매 프레임 생성하고 엔진 API로 전달하면 Managed Heap에 가비지가 쌓여 주기적인 프레임 드랍(GC Hitch)이 발생합니다.
- SIMD 및 네이티브 하드웨어 제약: C#에서도
System.Numerics.Vector<T>나System.Runtime.Intrinsics를 지원하지만 특정 플랫폼 전용 컴파일러 최적화나 OpenMP/ISPC 수준의 하드웨어 제어는 C++ 코어에서 훨씬 안정적으로 제어할 수 있습니다.
이러한 한계를 극복하기 위해 게임플레이 및 엔티티 수명 관리는 C#에서 담당하고 CPU 집약적인 무거운 연산 코어는 GDExtension에 둔 뒤 두 계층 간의 데이터를 복사 없이 포인터로 직결하는 아키텍처가 필수적입니다.
flowchart LR
    subgraph Managed["C# Managed Layer"]
        CS_Logic["게임플레이 로직 (.NET 8)"]
        CS_Buffer["NativeMemory / fixed 포인터"]
    end
    subgraph Native["GDExtension C++ Core"]
        CPP_Func["SIMD / OpenMP 병렬 연산 커널"]
        CPP_Memory["Zero-Copy Direct Buffer"]
    end
    CS_Logic -->|1. 메모리 고정 및 포인터 획득| CS_Buffer
    CS_Buffer -->|2. Direct C ABI 호출| CPP_Memory
    CPP_Memory -->|3. 병렬 벡터 연산 처리| CPP_Func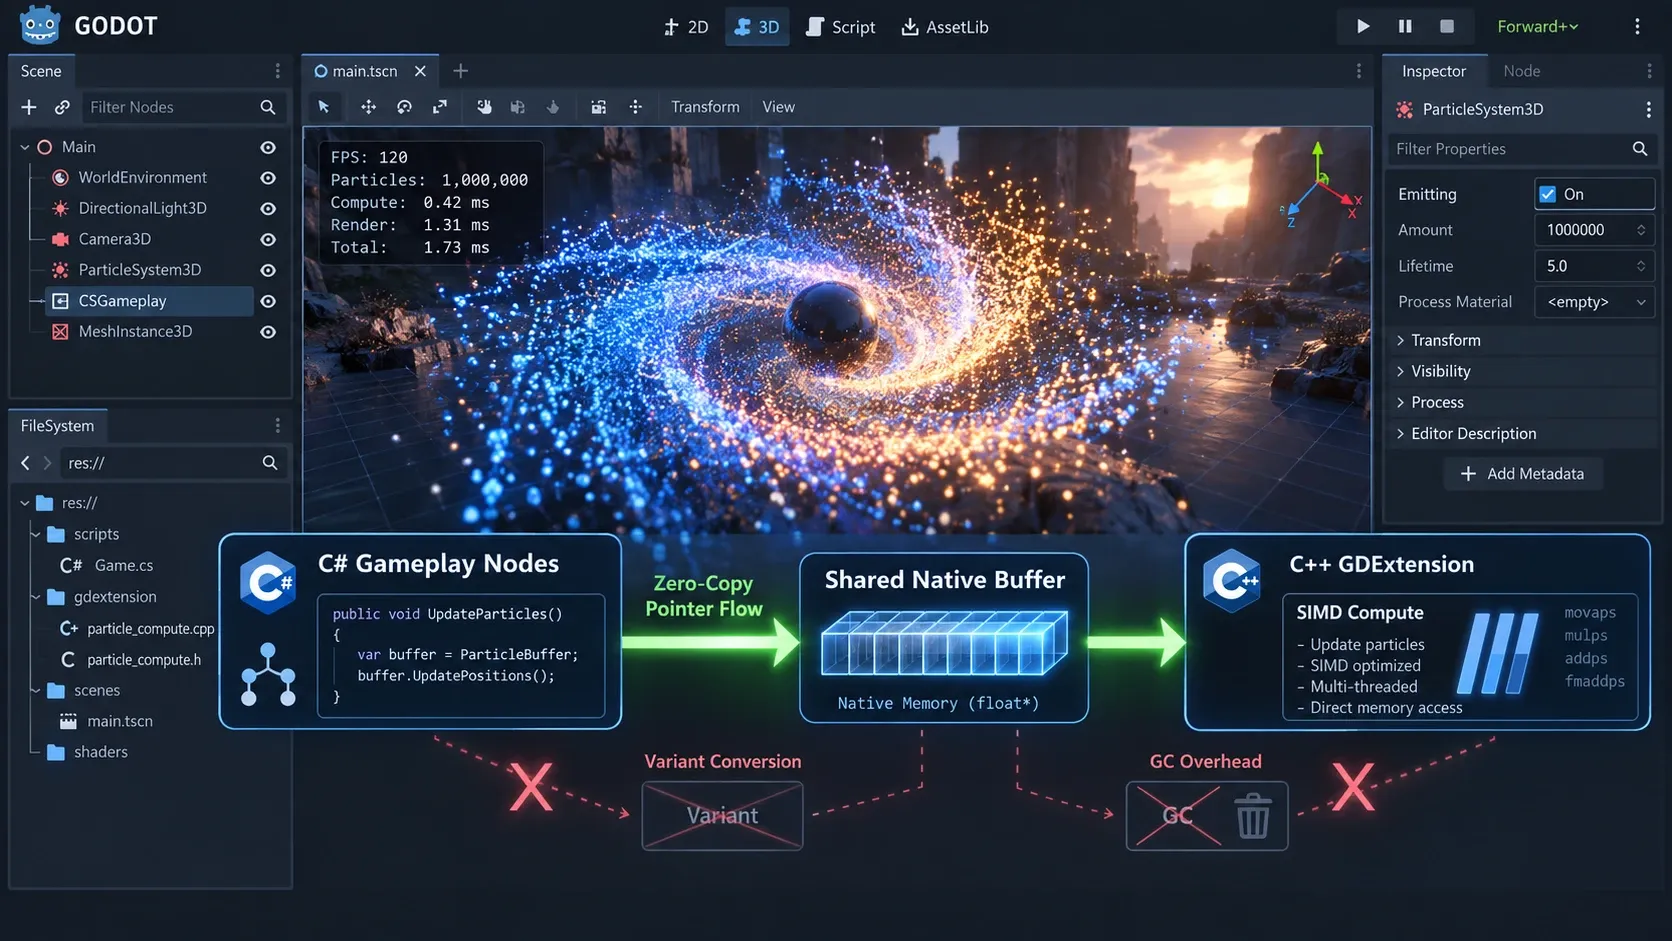
성능 병목을 없애는 C# - GDExtension 연동 3단계 가이드
1단계: GDExtension C++ 연산 코어 및 C ABI 익스포트 구성
GDExtension 프로젝트 내부에서 C#과 통신할 때 Godot의 ClassDB 등록 함수 외에 C linkage(extern "C")로 익스포트된 다이렉트 함수를 함께 정의합니다. 이를 통해 엔진의 마샬링 파이프라인을 완전히 우회할 수 있습니다.
// native_compute.h
#pragma once
#include <godot_cpp/core/class_db.hpp>

struct Vector3Data {
    float x, y, z;
};

struct TransformData {
    Vector3Data position;
    Vector3Data velocity;
};

extern "C" {
    // C#에서 직접 호출할 Direct C ABI 함수
    #if defined(_WIN32)
        #define EXPORT_API __declspec(dllexport)
    #else
        #define EXPORT_API __attribute__((visibility("default")))
    #endif

    EXPORT_API void ExecuteBoidsSimulation(
        TransformData* data,
        int count,
        float delta,
        float neighborRadius
    );
}
// native_compute.cpp
#include "native_compute.h"
#include <immintrin.h> // AVX2 SIMD 지원 시
extern "C" EXPORT_API void ExecuteBoidsSimulation(
TransformData* data,
int count,
float delta,
float neighborRadius
) {
if (data == nullptr || count <= 0) return;
// SIMD 또는 OpenMP를 활용한 고속 병렬 연산 처리
#pragma omp parallel for schedule(static)
for (int i = 0; i < count; ++i) {
data[i].position.x += data[i].velocity.x * delta;
data[i].position.y += data[i].velocity.y * delta;
data[i].position.z += data[i].velocity.z * delta;
// 이웃 에이전트 간 거리 및 회피 연산 (SIMD 가속 로직 포함)
}
}2단계: C# Unsafe P/Invoke 및 NativeMemory 버퍼 제어
C#에서는 동적 라이브러리(Windows: .dll, Linux: .so, macOS: .dylib)에 직접 P/Invoke 바인딩을 걸고 NativeMemory.Alloc 또는 배열의 fixed 포인터를 전달합니다.
// NativeSimulationBridge.cs
using System;
using System.Runtime.InteropServices;

public static unsafe class NativeSimulationBridge
{
    private const string NativeLibName = "bin/libhigh_perf_compute";

    [StructLayout(LayoutKind.Sequential, Pack = 4)]
    public struct Vector3Data
    {
        public float X;
        public float Y;
        public float Z;
    }

    [StructLayout(LayoutKind.Sequential, Pack = 4)]
    public struct TransformData
    {
        public Vector3Data Position;
        public Vector3Data Velocity;
    }

    [DllImport(NativeLibName, EntryPoint = "ExecuteBoidsSimulation", CallingConvention = CallingConvention.Cdecl)]
    public static extern void ExecuteBoidsSimulation(
        TransformData* data,
        int count,
        float delta,
        float neighborRadius
    );
}
3단계: Godot 노드에서 Zero-Allocation 파이프라인 구동
이제 Godot 노드의 _PhysicsProcess 루프에서 관리 힙 할당(Garbage Allocation) 없이 네이티브 연산을 구동합니다.
// CrowdSimulationManager.cs
using Godot;
using System;
using System.Runtime.InteropServices;

public partial class CrowdSimulationManager : Node3D
{
    [Export] public int AgentCount = 50000;
    [Export] public float NeighborRadius = 5.0f;

    private unsafe NativeSimulationBridge.TransformData* _agentData;
    private MultiMeshInstance3D _multiMeshInstance;

    public override unsafe void _Ready()
    {
        // Unmanaged 힙에 직접 메모리 할당 (GC 추적 제외)
        nuint totalBytes = (nuint)(sizeof(NativeSimulationBridge.TransformData) * AgentCount);
        _agentData = (NativeSimulationBridge.TransformData*)NativeMemory.Alloc(totalBytes);

        // 초기화
        var rand = new Random();
        for (int i = 0; i < AgentCount; i++)
        {
            _agentData[i].Position = new NativeSimulationBridge.Vector3Data
            {
                X = (float)rand.NextDouble() * 100f,
                Y = (float)rand.NextDouble() * 10f,
                Z = (float)rand.NextDouble() * 100f
            };
            _agentData[i].Velocity = new NativeSimulationBridge.Vector3Data
            {
                X = ((float)rand.NextDouble() - 0.5f) * 10f,
                Y = 0f,
                Z = ((float)rand.NextDouble() - 0.5f) * 10f
            };
        }
    }

    public override unsafe void _PhysicsProcess(double delta)
    {
        // 1. C++ 네이티브 연산 실행 (복사 없이 포인터 전달)
        NativeSimulationBridge.ExecuteBoidsSimulation(
            _agentData,
            AgentCount,
            (float)delta,
            NeighborRadius
        );

        // 2. 결과를 렌더링용 MultiMesh 버퍼 등에 고속 동기화
    }

    public override unsafe void _ExitTree()
    {
        // 언매니지드 메모리 명시적 해제
        if (_agentData != null)
        {
            NativeMemory.Free(_agentData);
            _agentData = null;
        }
    }
}
네이티브 메모리 직접 공유(Zero-Copy) 및 버퍼 마샬링 기법
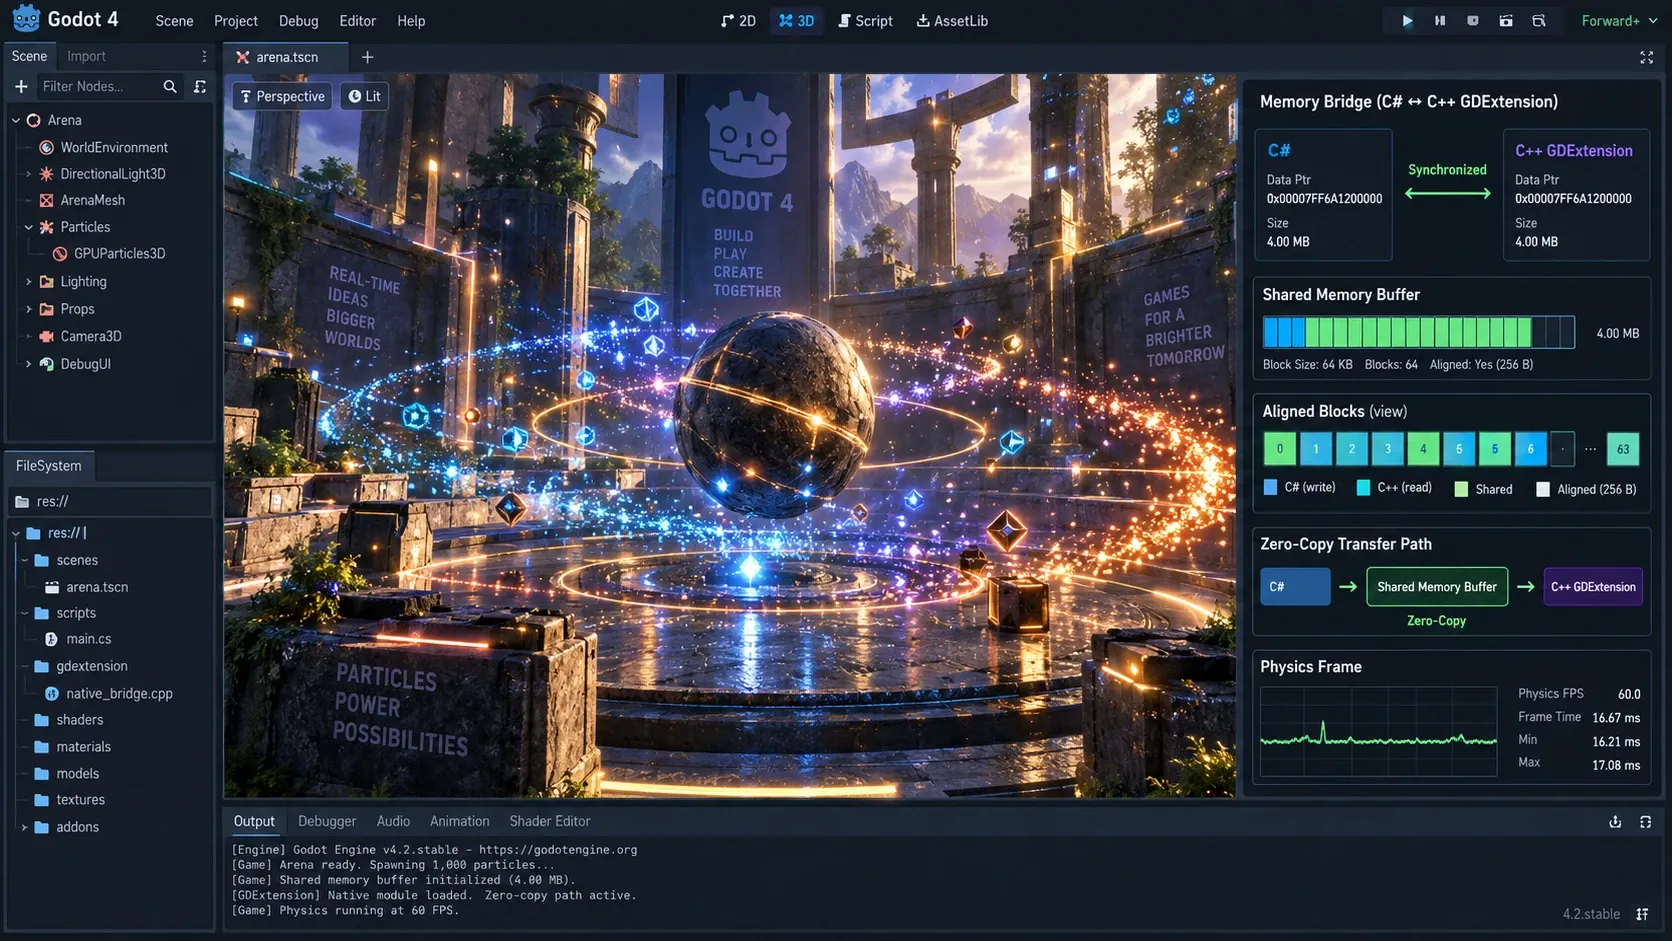
C#과 C++ 간 대용량 데이터를 주고받을 때 구조체 크기와 메모리 정렬(Alignment)이 정확히 일치해야 합니다.
구조체 패킹과 메모리 레이아웃 일치화
C#에서는 [StructLayout(LayoutKind.Sequential, Pack = 4)]를 선언하여 컴파일러가 임의로 구조체 필드 순서를 재배치하거나 패딩을 다르게 넣는 것을 방지합니다. 64비트 플랫폼에서 Vector3(12바이트)를 다룰 때는 16바이트 정렬을 고려해 구조체 크기를 16바이트의 배수로 맞추면 SIMD 벡터화(_mm256_load_ps 등) 시 추가 정렬 패널티 없이 고속 로드가 가능합니다.
연동 방식별 성능 및 장단점 비교
| 연동 방식 | 마샬링 오버헤드 | GC 발생량 | 구현 복잡도 | 적합한 사용 사례 |
|---|---|---|---|---|
| Godot Variant 바인딩 (ClassDB) | 높음 (Variant 래핑/언래핑) | 보통 | 낮음 | 일반적인 엔진 노드 확장, 에디터 도구 |
| Direct C ABI P/Invoke (Unsafe) | 없음 (포인터 직접 전달) | 0 (Zero-Allocation) | 보통 | 군집 시뮬레이션, 물리 서브시스템 |
C# Span<T> / fixed 전달 | 매우 낮음 | 0 (Pinned Array) | 낮음 | 일시적인 버퍼 처리, 오디오 합성 |
자주 묻는 질문 (FAQ)
Q1. GDScript나 순수 C# 스크립트만으로도 멀티스레딩 최적화가 충분하지 않나요?
GDScript는 언어 자체의 인터프리터 오버헤드와 GIL 유사 구조로 인해 대규모 수치 연산에 한계가 있습니다. C#은 Parallel.For나 SIMD API를 지원하지만 Godot 엔진 객체 참조가 섞이거나 비관리 메모리를 세밀하게 제어해야 하는 복잡한 알고리즘에서는 여전히 C++의 네이티브 벡터화 및 컴파일러 최적화(LTO, Auto-vectorization) 대비 약 2~4배의 성능 차이가 발생할 수 있습니다.
Q2. GDExtension ClassDB 노드로 C#에 노출하는 것과 직접 C ABI P/Invoke를 쓰는 것의 차이는 무엇인가요?
ClassDB로 등록된 메서드는 Godot 에디터의 인스펙터, 시그널 시스템, GDScript 바인딩을 온전히 지원하지만 매 호출마다 인자 검증 및 Variant 변환 비용이 발생합니다. 반면 extern "C" 기반의 Direct P/Invoke는 에디터 시각화 기능은 없으나 함수 호출 비용이 나노초(ns) 단위로 줄어들어 프레임당 수만 번 호출되는 고성능 연산에 적합합니다.
Q3. 네이티브 메모리 공유 시 가비지 컬렉터(GC) 메모리 이동 크래시를 방지하려면 어떻게 해야 하나요?
C#의 일반 관리 배열(byte[], struct[])을 C++에 넘길 때는 반드시 fixed 블록을 사용하거나 GCHandle.Alloc(array, GCHandleType.Pinned)를 통해 GC가 메모리 주소를 이동시키지 못하도록 고정해야 합니다. 장기적으로 유지되는 대규모 버퍼의 경우 NativeMemory.Alloc()을 사용하여 GC 힙 바깥(Unmanaged Heap)에 직접 할당하는 것이 가장 안전합니다.
정리 및 최적화 체크리스트
- CPU 집약적인 루프는 GDExtension C++ 코어로 분리했는가?
- C#과 C++ 간 데이터 교환 시
Variant변환을 배제하고 포인터/Direct C ABI를 사용했는가? - 구조체 정의 시
LayoutKind.Sequential과 명시적 패킹을 적용해 메모리 레이아웃을 일치시켰는가? - 프레임 루프 내부에서 Managed Heap 메모리 할당이 완전히 제거(Zero-Allocation)되었는가?
- 할당된
NativeMemory는 노드 해제(_ExitTree) 시점에 안전하게Free되었는가?