FastAPI와 Python으로 구축하는 게임 전용 LLM 미들웨어 서버
FastAPI와 Python으로 게임 클라이언트에서 LLM을 안전하게 호출하는 미들웨어 서버를 구축한다. 세션 검증, 프롬프트 제어, 레이트 리밋, 응답 검증까지 실전 구조로 정리한다.
핵심 요약
게임 클라이언트가 LLM API를 직접 호출하면 API 키 유출, 프롬프트 변조, 비용 폭증을 막기 어렵다. FastAPI 기반 미들웨어 서버를 두고 인증·권한 확인, 게임 상태 정규화, 프롬프트 생성, 레이트 리밋, 응답 스키마 검증을 서버에서 처리하면 LLM 기능을 게임 규칙 안에서 안전하게 운영할 수 있다.
게임 전용 LLM 미들웨어 서버는 왜 필요한가?
NPC 대화, 퀘스트 힌트, 운영 도구처럼 LLM을 쓰는 기능은 일반 웹 챗봇과 요구사항이 다르다. 게임 서버는 플레이어의 세션과 월드 상태를 기준으로 답변 권한을 제한해야 하며 클라이언트가 전달한 데이터를 그대로 신뢰해서는 안 된다.
| 직접 API 호출 | FastAPI 미들웨어 경유 |
|---|---|
| API 키가 클라이언트에 노출될 수 있음 | API 키는 서버 환경 변수에만 보관 |
| 프롬프트와 모델 파라미터를 변조하기 쉬움 | 서버가 허용된 프롬프트와 파라미터만 생성 |
| 호출량·비용 추적이 어려움 | 사용자·기능별 사용량 측정 가능 |
| 게임 상태와 응답의 정합성이 낮음 | 서버가 검증된 상태만 컨텍스트로 제공 |
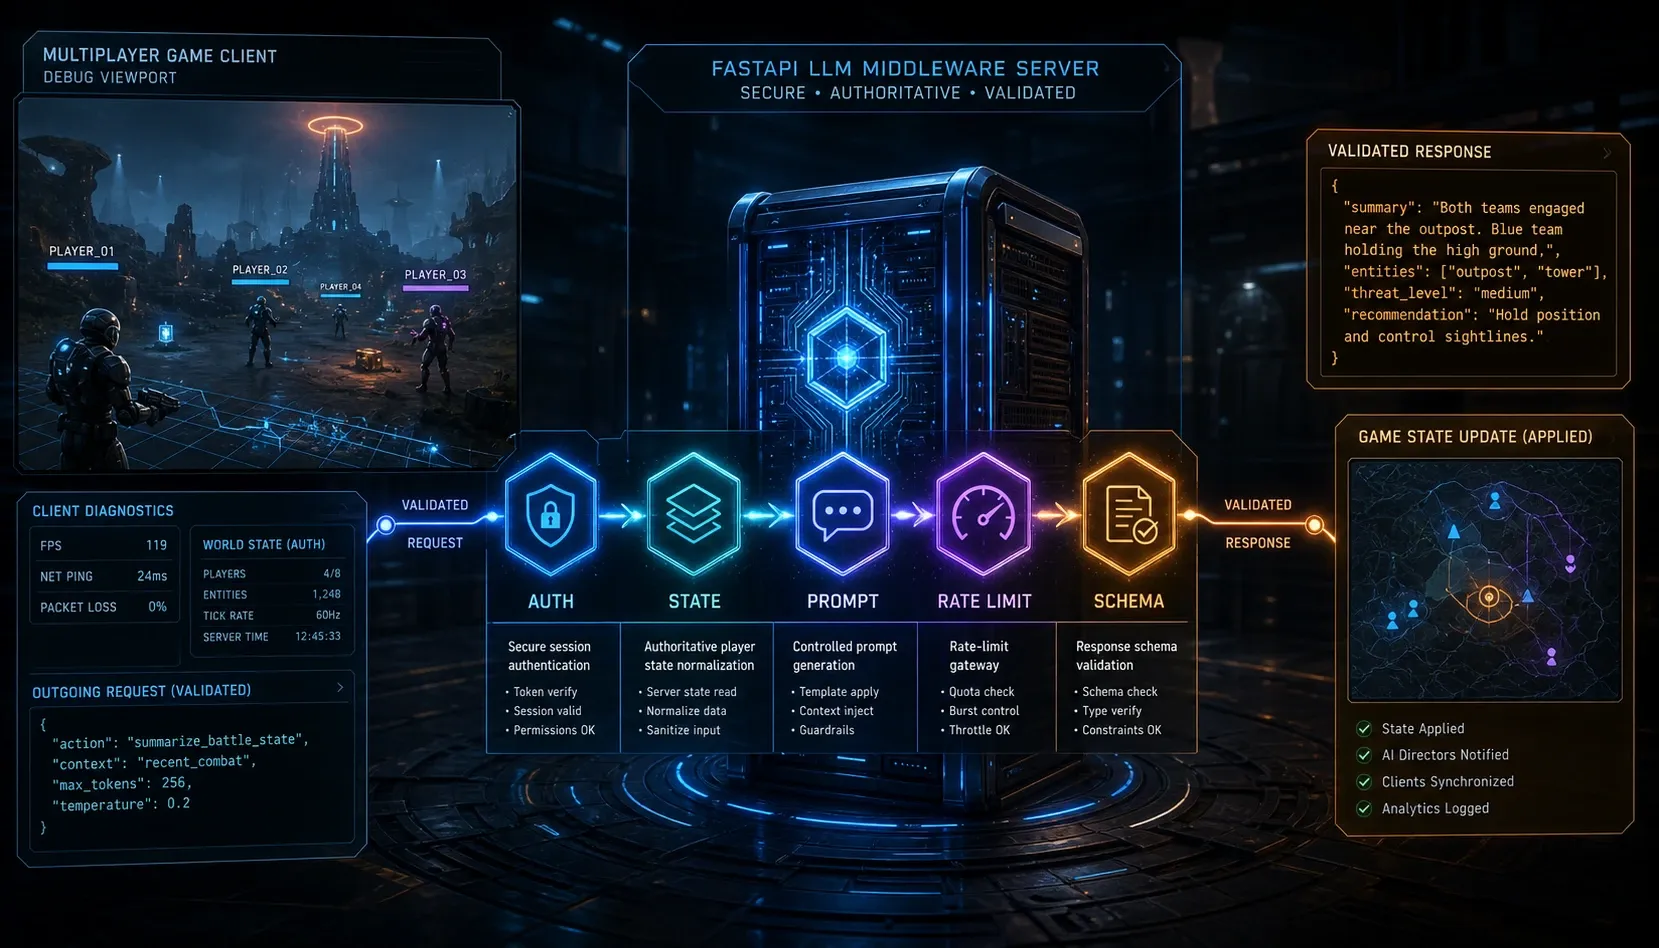
다음 흐름이 최소 구성이다.
flowchart LR
    C[Game Client] -->|JWT, action, payload| F[FastAPI Middleware]
    F --> A[Authenticate and authorize]
    A --> S[Load trusted game state]
    S --> P[Build constrained prompt]
    P --> L[LLM API]
    L --> V[Validate JSON response]
    V --> C
핵심은 클라이언트의 player_level, quest_state 같은 값을 프롬프트에 바로 넣지 않는 것이다. 액세스 토큰에서 사용자 식별자를 확인한 뒤 데이터베이스나 게임 서버가 가진 권위 있는 상태를 읽어야 한다.
FastAPI 기반 게임 LLM API는 어떻게 구현할까?
1. 요청 모델을 작게 고정한다
LLM 요청 API는 범용 prompt 필드보다 게임 행동을 나타내는 열거형을 받는 편이 안전하다. 예를 들어 NPC 대화와 퀘스트 힌트만 지원한다면 다른 기능을 허용하는 자유 입력 인터페이스를 만들 필요가 없다.
from enum import Enum
from pydantic import BaseModel, Field

class LlmAction(str, Enum):
    NPC_DIALOGUE = "npc_dialogue"
    QUEST_HINT = "quest_hint"

class LlmRequest(BaseModel):
    action: LlmAction
    npc_id: str | None = Field(default=None, max_length=64)
player_message: str = Field(default="", max_length=300)max_length는 프롬프트 인젝션을 완전히 차단하는 장치는 아니지만 비정상적으로 큰 요청과 토큰 비용 증가를 줄이는 첫 번째 방어선이다.
2. 신뢰할 수 있는 게임 상태로 프롬프트를 만든다
게임 상태는 인증된 사용자 ID를 기준으로 서버에서 조회한다. 클라이언트가 보낸 값은 표현용 입력으로만 제한한다.
SYSTEM_PROMPT = """당신은 판타지 RPG의 NPC 응답 엔진이다.
규칙:
- 제공된 월드 상태 밖의 사실을 만들지 않는다.
- 퀘스트 미완료 보상이나 관리자 정보를 노출하지 않는다.
- 반드시 JSON 객체만 반환한다.
"""

def build_prompt(action: LlmAction, state: dict, message: str) -> str:
    return f"""action: {action.value}
player_level: {state['level']}
active_quests: {state['active_quests']}
allowed_lore: {state['allowed_lore']}
player_message: {message}

반환 형식:
{{"dialogue":"문자열", "quest_hint":"문자열 또는 null"}}
"""
프롬프트에는 비밀번호, 결제 정보, 운영자 메모, 다른 플레이어의 데이터처럼 기능에 필요 없는 정보를 넣지 않는다. LLM 제공자에게 전달되는 데이터도 서버 로그와 동일한 보안 경계로 취급해야 한다.
3. LLM 응답을 JSON 스키마로 검증한다
모델의 응답은 신뢰할 수 없는 외부 입력이다. JSON 모드나 구조화된 출력 기능을 사용하더라도 Pydantic 검증을 거쳐 게임 클라이언트에 전달한다.
import json
from fastapi import Depends, FastAPI, HTTPException
from pydantic import BaseModel, Field, ValidationError

app = FastAPI()

class LlmResponse(BaseModel):
    dialogue: str = Field(max_length=500)
    quest_hint: str | None = Field(default=None, max_length=300)

@app.post("/v1/game/llm", response_model=LlmResponse)
async def game_llm(request: LlmRequest, player=Depends(require_player)):
    state = await load_game_state(player.id)
    prompt = build_prompt(request.action, state, request.player_message)
    raw_text = await call_llm(system=SYSTEM_PROMPT, user=prompt)

    try:
        return LlmResponse.model_validate(json.loads(raw_text))
    except (json.JSONDecodeError, ValidationError) as error:
raise HTTPException(status_code=502, detail="Invalid LLM response") from errorcall_llm()은 프로젝트에서 사용하는 LLM SDK 호출을 감싸는 얇은 함수면 충분하다. 모델 공급자 교체 가능성을 위해 처음부터 복잡한 추상화 계층을 만들 필요는 없지만 API 키와 호출 코드를 엔드포인트에서 분리하면 테스트와 운영 설정이 간단해진다.
게임 서버에서 LLM 호출 비용과 지연 시간을 어떻게 제어할까?
LLM은 일반적인 게임 RPC보다 느리고 비용도 요청량에 비례한다. 실시간 전투 판정처럼 즉시성과 결정성이 필요한 경로에는 사용하지 말고 NPC 대화·힌트·비동기 콘텐츠 생성처럼 지연을 허용할 수 있는 기능에 한정한다.
| 항목 | 권장 정책 | 이유 |
|---|---|---|
| 타임아웃 | 5~15초 | 장시간 대기와 연결 점유 방지 |
| 사용자 제한 | 분당 요청 수 제한 | 악의적 반복 호출과 비용 폭증 방지 |
| 최대 출력 | 기능별 토큰 상한 | 응답 길이와 비용 예측 가능 |
| 캐시 | 동일 퀘스트 힌트에 짧은 TTL | 중복 호출 감소 |
| 재시도 | 일시 오류에만 1회 | 장애 증폭 방지 |
레이트 리밋 키는 IP만 쓰지 말고 player_id와 기능명을 함께 사용한다. NAT 환경에서는 여러 정상 사용자가 하나의 IP를 공유할 수 있고 계정 단위 제한이 게임 경제와 비용을 더 잘 보호한다.
async def check_rate_limit(player_id: str, action: LlmAction) -> None:
    key = f"llm:{action.value}:{player_id}"
    count = await redis.eval(
        "local n = redis.call('INCR', KEYS[1]); "
        "if n == 1 then redis.call('EXPIRE', KEYS[1], ARGV[1]); end; "
        "return n",
        1,
        key,
        60,
    )
    if count > 10:
        raise HTTPException(status_code=429, detail="LLM request limit exceeded")
이 예시는 Lua 스크립트 안에서 Redis의 INCR와 첫 요청의 EXPIRE를 함께 실행하는 분당 10회 제한이다. 명령을 따로 보내면 첫 증가와 만료 설정 사이에 프로세스가 중단되어 키가 만료되지 않을 수 있다. 실제 서비스에서는 Redis 장애 시 정책도 정해야 한다. 비용 보호가 우선이면 차단하고 NPC 대화의 가용성이 우선이면 제한적으로 통과시키되 관측 로그를 남긴다.
LLM 미들웨어 서버에서 반드시 기록할 운영 지표는 무엇인가?
원문 프롬프트와 응답을 무조건 저장하면 개인정보와 민감한 게임 데이터를 불필요하게 쌓을 수 있다. 우선 요청 식별자, 사용자 식별자 해시, 기능명, 모델명, 지연 시간, 입력·출력 토큰 수, 성공 여부를 구조화해 기록한다.
{
  "request_id": "req_01",
  "player_id_hash": "sha256:...",
  "action": "quest_hint",
  "model": "configured-model-name",
  "latency_ms": 842,
  "input_tokens": 286,
  "output_tokens": 91,
  "status": "success"
}
이 데이터로 기능별 비용, 오류율, p95 지연 시간, 사용자당 호출량을 확인할 수 있다. 품질 분석 때문에 원문이 필요하다면 별도 동의·보존 기간·접근 권한 정책을 적용하고 인증 토큰과 개인 식별 정보는 마스킹한다.
자주 묻는 질문 (FAQ)
게임 클라이언트에서 LLM API를 직접 호출해도 되는가?
권장하지 않는다. API 키 노출과 프롬프트 변조를 막기 어렵다. 게임 서버 또는 FastAPI 미들웨어가 LLM 공급자 호출을 대행해야 한다.
LLM 응답을 게임 데이터베이스에 바로 저장해도 되는가?
바로 저장하지 않는다. JSON 스키마 검증, 길이 제한, 금칙어·권한 검사를 거친 뒤 저장한다. 경제 수치나 아이템 지급처럼 결정적인 상태 변경은 LLM이 아닌 게임 규칙 코드가 담당해야 한다.
NPC 대화 응답을 캐시해도 되는가?
가능하다. 플레이어 상태와 퀘스트 단계가 같은 경우에만 캐시 키에 포함하고 짧은 TTL을 적용한다. 개인화가 중요한 대화는 캐시 범위를 좁히는 편이 낫다.
정리
FastAPI 게임 전용 LLM 미들웨어의 역할은 단순 프록시가 아니다. 인증된 플레이어 상태를 바탕으로 프롬프트를 제한하고 호출량과 비용을 통제하며 모델 출력을 검증해 게임 규칙 안으로 되돌리는 보안 경계다. 먼저 NPC 대화나 퀘스트 힌트처럼 실패해도 게임 상태가 손상되지 않는 기능 하나에 적용한 뒤 지표와 운영 정책이 안정되면 범위를 넓히는 것이 안전하다.