Asset Lock Queue 운영법: 대용량 바이너리 에셋 잠금 대기시간으로 아티스트 병목 찾기
대용량 바이너리 에셋의 잠금 대기시간을 측정하고 Asset Lock Queue를 운영해 아티스트 병목을 찾는 방법을 설명합니다. 지표 설계부터 알림, 우선순위, 예외 처리와 주간 회고까지 Perforce Helix Core 협업 환경에 적용할 수 있는 실무 절차를 정리합니다.
핵심 요약
대용량 바이너리 에셋의 잠금 대기시간은 아티스트가 실제 작업하지 못한 시간을 보여주는 핵심 협업 지표입니다. requested_at, granted_at, released_at 이벤트를 수집해 대기시간과 점유시간을 분리하면 병목이 발생한 에셋 유형, 시간대, 작업자, 파이프라인 단계를 찾을 수 있습니다. 이후 우선순위 규칙, 오래된 잠금 알림, 주간 회고를 Asset Lock Queue에 연결하면 일정과 작업 흐름을 함께 개선할 수 있습니다.
Asset Lock Queue란 무엇인가?
Asset Lock Queue는 동시에 수정할 수 없는 에셋에 대해 잠금 요청과 대기 상태를 기록하고 관리하는 운영 체계입니다. PSD, FBX, Blender 파일, Unreal Engine의 .uasset, Unity의 대형 씬 또는 바이너리 패키지처럼 텍스트 병합이 어렵거나 사실상 불가능한 파일에 특히 유용합니다.
Git LFS, Perforce Helix Core, 사내 에셋 관리 도구 중 어떤 시스템을 사용하든 핵심은 동일합니다. 잠금 자체보다 다음 세 시각을 일관되게 기록하는 것이 중요합니다.
| 이벤트 | 필수 시각 | 의미 |
|---|---|---|
lock_requested | requested_at | 아티스트가 에셋 잠금을 요청한 시각 |
lock_granted | granted_at | 실제로 수정 권한을 얻은 시각 |
lock_released | released_at | 작업자가 잠금을 반환한 시각 |
대기열에는 에셋 경로만 저장하지 말고 작업자, 변경 목적, 우선순위, 파일 크기, 에셋 유형, 관련 태스크 ID를 함께 기록해야 합니다. 그래야 특정 파일 하나의 문제가 팀 전체의 병목인지 또는 특정 제작 단계의 구조적인 문제인지 구분할 수 있습니다.
잠금 대기시간은 왜 아티스트 병목을 보여주는가?
잠금 대기시간은 작업자가 작업을 시작하고 싶었지만 다른 작업자의 잠금 때문에 진행하지 못한 시간입니다. 반면 잠금 점유시간은 실제 편집 또는 검수 작업이 진행되는 동안 권한을 보유한 시간입니다. 두 지표를 섞으면 원인을 잘못 판단할 수 있습니다.
예를 들어 대기시간은 짧지만 점유시간이 길다면 잠금 충돌보다 작업 범위가 너무 크거나 검수·내보내기 과정이 느린 상황일 수 있습니다. 대기시간의 p95가 특정 에셋 유형에서만 높다면 해당 파일의 분할 기준이나 제작 순서를 재검토해야 합니다.
| 관찰 결과 | 가능성이 높은 원인 | 운영 대응 |
|---|---|---|
| 평균과 p95 대기시간이 모두 높음 | 잠금 수요가 처리 용량보다 많음 | 에셋 분할, 동시 작업 슬롯, 인력 배치 검토 |
| 평균은 낮고 p95만 높음 | 특정 파일의 장기 잠금 또는 예외 작업 | 오래된 잠금 알림과 예외 사유 기록 |
| 대기시간은 짧고 점유시간이 높음 | 작업 범위가 크거나 검수 과정이 느림 | 태스크 세분화와 자동 검증 도입 |
| 특정 시간대에만 대기시간 증가 | 리뷰, 빌드, 배치 작업이 집중됨 | 작업 시간 분산과 예약형 처리 도입 |
| 특정 작업자 뒤에 요청이 몰림 | 공유 에셋의 소유권 또는 승인 병목 | 담당자 분산과 명확한 승인 규칙 설정 |
평균값만 보고 판단하지 않는 것이 중요합니다. 한두 건의 장기 대기가 평균을 왜곡할 수 있으므로 p50, p90, p95를 함께 보고 대기 요청 건수와 차단된 작업자 수도 확인해야 합니다.
어떤 잠금 이벤트를 수집해야 하는가?
최소 이벤트 모델은 다음과 같이 설계할 수 있습니다.
| 필드 | 설명 | 운영 목적 |
|---|---|---|
request_id | 잠금 요청을 식별하는 ID | 이벤트 연결과 중복 제거 |
asset_path | 저장소 기준 에셋 경로 | 충돌 파일 식별 |
asset_type | psd, fbx, uasset 등 | 유형별 병목 비교 |
asset_size_bytes | 요청 당시 파일 크기 | 대용량 파일 영향 분석 |
requester | 잠금을 요청한 작업자 | 작업자별 대기 편차 확인 |
current_holder | 현재 잠금 보유자 | 해소 책임자 확인 |
task_id | Jira, Linear 또는 사내 태스크 ID | 일정과 잠금 연결 |
priority | 일반, 긴급, 릴리스 차단 등 | 큐 정렬 기준 |
requested_at | 요청 시각 | 대기시간 계산 시작점 |
granted_at | 승인 시각 | 대기시간 계산 종료점 |
released_at | 반환 시각 | 점유시간 계산 종료점 |
reason | 수정, 리뷰, 임포트, 충돌 해결 등 | 병목 원인 분류 |
시각은 모든 도구에서 UTC로 저장하거나 하나의 기준 시간대로 통일해야 합니다. 클라이언트의 로컬 시각을 그대로 기록하면 서머타임이나 작업자 지역 차이 때문에 순서가 뒤바뀔 수 있습니다. 이벤트가 중복 수집될 수 있으므로 request_id와 이벤트 종류를 조합한 고유 키를 두는 것도 좋습니다.
잠금 시스템이 대기열을 직접 제공하지 않는다면 다음 소스에서 이벤트를 조합할 수 있습니다.
- Perforce Helix Core:
p4 opened,p4 fstat결과와 체크아웃 래퍼 또는 서버 트리거 로그 (p4 opened, p4 fstat) - Git LFS 기반 도구: 잠금 요청·해제 API 로그와 CI의 충돌 실패 기록 (Git LFS File Locking API)
- Unreal Engine 또는 Unity 파이프라인: 에셋 관리 플러그인의 체크아웃 이벤트와 임포트·검수 로그
- 사내 파일 서버: 파일 핸들 또는 잠금 서비스 로그와 작업 관리 도구의 태스크 ID
파일 시스템의 단순 수정 시각만으로는 잠금 대기시간을 복원하기 어렵습니다. 잠금 요청이 발생한 순간에 이벤트를 만드는 래퍼나 플러그인을 두는 편이 정확합니다.
Asset Lock Queue를 어떻게 구현할까?
1단계: 요청과 잠금 획득을 분리해 기록한다
사용자가 버튼을 눌렀을 때 lock_requested를 기록하고 실제 권한 획득이 완료되면 lock_granted를 기록합니다. 요청과 승인이 같은 로그에 들어가면 대기시간이 0으로 계산되는 오류가 생깁니다.
상태는 다음처럼 단순하게 유지할 수 있습니다.
| 상태 | 전환 조건 |
|---|---|
queued | 잠금 요청은 접수됐지만 다른 잠금이 존재함 |
granted | 잠금 획득에 성공함 |
working | 아티스트가 수정 작업 중임 |
released | 잠금이 정상 반환됨 |
expired | 정해진 시간 동안 heartbeat가 없어 운영자가 해제함 |
cancelled | 요청자가 작업을 취소함 |
잠금 보유 상태를 주기적으로 확인하는 heartbeat를 추가하면 자리를 비운 작업과 프로그램 종료를 구분하기 쉽습니다. 다만 heartbeat가 끊겼다고 즉시 강제 해제하면 저장 중인 파일이 손상될 수 있으므로 grace_period, 마지막 저장 시각, 담당자 확인 절차를 함께 둬야 합니다.
2단계: 우선순위와 서비스 수준을 정한다
큐가 있어도 모든 요청을 먼저 들어온 순서로만 처리해야 하는 것은 아닙니다. 릴리스 차단 에셋과 일반 수정 요청을 같은 줄에 세우면 일정 리스크가 커질 수 있습니다. 다만 긴급 요청이 반복되면 일반 요청이 영구적으로 밀릴 수 있으므로 우선순위별 최대 대기시간과 승인자를 명시해야 합니다.
| 우선순위 | 사용 조건 | 권장 운영 규칙 |
|---|---|---|
| 릴리스 차단 | 빌드 또는 출시 검증을 막는 경우 | 태스크 ID와 승인자 필수 |
| 일정 중요 | 마일스톤 경로에 있는 에셋 | 담당 프로듀서 또는 리드 확인 |
| 일반 | 계획된 제작·수정 작업 | FIFO를 기본값으로 적용 |
| 실험 | 테스트용 또는 비긴급 변경 | 피크 시간대 후순위 처리 |
초기에는 팀의 기존 데이터를 기준으로 기준선을 만드세요. 예를 들어 최근 2주간 일반 요청의 p95가 18분이었다면 30분을 경고 기준으로 삼을 수 있습니다. 이 수치는 보편적인 정답이 아니라 팀의 기준선과 업무 특성에 맞춰 조정해야 하는 시작값입니다.
3단계: 대시보드와 알림을 연결한다
대시보드는 다음 질문에 즉시 답할 수 있어야 합니다.
- 지금 대기 중인 요청은 몇 개인가?
- 가장 오래 기다린 요청은 어떤 에셋이며 누구의 잠금을 기다리는가?
- 지난 7일의 p50·p95 대기시간은 어떻게 변했는가?
- 에셋 유형, 파일 크기, 작업 단계 중 무엇이 대기시간과 가장 강하게 연결되는가?
- 대기 때문에 차단된 작업자와 태스크는 몇 개인가?
운영 알림은 모든 요청에 보내지 말고 행동이 필요한 상태에만 보내는 편이 좋습니다. 예를 들어 다음 조건을 사용할 수 있습니다.
- 일반 요청의 대기시간이 팀 기준선의 p95를 초과함
- 릴리스 차단 요청이 10분 이상 큐에 머무름
- 잠금 점유시간이 예상 작업시간의 2배를 초과함
- heartbeat가 15분 이상 끊겼지만 잠금이 유지되고 있음
- 동일 에셋에 대한 재요청 또는 취소가 반복됨
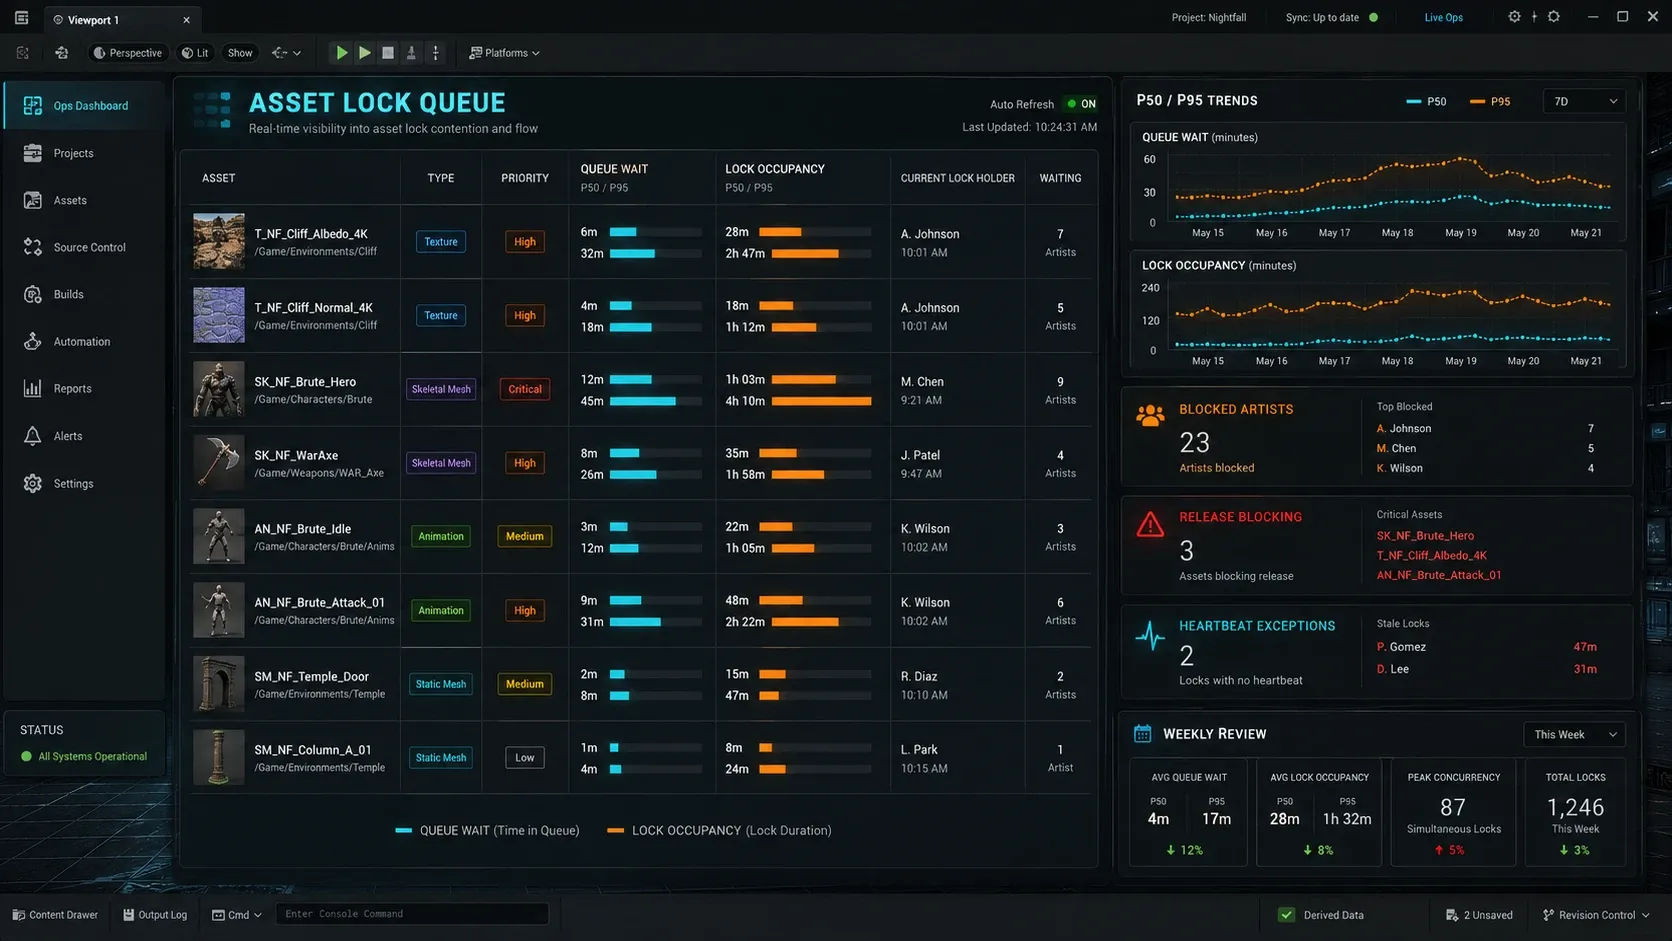
대시보드에는 현재 상태와 추세를 함께 배치하세요. 현재 큐만 보면 당장의 화재는 볼 수 있지만 병목이 개선되고 있는지는 알 수 없습니다. 반대로 추세만 보면 지금 누가 막혀 있는지 놓칠 수 있습니다.
잠금 대기시간을 어떤 지표로 분석해야 하는가?
핵심 지표는 네 그룹으로 나누면 운영하기 쉽습니다.
| 지표 그룹 | 주요 지표 | 해석 |
|---|---|---|
| 수요 | 잠금 요청 수, 시간당 요청 수 | 큐에 들어오는 작업량 |
| 대기 | 평균, p50, p90, p95 대기시간 | 아티스트가 차단된 정도 |
| 점유 | 평균·p95 점유시간, 최대 점유시간 | 잠금이 오래 유지되는 정도 |
| 영향 | 차단 작업자 수, 지연 태스크 수, 취소율 | 일정과 생산성에 미친 영향 |
분석 차원은 asset_type, asset_size_bytes, requester, current_holder, reason, task_id, 시간대입니다. 특히 파일 크기와 대기시간의 관계를 볼 때는 크기 구간을 미리 정의하는 편이 좋습니다.
| 파일 크기 구간 | 분석 질문 |
|---|---|
| 0~100MB | 일반적인 잠금 흐름에서도 대기가 발생하는가? |
| 100MB~1GB | 다운로드·임포트 시간이 큐를 늘리는가? |
| 1GB 이상 | 분할, 스트리밍, 프록시 에셋이 필요한가? |
PostgreSQL을 사용한다면 다음과 같이 에셋 유형별 p50과 p95를 계산할 수 있습니다.
SELECT
  asset_type,
  COUNT(*) AS request_count,
  PERCENTILE_CONT(0.50) WITHIN GROUP (ORDER BY wait_seconds) AS p50_wait_seconds,
  PERCENTILE_CONT(0.95) WITHIN GROUP (ORDER BY wait_seconds) AS p95_wait_seconds,
  AVG(hold_seconds) AS average_hold_seconds
FROM asset_lock_queue
WHERE requested_at >= CURRENT_TIMESTAMP - INTERVAL '14 days'
  AND granted_at IS NOT NULL
GROUP BY asset_type
ORDER BY p95_wait_seconds DESC;
분석 결과는 원인과 함께 읽어야 합니다. 예를 들어 .uasset의 p95가 높다는 사실만으로 Unreal Engine 자체를 문제로 단정할 수 없습니다. 실제 원인은 특정 월드 파티션 파일의 과도한 크기, 한 명에게 집중된 리뷰 권한, 긴 임포트 시간일 수 있습니다.
팀 운영에서 큐를 어떻게 사용할까?
에셋을 오래 잠그지 않도록 작업 범위를 쪼갠다
잠금 점유시간이 길면 에셋을 기능 단위로 나눌 수 있는지 먼저 검토합니다. 캐릭터 전체 파일을 한 번에 잠그는 대신 메시, 머티리얼, 애니메이션, 설정 데이터의 소유권을 분리하면 병렬 작업이 가능해집니다. 엔진이 바이너리 저장을 요구하더라도 원본 제작 파일과 런타임용 산출물을 분리하는 방식으로 충돌 범위를 줄일 수 있습니다.
단, 분할 비용이 큰 에셋을 무조건 쪼개면 참조 관리와 빌드 시간이 늘어날 수 있습니다. 큐 데이터에서 점유시간 감소량과 분할로 생긴 유지보수 비용을 함께 비교해야 합니다.
큐를 작업자 평가 지표로 사용하지 않는다
잠금 대기시간은 시스템과 작업 흐름을 개선하기 위한 지표이지 개인의 성과 점수가 아닙니다. 특정 작업자의 점유시간이 길더라도 복잡한 리깅이나 대형 월드 편집을 담당하고 있을 수 있습니다. 개인별 수치는 원인 확인과 지원 배치에 사용하고 공개 대시보드에서는 팀·에셋 유형·태스크 단위로 집계하는 것이 안전합니다.
예외 처리에는 종료 조건을 둔다
긴급 요청은 일정 보호에 필요하지만 예외가 누적되면 큐의 신뢰도가 떨어집니다. 긴급 요청마다 다음 정보를 남기세요.
- 긴급 사유와 차단되는 마일스톤
- 승인자와 요청 만료 시각
- 선점으로 영향을 받는 요청
- 작업 완료 후 원래 큐로 복귀할지 여부
이 기록은 나중에 긴급 요청이 왜 반복되는지 확인하는 회고 자료가 됩니다.
주간 회고에서 무엇을 결정해야 하는가?
주간 회고는 숫자를 읽는 자리보다 운영 규칙을 바꾸는 자리여야 합니다. 다음 순서로 진행하면 논의가 구체적입니다.
- 지난주 p95 대기시간과 최대 점유시간을 에셋 유형별로 확인합니다.
- 대기시간이 긴 상위 5개 에셋의 원인을 분류합니다.
- 원인이 소유권, 파일 크기, 승인, 검수, 도구 오류 중 어디에 해당하는지 결정합니다.
- 다음 주에 적용할 변경을 한두 개만 선택합니다.
- 담당자, 완료일, 성공 기준을 태스크로 등록합니다.
성공 기준은 “협업을 개선한다”처럼 추상적으로 쓰지 말고 “캐릭터 에셋의 일반 요청 p95 대기시간을 25분에서 15분 이하로 낮춘다”처럼 측정 가능하게 작성해야 합니다. 데이터가 충분하지 않다면 먼저 이벤트 누락률과 분류 정확도를 개선하는 것을 목표로 삼을 수 있습니다.
자주 묻는 질문(FAQ)
잠금 대기시간의 목표값은 몇 분이어야 하나?
팀마다 다릅니다. 최근 2~4주의 일반 요청 p50·p95를 기준선으로 삼고 릴리스 차단 요청에는 별도의 더 짧은 SLA를 정하세요. 절대값보다 기준선 대비 변화와 차단 작업자 수를 함께 보는 것이 중요합니다.
파일이 크면 항상 큐 병목이 발생하는가?
아닙니다. 파일 크기는 다운로드, 임포트, 검수 시간을 늘릴 수 있지만 병목은 공유 빈도와 잠금 점유시간에도 좌우됩니다. 파일 크기 구간별 대기시간과 점유시간을 분리해 확인해야 합니다.
오래된 잠금을 자동으로 해제해도 되는가?
바로 해제하면 안 됩니다. heartbeat, 마지막 저장 시각, 프로세스 상태, 담당자 확인을 검증한 뒤 유예시간을 적용하세요. 자동 해제는 데이터 손상 위험이 있으므로 복구 가능한 백업과 명확한 감사 로그가 필요합니다.
정리
Asset Lock Queue는 단순한 대기열이 아니라 대용량 바이너리 에셋을 중심으로 협업 병목을 관찰하는 운영 장치입니다. requested_at부터 granted_at까지의 대기시간과 granted_at부터 released_at까지의 점유시간을 분리하면 아티스트가 막힌 이유를 일정, 소유권, 파일 구조, 도구 성능의 문제로 나눌 수 있습니다.
먼저 이벤트를 정확히 수집하고 p50·p95 대기시간을 기준선으로 만든 뒤 우선순위, 오래된 잠금 알림, 주간 회고를 연결하세요. 측정 결과가 에셋 분할이나 작업 범위 축소 같은 구체적인 변경으로 이어질 때 Asset Lock Queue는 기록 도구를 넘어 팀의 생산성을 개선하는 의사결정 시스템이 됩니다.