AI 맞춤형 스킬 추천 시스템: 플레이어 조작 스타일을 분석하는 게임 디자인
플레이어의 입력 습관과 전투 성과를 분석해 스킬을 추천하는 시스템을 설계한다. 관측 지표, 점수식, 탐색 규칙, UX와 밸런싱 안전장치까지 실무 기준으로 정리한다.
핵심 요약
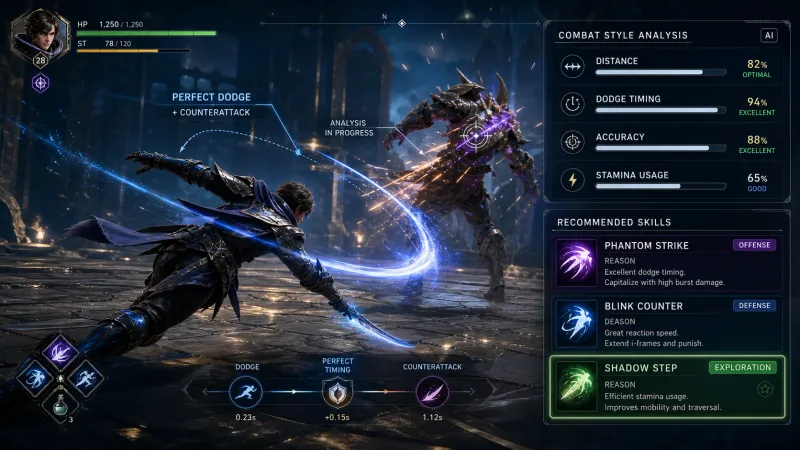
플레이어 조작 스타일 기반 AI 스킬 추천은 입력 빈도만으로 취향을 추정하는 기능이 아니다. 전투 로그에서 선호 거리, 회피 타이밍, 자원 관리, 명중률, 생존 기여도를 함께 측정하고 현재 해금된 스킬 가운데 플레이어의 강점은 강화하되 약점을 보완할 수 있는 후보를 점수화해야 한다.
핵심은 추천 정확도보다 플레이어의 선택권이다. 추천은 자동 장착하지 않고 이유와 대안을 보여주며 메타를 고착시키지 않도록 탐색 추천과 밸런싱 제한을 둔다.
플레이어 조작 스타일 분석 기반 추천이 필요한 이유
스킬트리가 복잡한 액션 RPG, 로그라이크, MOBA에서는 신규 플레이어가 자신의 플레이 방식에 맞는 선택지를 찾기 어렵다. 단순 인기 순위는 전체 평균에 강한 빌드를 반복 노출하고 숙련도나 선호가 다른 플레이어에게는 오히려 이탈 요인이 된다.
예를 들어 근접 전투 비중이 낮고 적의 공격 직전 회피에 성공하는 플레이어에게 무조건 최고 승률의 근접 콤보를 권하면 추천의 설득력이 떨어진다. 반대로 회피 직후 반격을 자주 성공시키는 기록을 근거로 완벽 회피 후 치명타 피해 증가 스킬을 제안하면 플레이어는 자신의 행동이 게임에 반영된다고 느낀다.
어떤 플레이 데이터를 수집해야 할까?
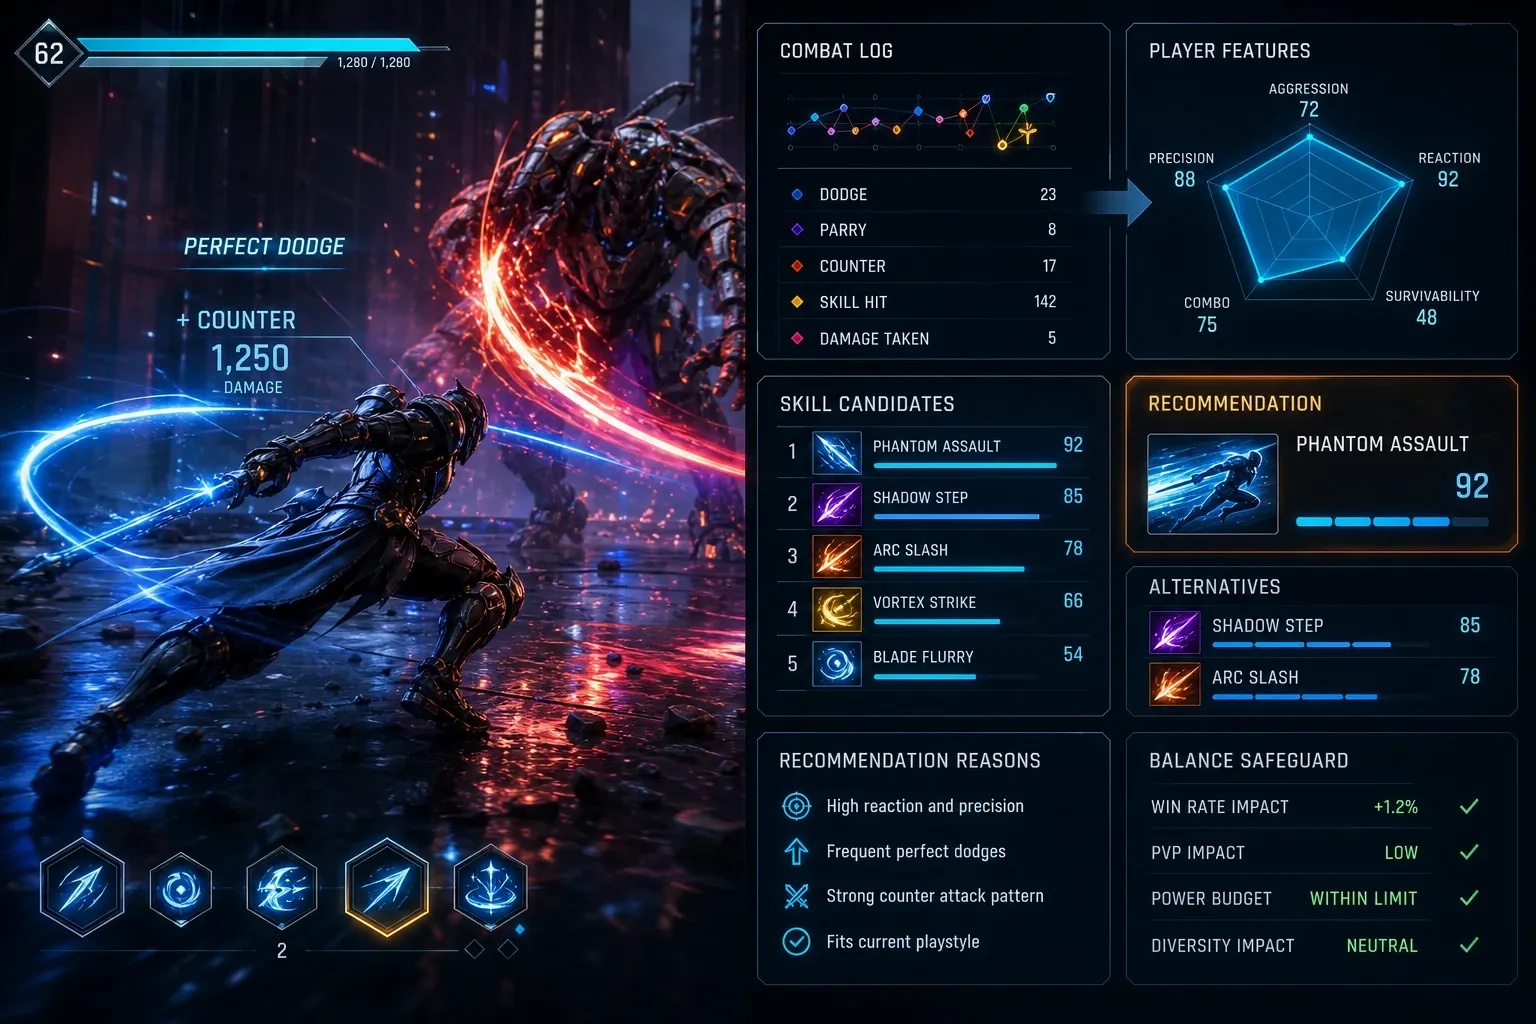
추천 모델에는 개인을 식별하는 정보보다 세션 단위의 게임플레이 이벤트가 중요하다. 서버 권한 전투 로그를 기준으로 수집하면 클라이언트 조작 변조나 누락의 영향을 줄일 수 있다.
| 분석 축 | 대표 이벤트와 지표 | 추천에 쓰는 해석 |
|---|---|---|
| 전투 거리 | 적과의 평균 거리, 근접 공격 비율, 원거리 명중률 | 근접형·원거리형·혼합형 성향 |
| 방어 행동 | 회피 시도 수, 완벽 회피율, 가드 성공률 | 반응형 방어와 안정형 방어 성향 |
| 공격 리듬 | 연계 성공률, 차지 취소 빈도, 스킬 사이 공백 | 콤보형·단발형·즉응형 성향 |
| 자원 관리 | 마나·스태미나 과소진 횟수, 회복 아이템 사용 시점 | 고비용 스킬 수용 가능성 |
| 전투 성과 | 처치 시간, 피격량, 사망, 기여도 | 추천 효과의 검증 지표 |
| 선택 이력 | 추천 노출, 클릭, 장착, 재장착, 해제 | 추천 수용도와 피로도 |
입력 로그만으로 판단하면 왜 위험한가?
입력 횟수는 공격적인 플레이를 뜻하지 않는다. 난이도가 높아 회피를 반복한 결과일 수 있고 네트워크 지연이나 조작 환경 차이도 포함된다. 따라서 행동은 최소한 상황-입력-결과 묶음으로 해석한다.
예를 들어 회피 입력 하나가 아니라 위험 공격 감지 후 300ms 이내 회피 → 무피격 성공 → 2초 이내 반격 성공을 하나의 완벽 회피 기회로 기록한다. 이렇게 해야 단순 버튼 연타와 의도적인 반응 행동을 구분할 수 있다.
플레이어 조작 스타일 점수는 어떻게 계산할까?
처음부터 복잡한 머신러닝 모델을 도입할 필요는 없다. 라이브 초반에는 설명 가능하고 밸런싱하기 쉬운 가중치 점수 모델이 적합하다. 최근 20전 또는 최근 60분처럼 고정된 관측 창을 사용하고 전투 길이가 짧은 세션은 최소 이벤트 수를 충족할 때만 반영한다.
각 특징은 0에서 1 범위로 정규화한다. 예를 들어 회피 특화 점수는 다음처럼 계산할 수 있다.
여기서 PerfectDodgeRate는 완벽 회피 성공 횟수 ÷ 완벽 회피 기회 수다. 기회 수가 너무 적을 때 우연한 성공률이 과대평가되지 않도록 베이지안 평활화를 적용한다.
5는 사전 표본 강도다. 실제 서비스에서는 모드별 평균 표본 수와 분산을 보고 조정한다.
이 식은 사전분포의 평균을 GlobalRate, 유효 표본 수를 5로 둔 Beta 사전분포의 사후 평균 예시다. 여기서 5는 보편적인 기본값이 아니라 조정 가능한 설계 파라미터다.
추천 후보 점수식
스킬별 추천 점수는 조작 성향 적합도, 성과 개선 가능성, 콘텐츠 맥락, 피로도 패널티를 합쳐 계산한다.
| 항목 | 의미 | 설계 주의점 |
|---|---|---|
F_style | 플레이어 성향과 스킬 메커니즘의 적합도 | 인기나 승률과 혼동하지 않는다 |
F_context | 현재 무기, 파티 구성, 보스 속성, 콘텐츠 규칙 | 모드가 바뀌면 재계산한다 |
F_improvement | 자주 실패하는 구간을 보완할 가능성 | 약점 보완이 플레이 스타일 강요가 되지 않게 한다 |
F_novelty | 아직 써 보지 않은 유효 후보 보너스 | 탐색 슬롯에만 제한적으로 사용한다 |
P_fatigue | 최근 반복 노출, 거절, 해제에 따른 감점 | 같은 제안을 연속 노출하지 않는다 |
AI 스킬 추천 시스템을 어떻게 구현할까?
1. 스킬 메커니즘에 태그를 붙인다
모든 스킬에 사람이 검수 가능한 설계 태그를 정의한다. 예를 들어 perfect_dodge, counter_attack, close_range, stamina_refund, team_shield 같은 태그다. 이 태그는 추천뿐 아니라 툴팁 검색, 밸런스 대시보드, 튜토리얼 분기에도 재사용할 수 있다.
{
  "skillId": "counterstep",
  "tags": ["perfect_dodge", "counter_attack", "close_range"],
  "cost": { "stamina": 20 },
  "cooldownSeconds": 8,
  "unlockCondition": "chapter_3"
}
태그는 너무 세분화하면 운영 비용이 커진다. 처음에는 스킬 수보다 적은 20~40개 정도의 안정적인 메커니즘 태그로 시작하는 편이 낫다.
2. 세션 로그에서 플레이어 특징 벡터를 만든다
플레이어의 최근 전투 기록을 PlayerStyleVector로 집계한다. 역할이 다른 게임 모드는 별도 벡터로 분리한다. PvE 보스전에서의 회피 숙련도를 PvP 난전 추천에 그대로 쓰면 맥락이 섞인다.
const playerStyle = {
  closeRange: 0.22,
  rangedAccuracy: 0.74,
  perfectDodge: 0.68,
  dodgeCounter: 0.61,
  staminaDiscipline: 0.80,
  teamProtection: 0.18
};
3. 후보를 필터링하고 상위 3개를 제시한다
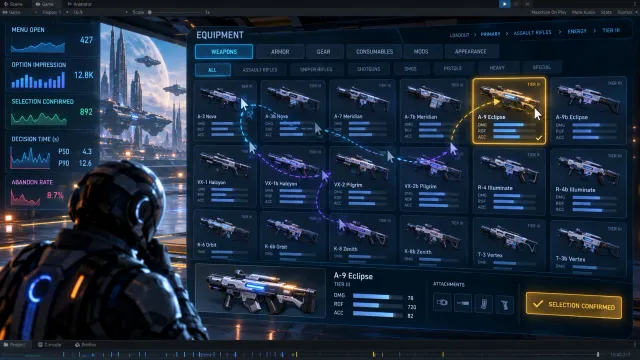
해금 조건, 장착 슬롯, 현재 콘텐츠에서 비활성인 효과를 먼저 제외한다. 그다음 점수 상위 2개와 탐색용 1개를 보여준다. 탐색용 후보는 점수가 약간 낮아도 새로운 전략을 경험하게 하는 슬롯이며 전투력 격차가 큰 스킬을 억지로 추천하는 용도가 아니다.
flowchart LR
  A[전투 이벤트 로그] --> B[플레이 스타일 벡터]
  B --> C[해금·슬롯·콘텐츠 필터]
  C --> D[적합도 점수 계산]
  D --> E[상위 2개 + 탐색 1개]
  E --> F[노출·장착·성과 로그]
  F --> B
추천 결과에는 반드시 한 줄 근거를 붙인다. 예를 들어 최근 보스전에서 완벽 회피 후 반격 성공률이 높아 추천합니다.처럼 관측된 행동을 말한다. “AI가 분석했습니다”는 이유가 아니다.
추천 UX는 플레이어의 선택권을 어떻게 지킬까?
추천 UI는 빌드 강요 화면이 아니라 의사결정 보조 도구여야 한다.
- 추천 이유: 관측한 행동 하나와 연결한다.
- 기대 효과: 피해량 같은 단일 수치보다 플레이 변화로 설명한다. 예:
회피 후 반격 시간을 늘립니다. - 비교 대상: 현재 장착 스킬과 쿨다운, 비용, 발동 조건을 나란히 보여준다.
- 거절 제어:
관심 없음,이 유형 추천 줄이기를 제공한다. - 노출 빈도: 레벨업, 반복 실패, 콘텐츠 진입처럼 의미 있는 순간에만 노출한다.
자동 장착은 피한다. 특히 경쟁 모드에서는 추천이 메타를 사실상 강제하거나 플레이어가 변경 사실을 놓쳐 패배 원인을 오해하게 만들 수 있다.
밸런싱과 경제를 망치지 않는 안전장치
개인화 추천은 특정 스킬의 채택률을 올린다. 이것은 해당 스킬이 강해서일 수도 있지만 추천 노출이 만든 순환 효과일 수도 있다. 따라서 스킬 성능 지표와 추천 노출 지표를 분리해서 본다.
| 확인 지표 | 경고 신호 | 대응 |
|---|---|---|
| 추천 후 장착률 | 특정 스킬만 과도하게 상승 | 추천 점수 상한과 노출 쿼터 적용 |
| 장착 후 승률 | 추천군만 비정상적으로 우세 | 스킬 성능과 매치메이킹을 별도 분석 |
| 재장착 유지율 | 시험 장착 뒤 즉시 해제 | 추천 근거 또는 스킬 난이도 조정 |
| 스킬별 노출 점유율 | 상위 스킬이 추천을 독점 | 유사 효용 후보 간 다양성 제약 적용 |
| 유료 스킬 전환율 | 결제 유도처럼 보이는 편향 | 유료 여부를 점수식에서 분리하고 감사 |
특히 유료 스킬이나 재화 소모형 해금 요소는 추천 점수와 구매 전환율을 직접 최적화하면 안 된다. 추천 시스템의 목표는 구매가 아니라 플레이 만족도와 선택 품질이어야 한다. 구매 안내는 추천과 화면 및 분석 지표를 분리하는 것이 안전하다.
자주 묻는 질문 (FAQ)
추천 시스템에 머신러닝이 반드시 필요한가?
아니다. 스킬 태그와 가중치 기반 점수식으로 시작해도 충분하다. 추천 로그가 쌓이고 운영자가 설명 가능한 기준의 한계를 확인한 뒤 학습 모델을 검토하면 된다.
초보자와 숙련자에게 같은 추천 규칙을 적용해도 되는가?
안 된다. 초보자는 조작 난이도와 생존 안정성의 비중을 높이고 숙련자는 콤보 확장과 콘텐츠별 최적화 비중을 높이는 편이 좋다. 계정 레벨만이 아니라 실제 행동 데이터의 신뢰도도 함께 고려한다.
추천 성능은 무엇으로 평가해야 하는가?
클릭률 하나로 평가하면 안 된다. 장착 후 유지율, 전투 성과 변화, 반복 실패 감소, 추천 거절률, 플레이 세션 유지 같은 지표를 함께 본다.
마무리
좋은 AI 스킬 추천은 플레이어를 평균적인 강한 빌드로 몰아넣지 않는다. 플레이어가 이미 재미를 느끼는 조작을 읽고 그 선택을 더 잘 이해하고 확장하도록 돕는다.
처음에는 설명 가능한 태그, 최근 전투 로그, 단순 점수식, 상위 3개 추천으로 시작하자. 추천 노출과 실제 성과를 분리해 관찰하면 모델을 복잡하게 만들기 전에 어떤 설계 문제가 남아 있는지 확인할 수 있다.